


Timescale Vector与LlamaIndex:让PostgreSQL成为更好的AI应用向量数据库
内容提要
Timescale Vector集成了LlamaIndex,利用PostgreSQL作为向量数据库,提供快速的相似性搜索和高效的时间过滤。它支持多种索引算法,简化AI应用基础设施,允许开发者在一个数据库中管理向量、关系和时间序列数据。通过时间分区,Timescale Vector优化了基于时间的搜索,提升了查询效率,适用于需要时间上下文的检索增强生成(RAG)应用。
延伸解读
时间过滤如何提升RAG效果
文章指出,时间元数据常被忽视,但能显著提升检索质量。Timescale Vector利用自动时间分区,让相似性搜索可限定在特定时间范围内,例如查找最近新闻或回答“2023年1月至3月新增了哪些功能”。这种基于时间的上下文检索,使RAG应用能生成更贴合时间背景的答案,尤其适合聊天历史、文档更新等场景。
索引选择与性能权衡
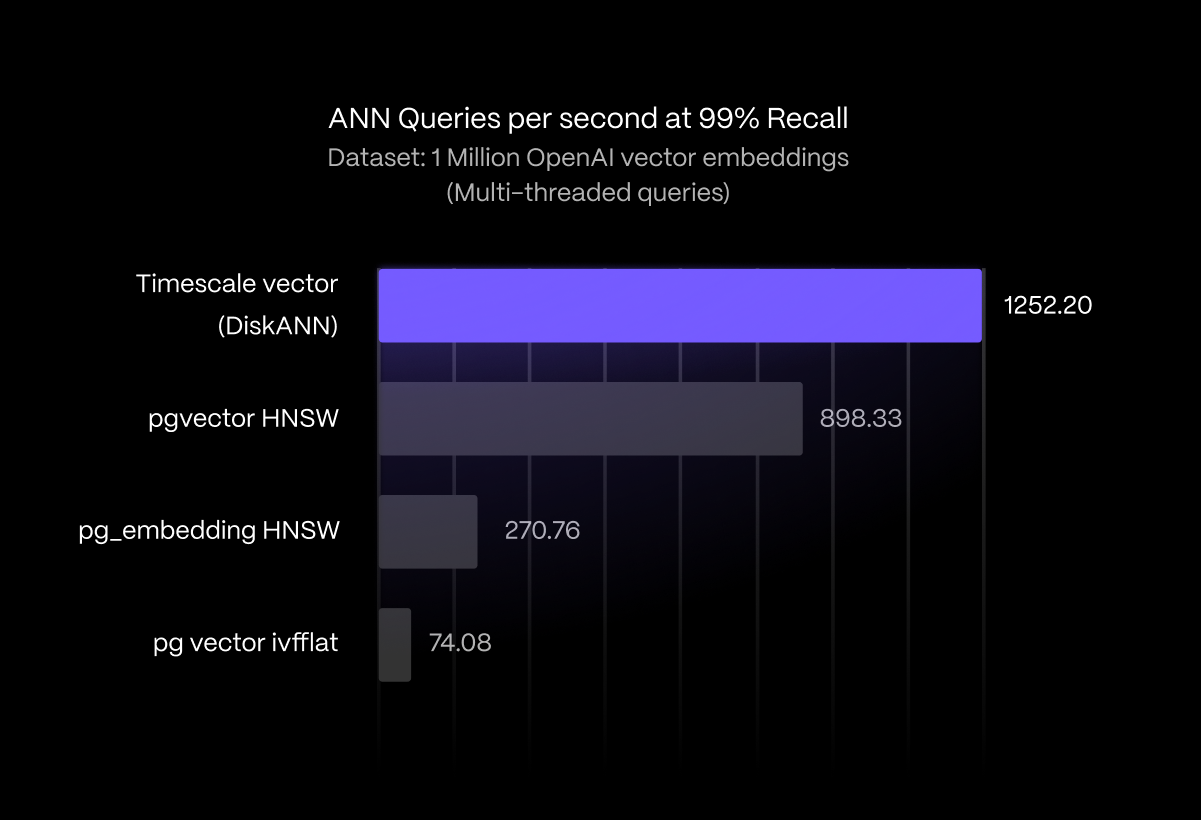
Timescale Vector提供DiskANN、HNSW和IVFFlat三种索引。DiskANN在百万级OpenAI嵌入数据集上实现约99%召回率,搜索速度比现有PostgreSQL索引快39%至1590%,并支持产品量化节省10倍索引空间。HNSW和IVFFlat则继承自pgvector,适合不同场景。开发者可根据数据规模和查询模式灵活选择,无需绑定单一算法。
时间分区参数设置建议
使用时间分区时,需指定time_partition_interval参数。文章建议,常见查询应只触及少数分区,同时整个数据集最好控制在1000个分区以内。例如,频繁查询近期向量可设较小间隔(如1天),而查询跨度长达十年则可设较大间隔(如6个月)。系统对该值不敏感,但合理设置能优化查询效率。
简化AI基础设施的实践价值
Timescale Vector将向量、关系和时间序列数据统一在PostgreSQL中,消除了管理多数据库系统的运维复杂性。开发者可直接用PostgreSQL数据类型存储和过滤元数据,并将向量搜索结果与关系数据JOIN,获得更相关的响应。这降低了AI应用的基础设施门槛,尤其适合需要快速迭代的生产环境。
Q&A
Timescale Vector如何提升PostgreSQL的向量搜索性能?
Timescale Vector通过引入基于DiskANN算法的新搜索索引,实现了3倍的搜索速度和约99%的召回率,优化了向量搜索性能。
Timescale Vector支持哪些类型的数据?
Timescale Vector支持向量嵌入、关系数据和时间序列数据,允许在一个PostgreSQL数据库中管理这些数据。
如何在Timescale Vector中进行时间范围的向量搜索?
可以通过自动时间分区和索引,利用时间过滤条件来限制向量搜索的时间范围,快速找到相关的嵌入。
Timescale Vector的定价和支持服务如何?
Timescale Vector提供灵活的定价、企业级安全性和免费的专家支持,适合生产环境使用。
开发者如何利用Timescale Vector简化AI应用的基础设施?
开发者可以将向量、关系和时间序列数据结合在一个PostgreSQL数据库中,减少管理多个数据库系统的复杂性。
Timescale Vector如何支持检索增强生成(RAG)应用?
Timescale Vector通过时间上下文检索,优化了基于时间的语义搜索,提升了RAG应用的响应相关性。
