

Pi、rpi、Pi-Bolt 测试:rpi 在启动、内存与读取上全面领先
内容提要
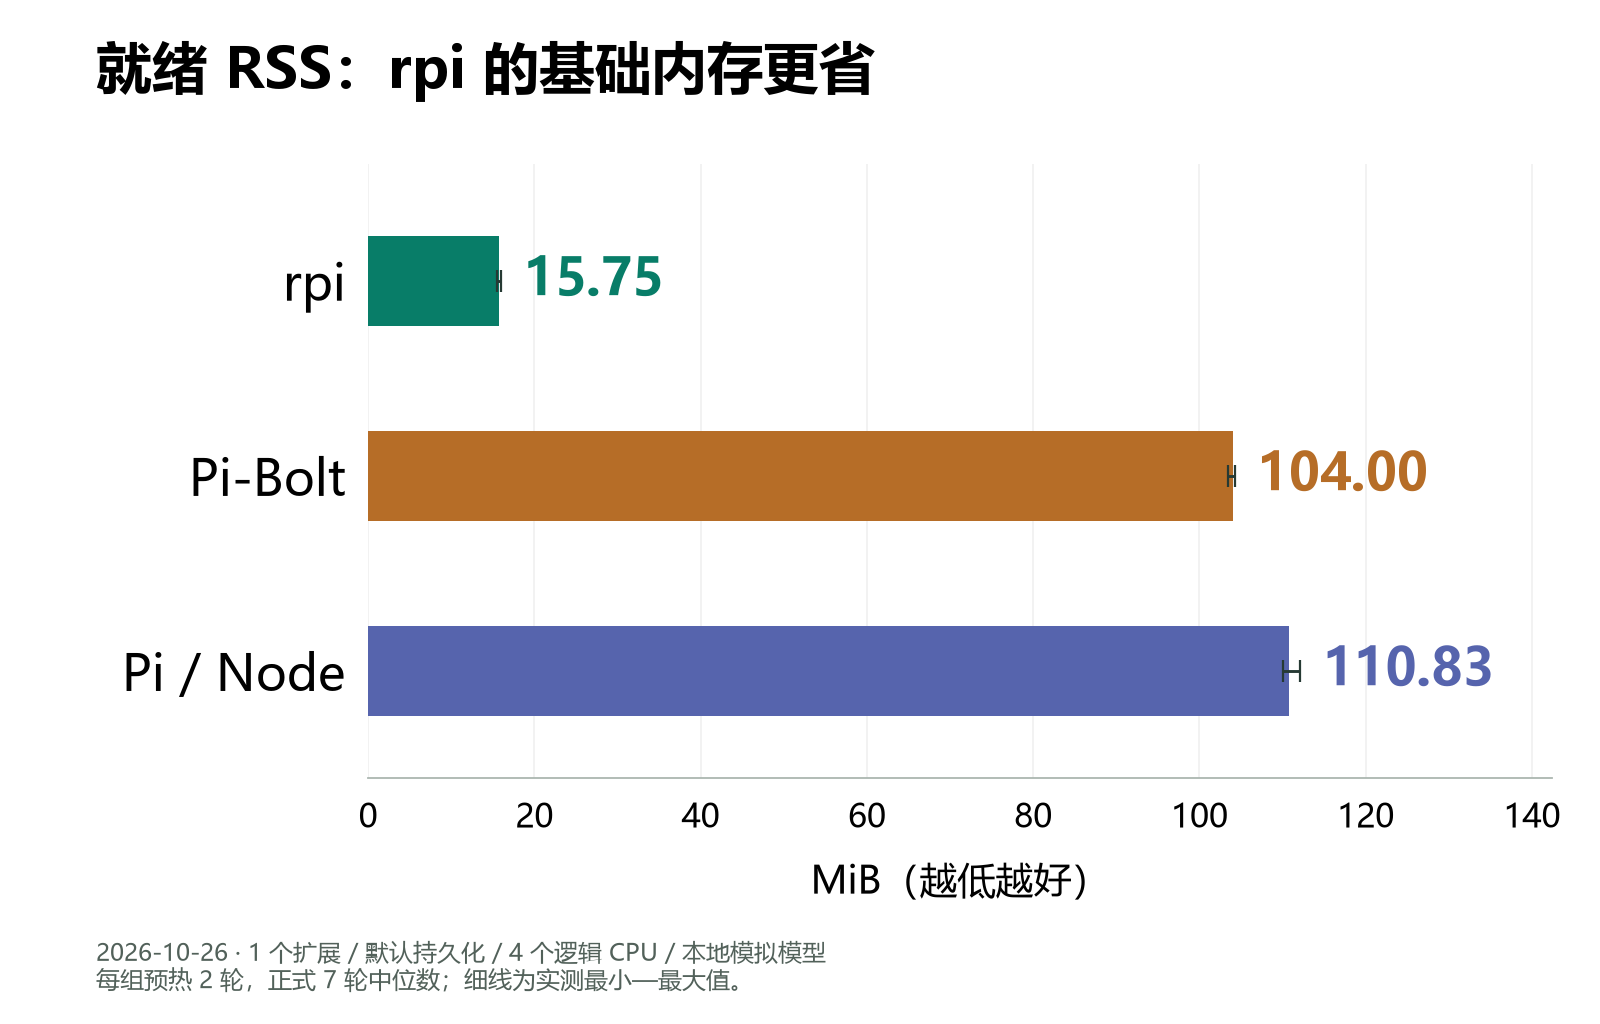
文章比较了rpi、Pi-Bolt与Pi三项Agent的自身开销。在同一机器、功能对齐扩展、默认会话持久化、七轮取中位数的条件下,rpi的RPC就绪耗时6.76毫秒、就绪RSS 15.75 MiB、100次文件读取循环123.11毫秒,三项均优于另两者:相比Pi分别少约96.6%、85.8%、59.3%,相比Pi-Bolt分别少约84.8%、84.9%、25.6%。测试使用本地模拟模型,不含真实推理与终端渲染。
延伸解读
三项指标各有所指,不宜合并为单一分数
文章明确区分了RPC就绪耗时、就绪RSS和100次读取循环三项指标:前者反映新进程启动到能回复状态的速度,RSS是静置后的常驻内存,读取循环则包含工具执行、上下文处理、会话记录与结算的完整耗时。三者回答不同问题,不能相加成“性能分”。读者在参考这些数字时,应根据自身场景关注对应指标,而非简单比较综合优劣。
测试条件限定了结论的适用范围
所有数据来自同一台Ryzen 9 7950X、Ubuntu 24.04/WSL2机器,Agent固定四个逻辑CPU,各自加载功能相同的轻量echo扩展并开启默认会话持久化,每组预热两次、正式测量七次取中位数。这意味着结果反映的是该硬件与配置下的自身开销,换到不同机器、扩展或会话设置时,相对差距可能变化,不宜直接外推为普遍结论。
本地模拟模型意味着未覆盖真实推理负载
本轮测试使用本地模拟模型,真实模型推理、编码任务质量和交互终端渲染均不在范围内。因此,rpi在启动、内存和读取上的领先,仅代表Agent自身开销较低,并不说明其在真实任务中的响应速度或输出质量更优。若关注端到端体验,还需结合真实模型调用和终端交互另行评估。
读取优势在持久化开启下仍成立
三者都实际读取同一个208字节文件100次,由本地模拟模型逐次发起调用并校验结果,共101次模型请求,计时到完整结算而非提前截在输出结束。rpi用时123.11毫秒,比Pi-Bolt少约四分之一,比Pi少约六成。这说明在保留会话持久化的前提下,rpi的读取循环开销仍明显更低,对频繁文件读取类工作流有参考价值。
Q&A
rpi、Pi-Bolt 和 Pi 在启动速度上分别需要多少毫秒?
rpi 的 RPC 就绪耗时为 6.76 毫秒,Pi-Bolt 为 44.40 毫秒,Pi 为 199.31 毫秒。
rpi 在内存占用上比 Pi 和 Pi-Bolt 节省多少?
rpi 的就绪 RSS 为 15.75 MiB,相比 Pi 的 110.83 MiB 少约 85.8%,相比 Pi-Bolt 的 104.00 MiB 少约 84.9%。
在文件读取循环测试中,rpi 比 Pi 快多少?
rpi 完成 100 次文件读取循环耗时 123.11 毫秒,Pi 耗时 302.27 毫秒,rpi 少用约 59.3% 的时间。
这次性能测试的环境和条件是什么?
测试在 Ryzen 9 7950X、Ubuntu 24.04 / WSL2 机器上进行,Agent 固定四个逻辑 CPU,各自加载功能相同的轻量 echo 扩展,开启默认会话持久化,每组预热两次、正式测量七次,交错运行,取七轮中位数。
测试是否包含了真实模型推理和终端渲染?
不包含。测试使用本地模拟模型,真实模型推理、编码任务质量和交互终端渲染不在本轮测试范围内。
rpi 相比 Pi-Bolt 在启动、内存和读取上分别领先多少?
rpi 相比 Pi-Bolt,启动耗时少约 84.8%,就绪内存少约 84.9%,读取循环耗时少约 25.6%。
