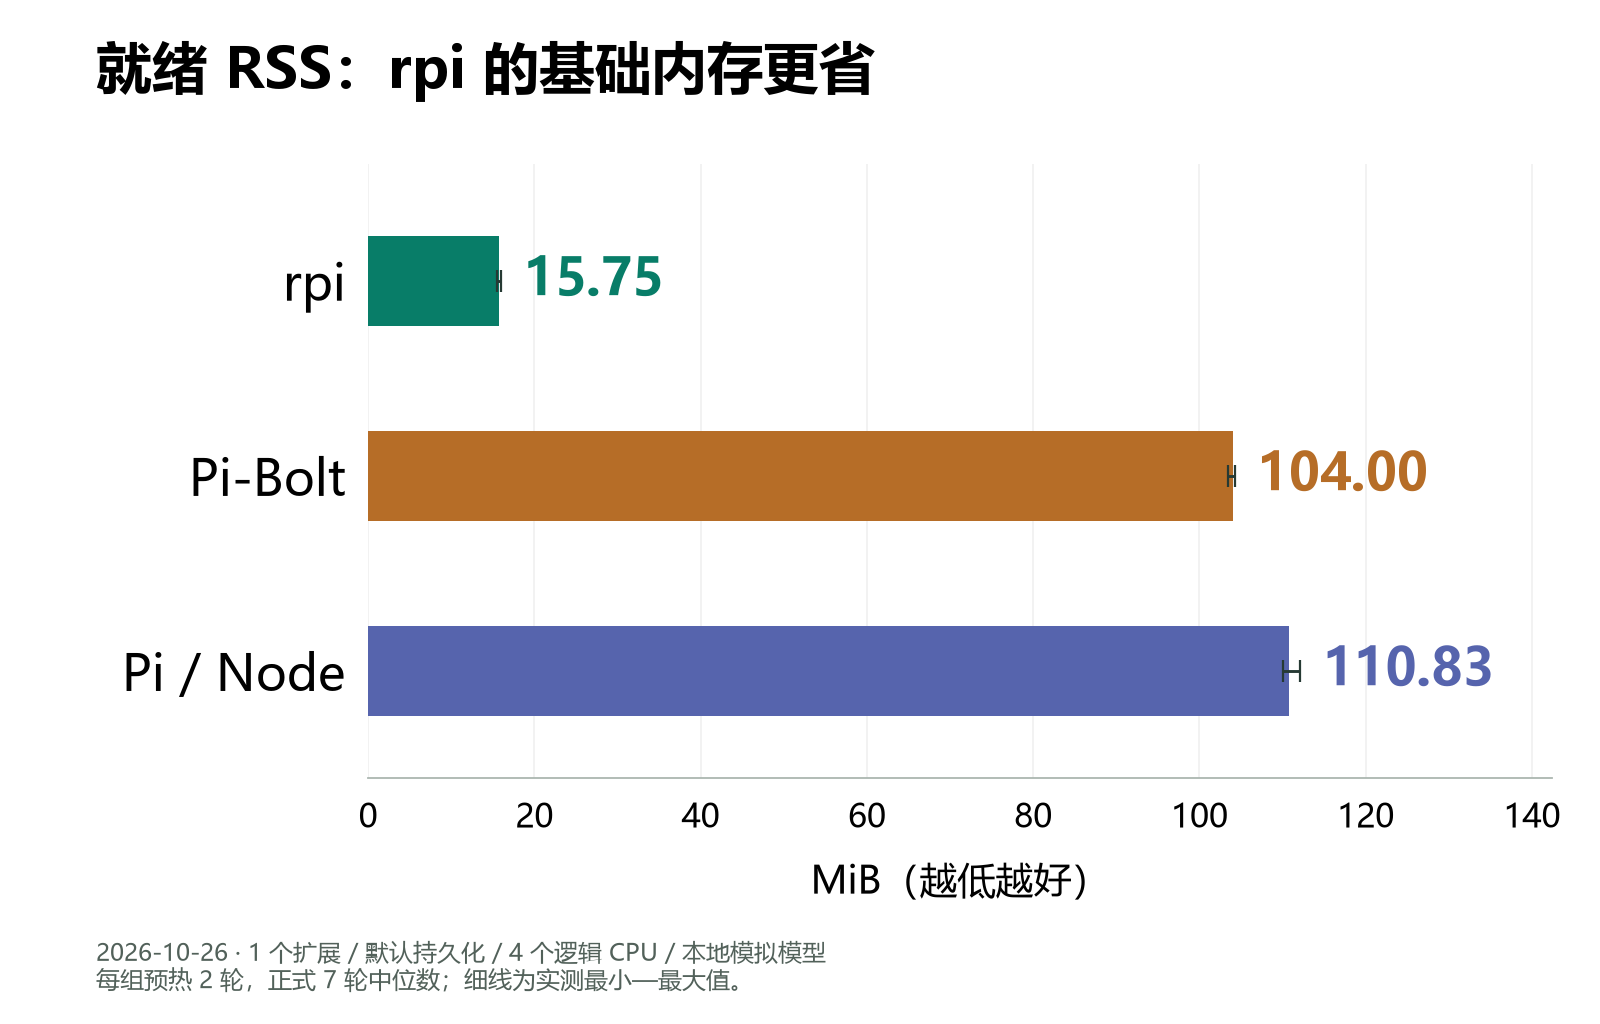
文章比较了rpi、Pi-Bolt与Pi三项Agent的自身开销。在同一机器、功能对齐扩展、默认会话持久化、七轮取中位数的条件下,rpi的RPC就绪耗时6.76毫秒、就绪RSS 15.75 MiB、100次文件读取循环123.11毫秒,三项均优于另两者:相比Pi分别少约96.6%、85.8%、59.3%,相比Pi-Bolt分别少约84.8%、84.9%、25.6%。测试使用本地模拟模型,不含真实推理与终端渲染。
OpenAI发布GPT-6.1 Sol,宣称以Astra五分之一的价格提供接近其智能水平。作者通过三项测试对比,发现GPT-6.1 Sol准确率与Astra持平,速度更快,总成本仅为Astra的18%,验证了OpenAI的定价与性能主张。
本期《蠎周刊》汇总Python生态动态:Python文档新增波斯语版本;Cory Doctorow批评“Hugging Face”攻击只是Python循环加聊天机器人;PHP 8.5、Node.js、Go与Python在真实数据库负载下的I/O性能对比显示PHP+Swoole最高。项目推荐包括本地AI鸟类检测、CubePlex代理平台、Tel-Agent手机助手、Soup微调工具。文末介绍译者大妈多年翻译周刊的经历与联系方式。
rpi 是 TypeScript 版 pi 的 Rust 移植。作者在同一台 Windows 机器上,以相同 JSONL 命令通道、冷启动、离线、中性目录等条件对比两者:rpi 启动约 17.5 毫秒,pi 约 169.5 毫秒,快约 10 倍;常驻内存 12MiB 对 91.5MiB;安装体积约 21.8MiB 对 385MiB 加 Node。rpi 为 Rust 原生开发,借鉴 Pi 思想并做优化,欢迎 PR。
作者用Rust重写交叉编码器推理库cross-encode-rs,并与Python的fastembed和sentence-transformers对比。三者底层均使用onnxruntime,小模型上性能接近,Rust仅快约1.1倍;大模型上Rust快约1.4倍,模型加载时间相当。结论是底层运行时比编程语言更重要,但Rust在部署和并发控制上仍有优势。
本文介绍ABACUS第一性原理计算软件GPU版本的编译方法。文章对比平面波与数值原子轨道基组,指出GPU可加速电子步等耗时计算。详细说明使用conda配置CUDA 12.2环境、安装依赖库、编译ELPA及ABACUS的步骤,并通过BaTiO3示例验证GPU版本比CPU快1.60倍,且数值精度几乎一致。
Anthropic发布Claude Fable 5.1,宣称在编码和知识工作上有重大进步,基准测试得分翻倍。但作者用四个真实任务测试新旧模型,发现两者准确率均为满分,仅在速度和成本上略有差异。在复杂任务中,旧模型甚至更快更便宜。作者认为,对日常任务升级意义不大,改进可能仅体现在长时研究型任务上。
GLM-5.3-Flash是Z.AI推出的低成本模型,价格约为旗舰版GLM-5.3的1/16。测试显示两者在编码、逻辑和提取任务中均得满分,准确性无差异,但Flash在困难任务中消耗更多token和时间,其成本优势依赖当前定价,可能变化。建议Flash适合简单任务,复杂任务需权衡时间与成本。
智谱发布开源模型GLM-5.3-Flash,匿名测试版Ox Alpha性能宣称追平Claude Opus 4.8,价格仅四十分之一,并跑在10万张国产芯片上。但实际使用中性能参差,价格含促销折扣,芯片效率“相当”而非超越,API条款严苛。开发者评价分化,建议用户实测、算清成本、关注生态。
TensorSharp 纯 .NET 推理引擎于8月19日支持GLM-5.2,在3×RTX PRO 6000上长prompt prefill比llama.cpp快约1.5倍,decode快4%。GLM-5.3同基座、后训练提升,预计8月28日开源,现有支持可无缝承接。此进展将前沿模型私有化部署降至工作站级别,.NET推理栈成可用选项。
在2M行PostgreSQL 17上,覆盖索引比单列索引写入慢28%(INSERT)和25%(UPDATE),但读取快1.26倍。当写入低于每分钟约4300次时,覆盖索引更划算;否则单列索引更优。存储占用112MB对18MB。建议先设置random_page_cost=1.1,默认用单列索引,仅在需要时添加覆盖索引。
AMD MI355X在运行Kimi K3模型时,凭借更低价格和更高每美元吞吐量,性能超越英伟达B300。通过修复投机解码和预填充内核的软件缺陷,MI355X单节点速度达到B200的3.8倍,首字延迟大幅降低。文章认为,CUDA生态并非不可撼动,硬件性价比和工程师修bug能力正成为新护城河。
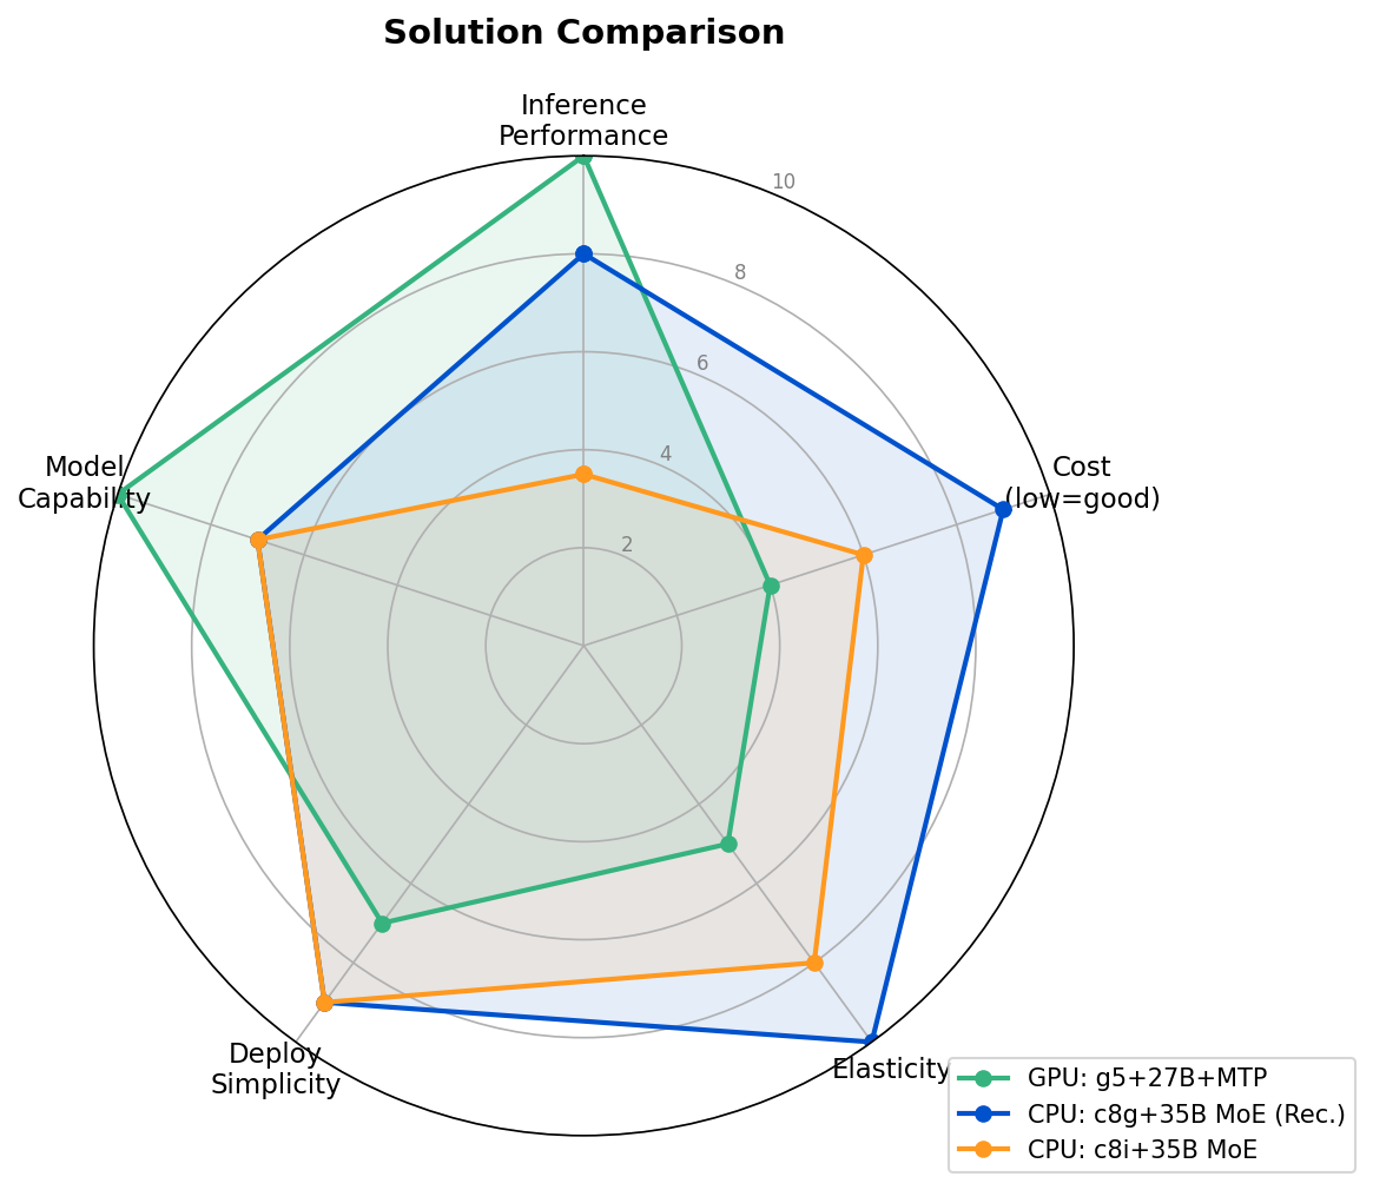
本文在AWS中国区实测llama.cpp部署Qwen3.6模型,对比Graviton4、Intel CPU和A10G GPU的MTP加速效果。GPU上MTP提升83%性能,CPU上反而降低18-40%。最佳实践:GPU用27B Dense+MTP,CPU用35B MoE关闭MTP,后者成本仅为GPU的26%,性能达82%。
国产大模型密集发布,Kimi K3与Qwen3.8-Max预览版相继亮相。实测Qwen3.8-Max在网页生成和3D游戏开发上速度飞快,但效果不稳定,复杂任务表现粗糙。国产开源模型数量已超美国,性能逼近闭源模型,差距缩小,未来竞争焦点或转向价格。
本文探讨了将O_DIRECT与io_uring组合使用的技术路径,旨在解决数据库和块存储引擎中的双重缓冲与系统调用开销问题。文章详细分析了组合使用的决策边界、O_DIRECT的对齐约束、io_uring固定缓冲区的注册方法及其与O_DIRECT叠加时的注意事项。通过实测对比了三种写路径的性能,指出register_buffers组合在特定环境下可能失败,强调需在目标内核上验证。最后提供了工程检查清单和选型建议,帮助读者在实际应用中做出正确决策。
英伟达RTX SPARK N1X芯片的早期基准测试显示,其性能与苹果M3 MAX相当。N1X拥有20个核心,而M3 MAX则为14个核心。尽管M3 MAX表现优异,N1X仍在优化中,未来可能提升性能。N1X的图形性能与RTX 5070相似,最终的Windows on Arm体验需待发布后评测。
直播 SDK 是直播平台的核心技术,选择不当可能导致高延迟和成本失控。文章对2026年主流直播 SDK 在性能、功能、价格和生态方面进行了横向对比,并推荐适合泛娱乐、在线教育和电商直播等不同场景的 SDK。建议在选择时进行实测,关注综合成本和技术支持。
本文介绍了一个完整的LSM-Tree数据库引擎的实现,分为两个部分:第一部分使用C语言组装各个组件,提供六个API;第二部分用Rust重写核心模块,记录编译过程中的真实故事并进行性能对比。文章详细描述了数据库的内部结构、读写路径、崩溃恢复机制及后台线程的工作原理,强调了Rust在安全性方面的优势,并通过基准测试比较了C、Rust和LevelDB的性能,指出各自的优缺点。
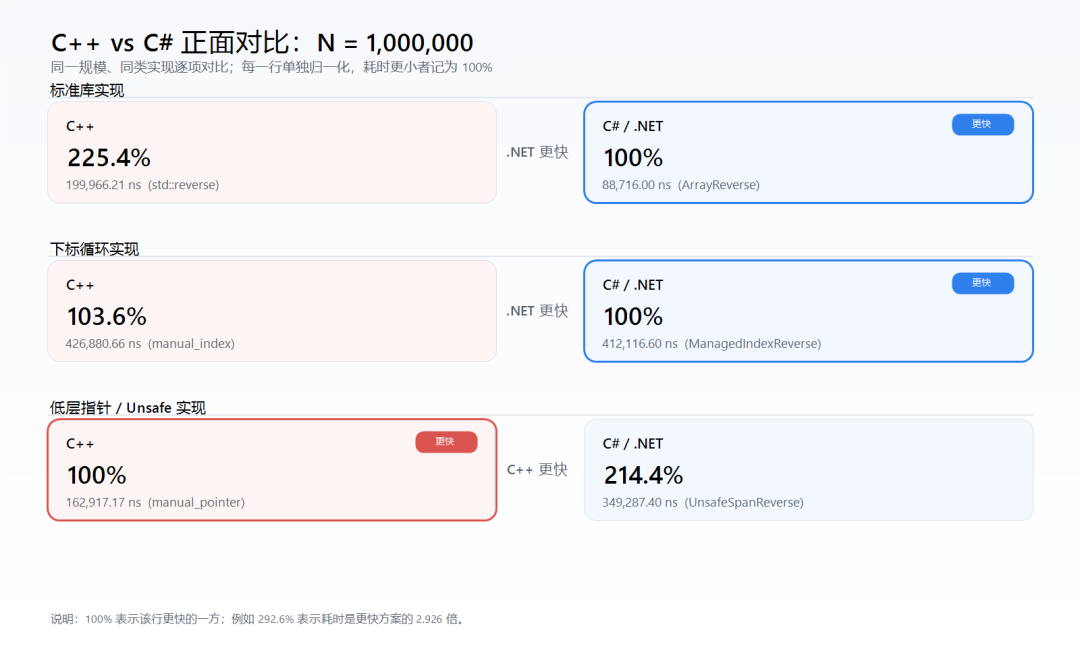
在数组原地反转性能对比中,小数组时C++表现优异,而大数组时.NET的Array.Reverse反超。经过控制变量测试,结果显示C++在小规模时更快,.NET在大规模时更具优势,反映出两者在不同场景下的性能特点。
该系列文章通过五篇深入探讨如何从零构建LSM-Tree KV存储引擎,涵盖设计决策、组件功能及Rust重写,涉及WAL、MemTable、SSTable、Compaction等关键概念,最终提供完整引擎及性能对比。
完成下面两步后,将自动完成登录并继续当前操作。