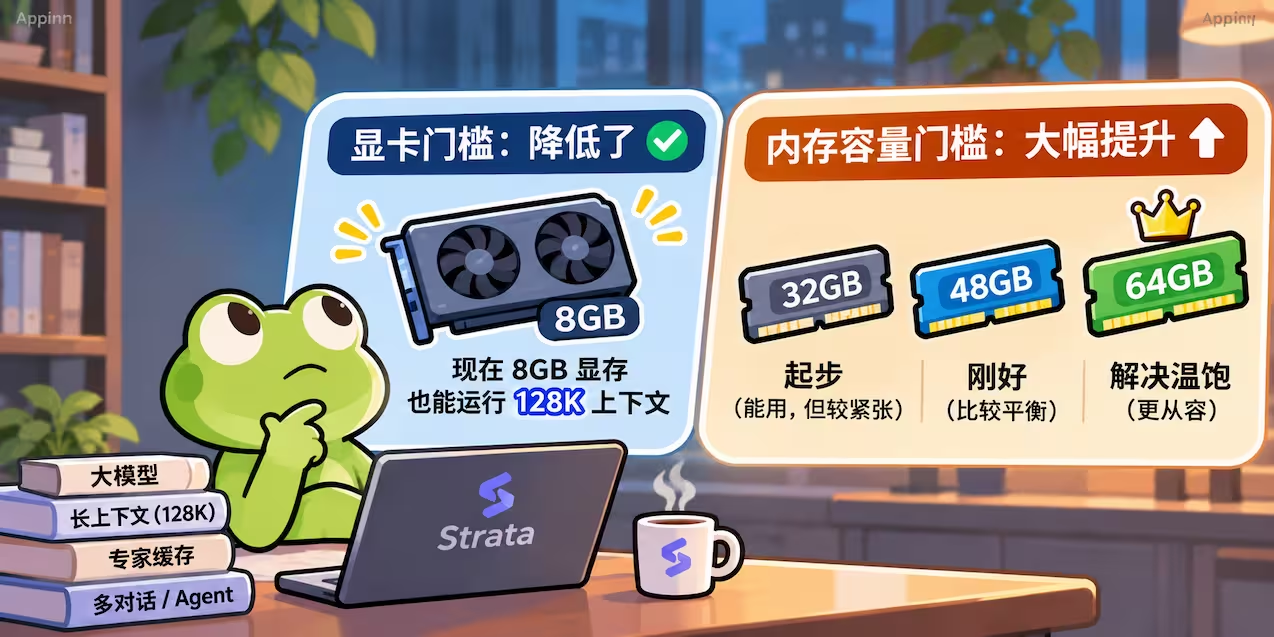
Strata 0.2.10 发布,默认启用 DFlash2 推测解码器,显存占用从约 5.2GB 降至约 625MiB,8GB 显卡也能开启 128K 上下文,但压力转移至内存和 SSD。多显卡协作优化使代码编辑速度接近翻倍。新增编程专用模型 ISTA-DAS Coder,并修复多项 Agent 与界面问题。
Docusign推出智能协议管理平台及Iris合同AI引擎,指出企业合同AI代理不能仅依赖通用大模型,还需协议内、跨协议、组织规则和用户偏好四类上下文。Iris结合智能提取、语义搜索与代理层,可关联合同及修订、判断现行条款、对照公司审批规则,并按金额阈值决定自动处理或人工审核,从而简化签约前后的合同管理流程。
freeCodeCamp发布MCP安全基础课程,讲解AI代理被利用的机制及防御方法。课程围绕“致命三要素”框架:当代理同时具备访问私有数据、摄入不可信内容、对外通信三种能力时,易受提示注入攻击。课程强调应通过架构边界而非脆弱的提示过滤来打破这一组合,加固AI代理集成。
Redis团队为文档问答智能体改进检索方案:V1将文档作为单一实体,导致BF.RESERVE等命令查询混入无关结果;V2拆分为页面、文本块、命令三类实体,并以稳定page_id建立关联,使智能体可按问题选择检索路径。在62题评测中,nDCG@5由0.493升至0.658,recall@5由0.610升至0.743,各组均有改善;但工具调用增多,p95延迟占请求预算的比例由约40%升至72%。下一步是减少冗余调用并及时停止检索。
Databricks提出企业AI应转向客户对话场景。语音智能体需结合受治理的数据、业务本体和快速决策模型,实时理解来电者身份与上下文,在规则内提供个性化服务,必要时转接人工。其架构分为对话层与运行于Databricks平台的“大脑”层,确保数据安全合规。每次通话可记录、评分并持续优化。建议从高频常规通话入手,用开源DIVA蓝图开展90天试点。
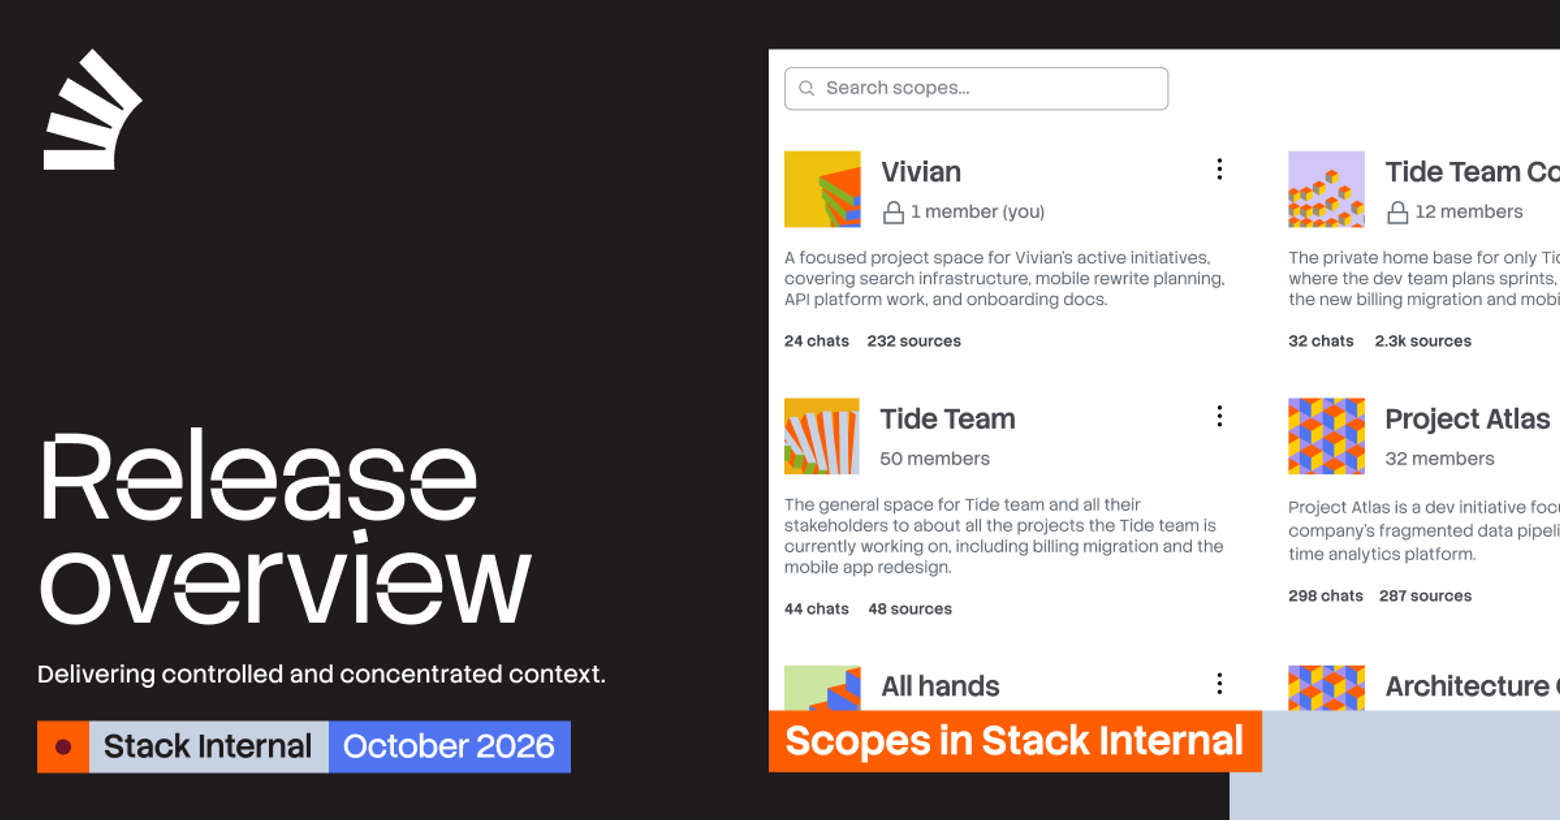
Stack Internal 十月更新为开发者和 AI 提供受控、集中的企业知识:新增 Scopes 按项目划分知识空间权限;GitHub 连接器自动导入代码讨论并沿用源权限;服务账户支持安全连接应用与工作流;界面内新增专家审核功能;验证 API 可将更新知识回写外部来源。社区版同时增强互动、审核与透明度。两者结合形成可验证、闭环的企业记忆层。
文章以小螃蟹与机器人的对话为引,区分AI的“知识”与“记忆”:知识来自训练参数或检索资料,用于回答规则与事实;记忆则是应用层保存的任务状态与历史。短期记忆依赖当前上下文,长期记忆需经提取、保存、再读取。模型参数不等于个人记忆,普通对话不会自动修改参数。若记错,需更新状态、保留来源并允许纠正。
本文介绍Python上下文管理器在文件处理之外的实用场景。with语句确保代码块无论成功或异常都会执行清理。可用类实现带状态的计时器,用@contextmanager简化单一设置与清理流程,用TemporaryDirectory自动删除临时目录,用ExitStack管理运行时数量不定的资源,用patch.dict()安全还原环境变量等状态。关键原则是__exit__()默认返回False,避免静默吞掉异常。
文章以小螃蟹与机器人的故事说明:AI的“理解”是指弄清意思、意图和约束,不能只看回答是否流畅。NLU专指理解自然语言,涵盖意图识别、实体抽取、指代消解等,只是“理解”的一部分,视觉与多模态理解不宜全归为NLU。NLP范围更广,NLU侧重分析,NLG侧重生成。上下文有助理解也可能带偏,判断理解是否正确须核对关键条件与任务结果。
DigitalOcean 无服务器推理正式推出提示缓存:缓存输入费用最高减免 90%,首字延迟降低 80%。新增缓存亲和路由,将重复请求导向已缓存提示的副本,命中率从约 35% 提升至 90% 以上。新增 prompt_cache_key 用于账户内流量隔离,支持 Responses API,上下文窗口提升至 256K 以上,并提供控制面板仪表盘查看命中率与节省费用。缓存自动生效,无需修改请求代码。
MCP可连接AI代理与外部工具,实现发消息、读邮件等功能,但开源服务器质量参差不齐,盲目集成易导致严重数据泄露。freeCodeCamp推出2小时免费课程,内容涵盖MCP基础、真实“零号病人”漏洞案例、OWASP MCP十大风险及缓解措施、企业安全五支柱(发现、治理、身份与访问、纵深防御、检测),以及欧盟AI法案、NIST AI RMF、ISO 42001等合规框架。
英伟达在GTC柏林大会推出Agent Knowledge Foundation,整合Nemotron检索模型、Auto-Ontology库、Kumo结构化数据模型及CUDA-X库,帮助AI智能体理解企业数据。数据保留在原平台并遵循原有权限,英伟达不与Snowflake等数据平台竞争而是合作,该方案已用于Palantir、Databricks和Snowflake。
文章比较了同一AI编码代理在50个故障集群上的诊断表现:仅使用shell和kubectl时,2分钟内正确率为60%,平均耗时191秒;接入只读MCP集群上下文后,正确率提升至86%,平均耗时降至64秒,工具调用次数也更少。上下文主要提供当前故障、变更时间线、资源关系和过滤日志。作者建议以只读身份和固定时限测试AI SRE,先衡量上下文带来的提升。
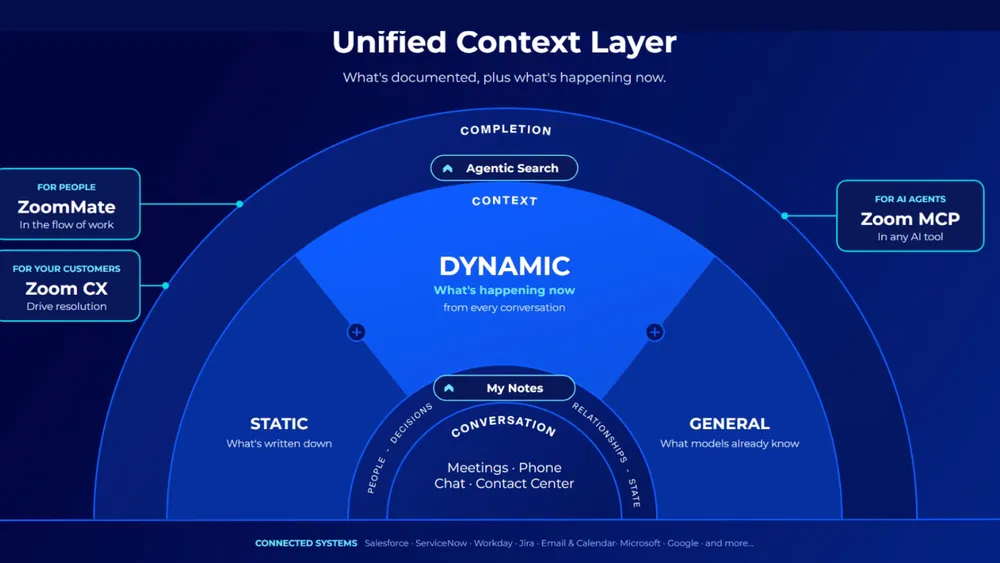
Zoom在Zoomtopia 2026发布统一上下文层,可捕捉会议、通话、聊天等对话中的隐性信息,构建动态知识图谱,供智能搜索与AI代理使用。该层整合第一方数据及Salesforce等第三方系统。Zoom同时推出客户档案,融合对话、CRM与案例数据,实现个性化服务,并强调不取代CRM而是扩展。Source Hub将于2027年初上线,初期支持Salesforce。
多数工程团队低估了自建AI知识系统的难度,六个月后往往成为平台团队的长期负担。生产级管道包含捕获、验证、组织、治理、交付五个阶段,每阶段都需持续维护,成本随AI栈复杂度增加。自建向量库虽可行,但构建受治理的可信知识管道极难,多数公司应选择采购而非自建。
Subquadratic发布决策模型SubQ Snap,支持38.4万token上下文,约为Jev的12倍,可一次性处理大型代码库和文档。该模型采用稀疏注意力架构,降低长输入计算成本,在多项基准测试中优于Jev,定价为每百万输入token 0.05美元。公司称更大上下文可简化AI代理开发,但结果均为内部测试,尚待独立验证。
APUS AI于10月13日开源Personal Agent产品Reflex Agent,采用MIT协议,提供桌面端、Web和SDK。该产品基于自研决策模型Reflex构建Harness,结合Continuum记忆引擎,通过“决策—执行—反馈—再决策”循环实现长周期任务执行,响应速度最快达主流Agent的3倍,并支持无限记忆与无限上下文。
Claude Code每次会话都从零开始,需重新理解系统架构。作者尝试用构建平台自动生成的依赖记录作为上下文来源:在空工作区中,Claude通过MCP读取远程组件及其依赖,成功为支持控制台添加筛选功能,41项测试通过。依赖记录随版本自动生成、不会漂移,与人工记忆互补——记忆承载意图,记录承载结构与依赖关系。
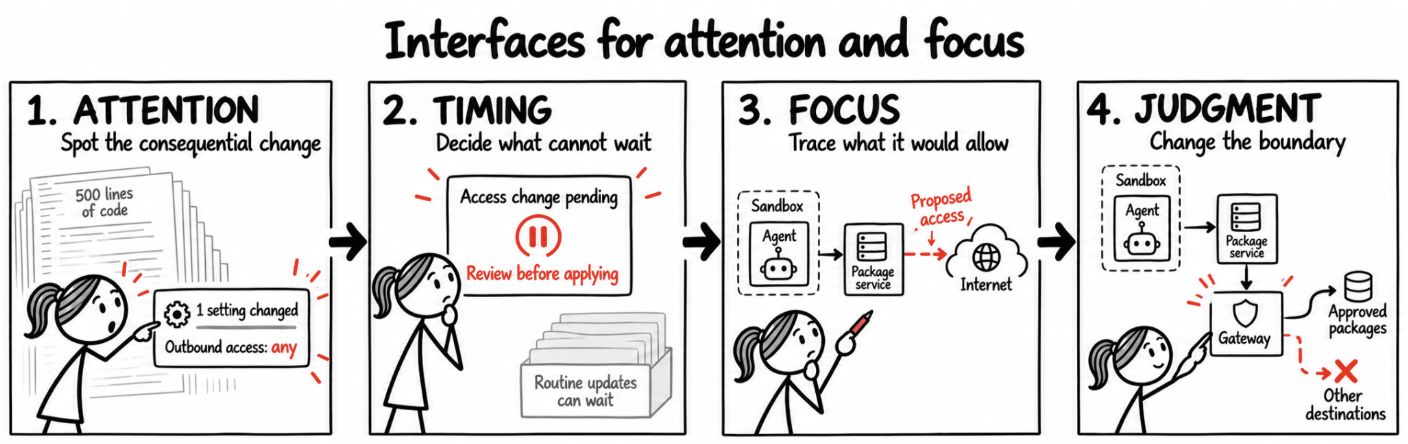
2026年的AI编程界面信息嘈杂,审批请求淹没在工具调用中,用户易盲目点“批准”。作者认为,若界面让人难以理解后果,人类监督便形同虚设,主张界面应保留上下文、突出关键变更,帮助用户维持对系统的连贯理解,而非沦为只会点批准的“肉代理”。
Jin 是一个追求稳定、简单和快速的 AI 编程智能体,提供终端(TUI)和网页(WebUI)两种界面。它旨在提供你需要的核心工具,而无需维护复杂的配置文件。 没有插件——这与DSH的理念截然相反。作者特意没有使用插件,因为我认为它们会降低代理的性能。在99%的情况下,可重用的提示就足够了。 不设技能/MCP认证
完成下面两步后,将自动完成登录并继续当前操作。