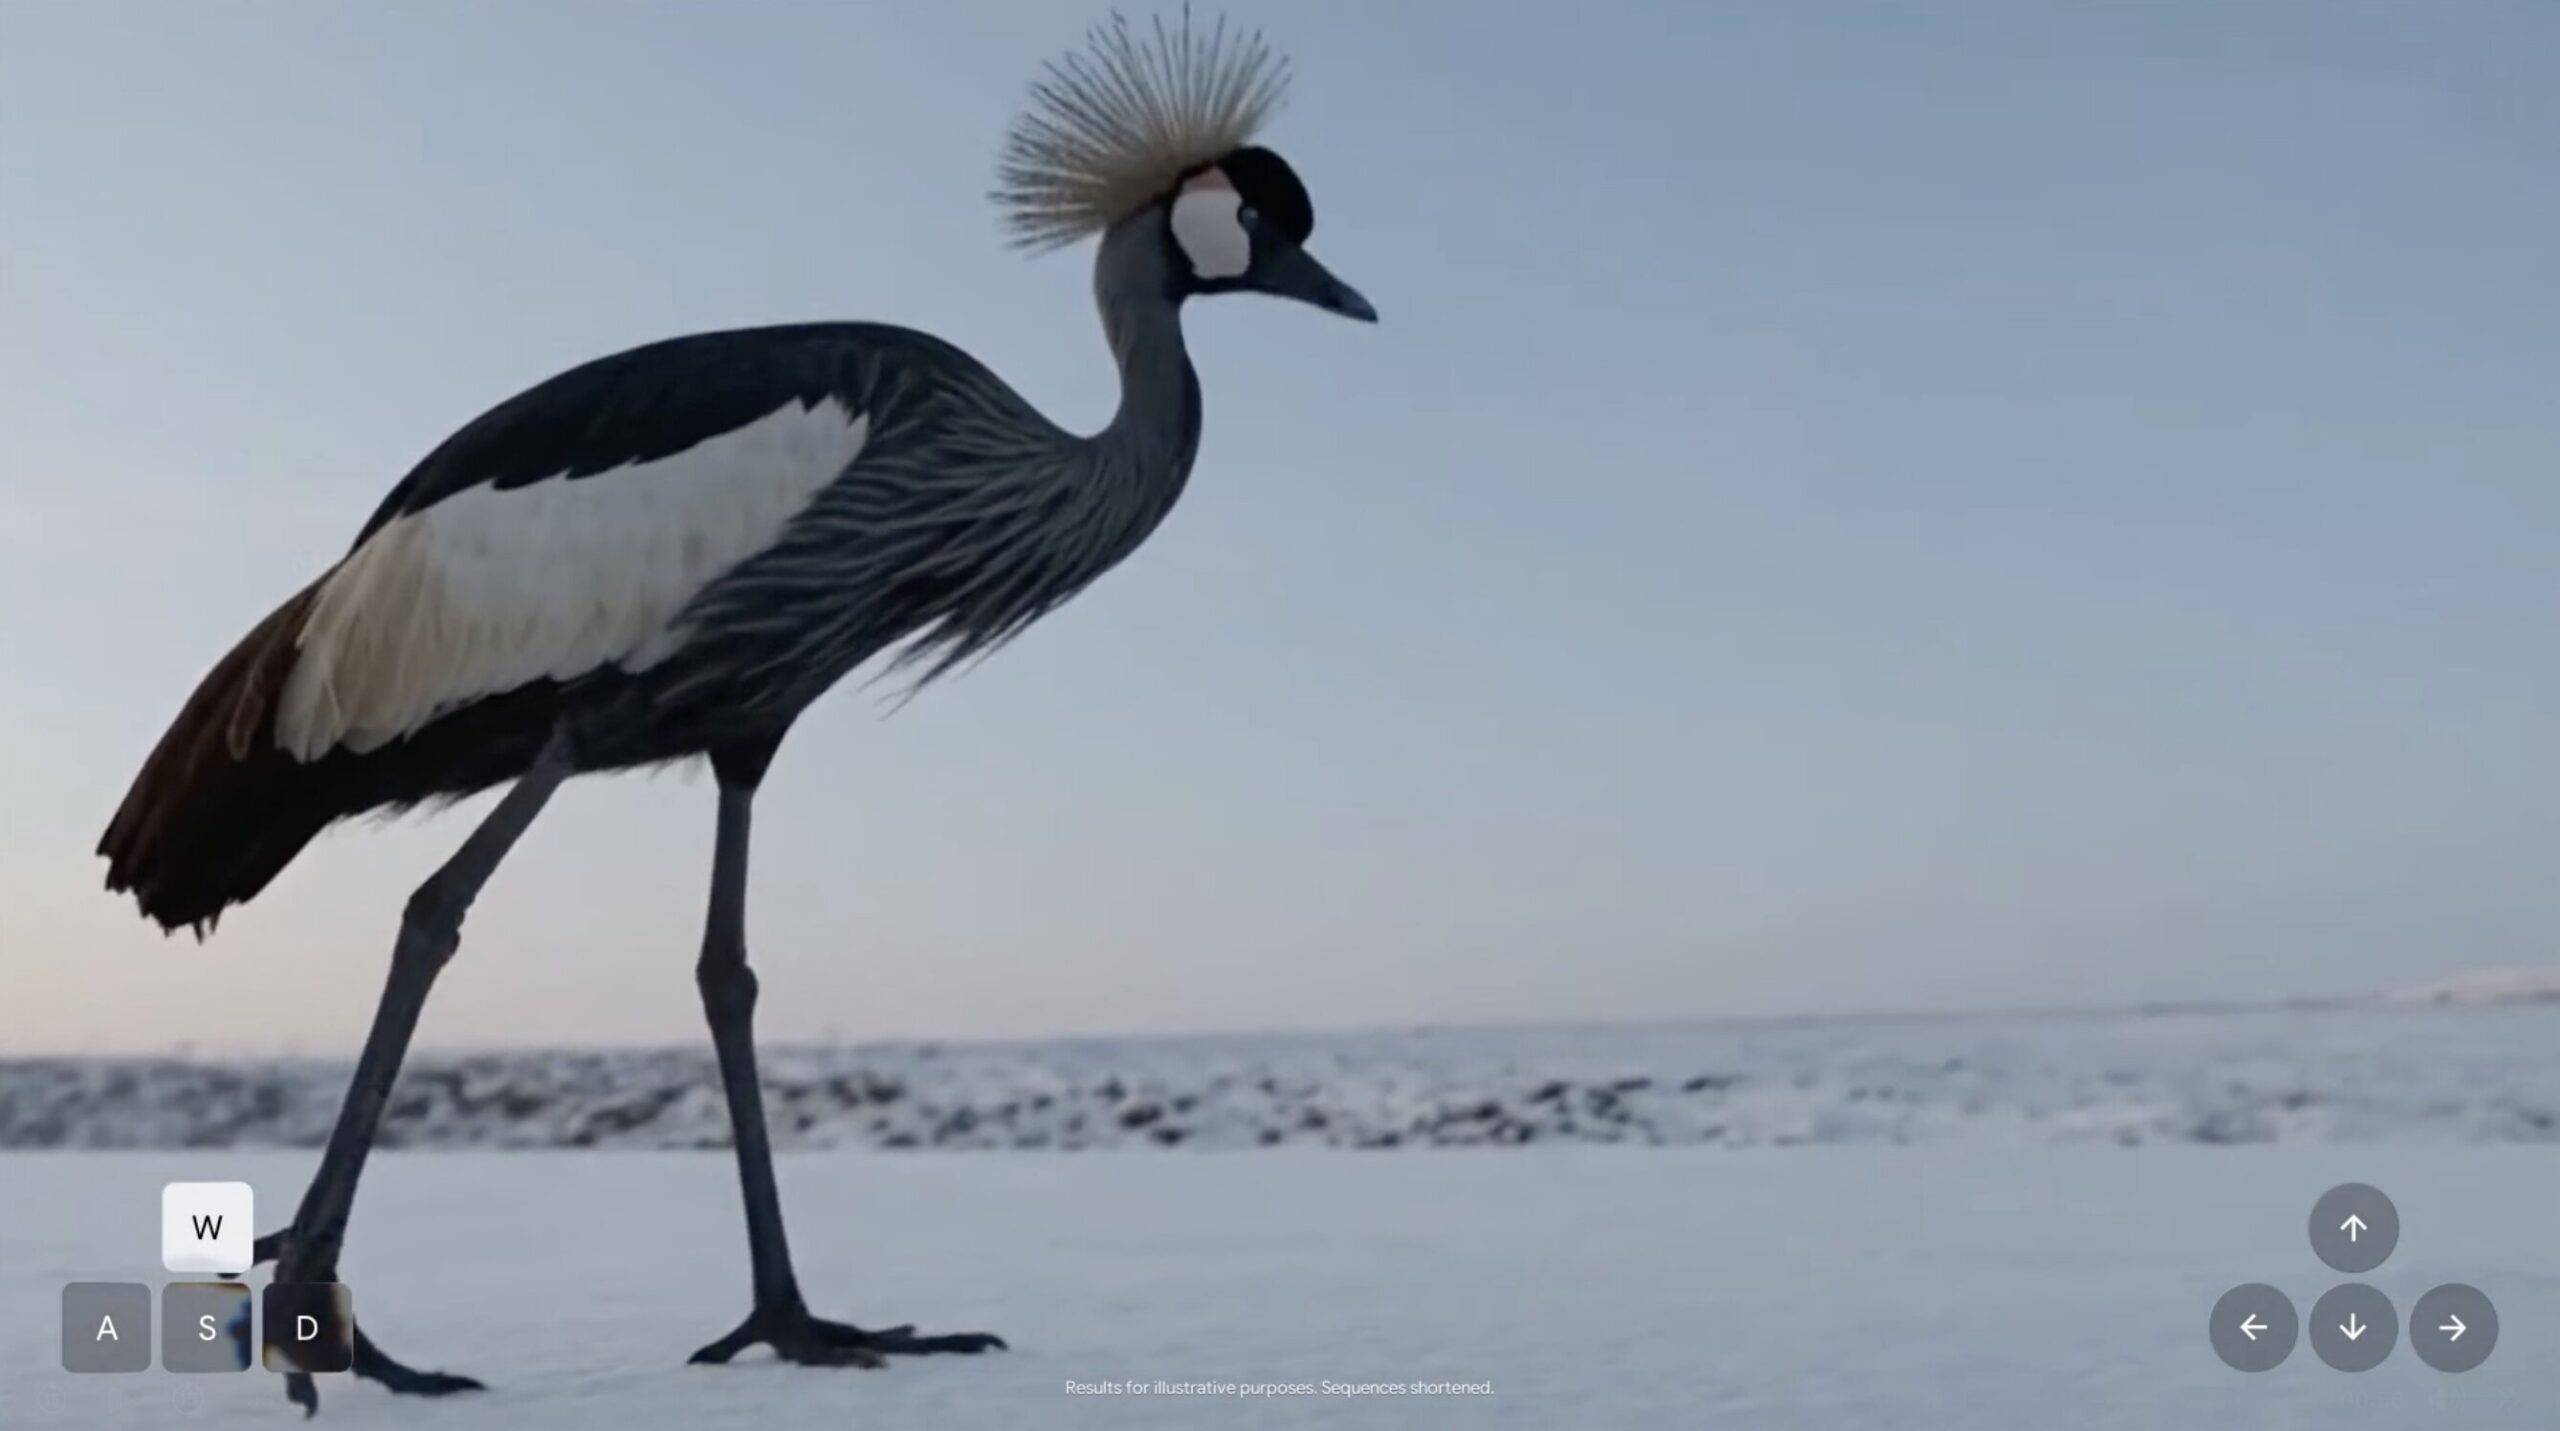
谷歌DeepMind发布世界模型Genie 4研究预览版,可根据文字生成高拟真可交互虚拟世界,首次实现音视频同步生成,支持实时编辑,最长维持两分钟连贯画面。升级包括原生音频、物理与人物模拟、实时场景导演及多步骤事件模拟,主要面向机器人训练、游戏开发、影视制作等。模型暂未公开,仅向受信任测试者开放,仍存在细节漂移等局限,并附带SynthID水印。
Google DeepMind发布世界模型Genie 4,可实时生成逼真虚拟世界,支持声音、物理模拟与角色对话,单次模拟约两分钟。Gemini负责规划行动,Genie 4生成环境,可应用于机器人训练、影视、游戏等领域,但仍存在时长、一致性和物理准确性等局限。
谷歌DeepMind发布世界模型Genie 4,可实时生成带物理模拟、人物动作和原生音频的交互环境,供AI智能体测试多步骤任务。该模型由多个Gemini模型驱动,支持键盘操控和文本提示改变场景。但长时间运行可能出现物体位置漂移和物理不准确,且未公布重复测试基准,目前仅限受信任测试者使用。
谷歌 DeepMind 发布 Genie 4 世界模型,能实时生成带声音的互动场景,场景连贯性只有两分钟,且仅开放给少数测试者。 ## Genie 4 先让一小撮人进场玩 谷歌 DeepMind 是谷歌旗下的人工智能研究实验室。Genie 4 是该实验室最新一代世界模型。世界模型干的事很直接,用文字描述一个场景,机器当场把画面算出来,人还能走进去看。它不存预先做好的地图,每一帧都是现算
谷歌发布世界模型Genie 4,具备原生多模态能力,可实时生成逼真画面、环境音效与角色对话,并结合Gemini模型进行推理与场景引导,支持用自然语言实时修改模拟及模拟物理与人物行为。该模型先向可信测试者开放研究预览,未来将登陆Google AI Ultra、Gemini API等平台,目前仍存在长时一致性和复杂物理交互等局限,生成内容均嵌入SynthID水印。
谷歌发布世界模型Genie 4,支持实时交互模拟并原生生成音效。该模型融合Gemini系列能力,由Gemini Omni保障真实感,其他模型维持模拟连贯性。用户可通过自然语言实时操控场景,如移动镜头、改变天气或添加角色,并同步生成环境音、音乐和对话。该技术被视为迈向AGI的重要一步,可用于机器人训练及影视、游戏等领域。目前已向少量测试者开放,后续将登陆Google AI Ultra等平台。
谷歌发布Genie 4世界模型,可生成更逼真的交互式体验。主要升级包括:世界更真实、支持自然语言实时修改、可生成音频、底层采用Gemini 3.8 Flash,体验时长从约一分钟增至约两分钟。该模型可用于影视预可视化、游戏原型和机器人训练,但长时间模拟中细节和物体恒存性可能漂移。目前仅向受信任测试者开放研究预览,后续将面向Google AI Ultra订阅用户推出。
GigaBrain-0.7 是具身基础模型,采用三系统架构:系统1基于 VLM 主干与动作专家生成连续动作;系统2负责理解与长程任务规划;系统3用世界模型预测未来视觉状态并评估进展。模型在超 3.7 万小时、16 种机器人形态的轨迹及约 2.7 亿视觉语言样本上单阶段联合预训练,并通过软知识隔离保持视觉语言能力,实现理解、预测、行动与经验改进的统一。
特赞创始人范凌提出,企业AI落地的关键不在于更强的模型,而在于构建两个“世界模型”:对外理解客户偏好的主观世界模型,对内理解流程、规则与默会知识的企业世界模型。企业需建立可积累的上下文系统,并引入专家判断数据。智能体应形成信号、规划、创作、评估的闭环,实现从“租用智能”到“主权智能”的转变。
达瓦科技凭借实时世界模型Scenes AI在NVIDIA创业展示中获奖。该模型不逐帧预测画面,而是维护持续运行的世界状态,仅更新变化部分,从而在更换画风、修改天气等编辑时保持人物、家具和空间不变。系统由世界记忆、神经物理、稀疏扩散、神经渲染和AI光照组成,可在单张消费级显卡上实现720P、25帧实时输出,并基于真实片场数据训练。
2026物理AI与世界模型大会在南京举行,主题为“建模物理世界·智启美好未来”。戴琼海、谭铁牛等院士指出,AI正从识别世界转向理解、预测和改造世界。杨立昆、姚期智等图灵奖得主视频分享,沈向洋、于海斌及创业者探讨灵巧手、智能制造与自动驾驶。大会成立长三角数据标注联盟,发布高质量数据集行动计划、50个应用场景,启动世界模型国家标准预研,并签约50亿元投资基金。
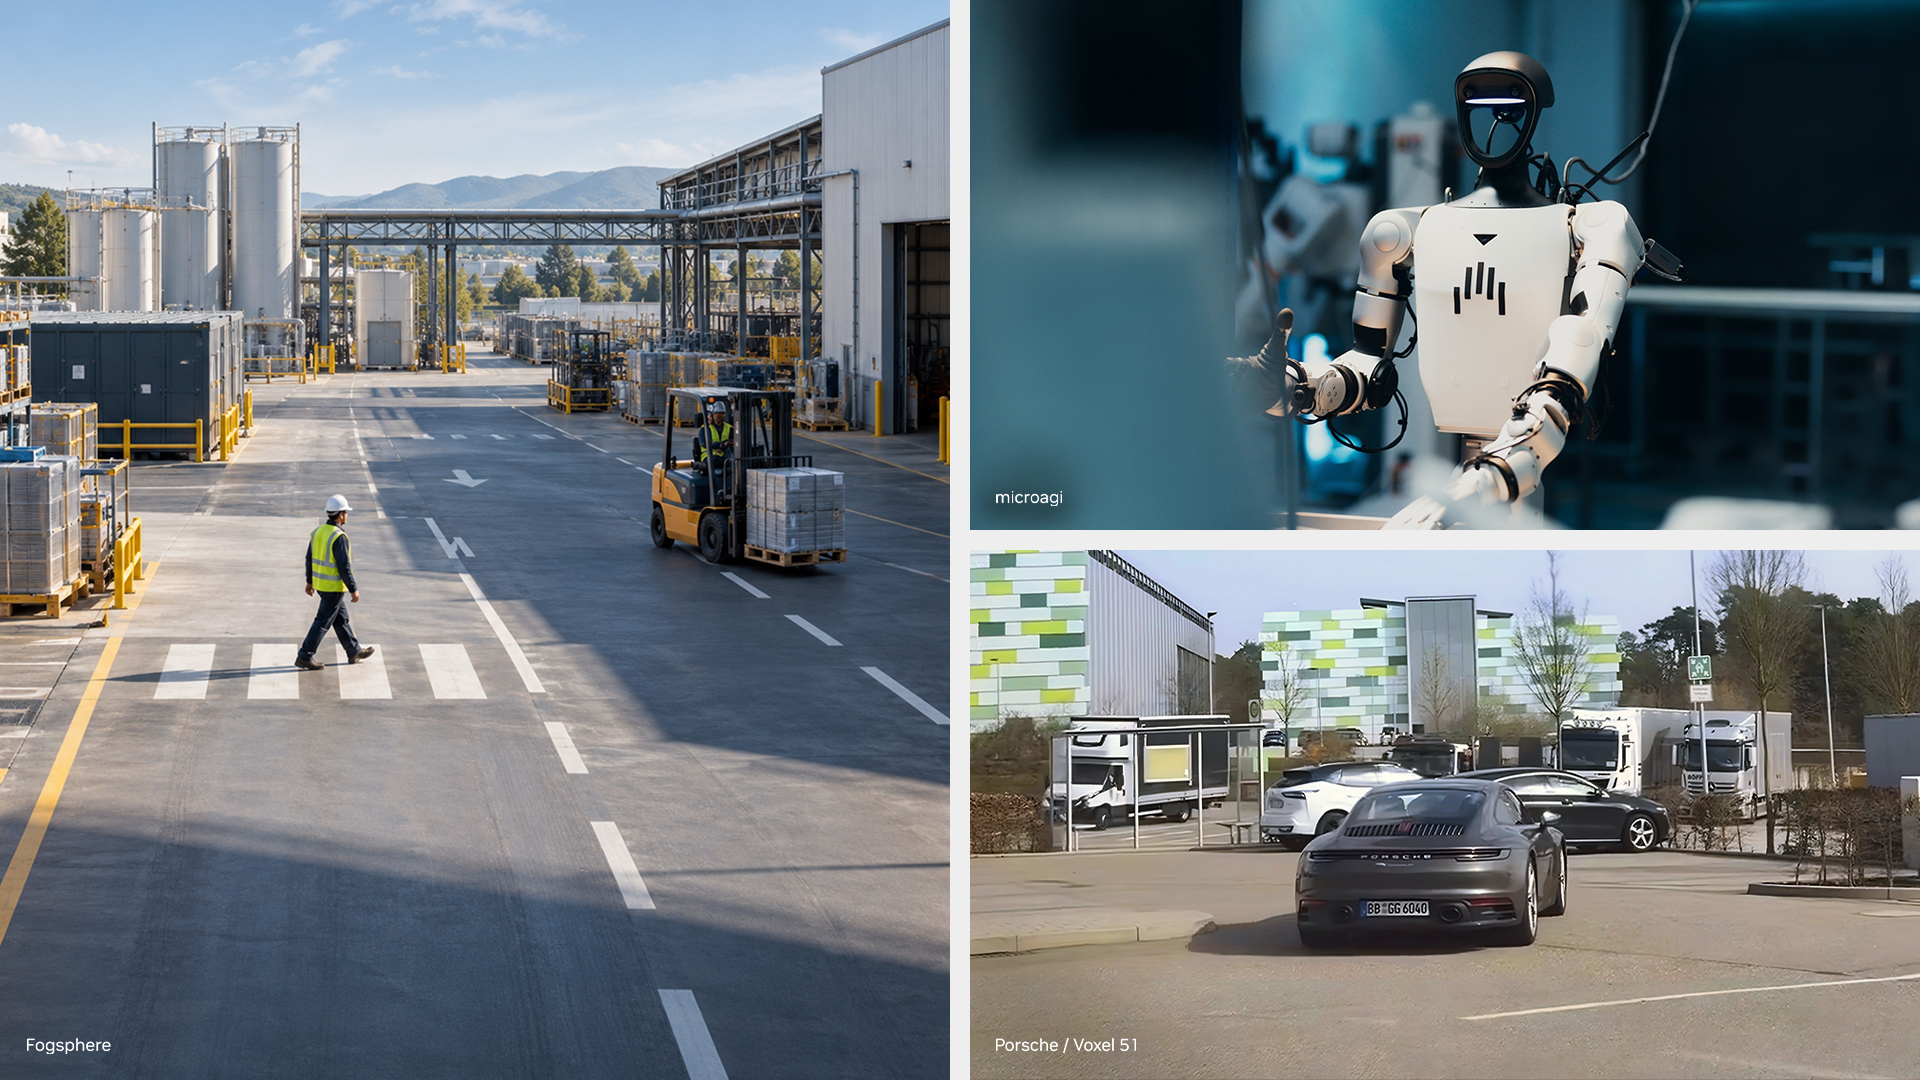
英伟达扩展Cosmos平台,新增训练工具、仿真检查点和数据工厂蓝图,帮助开发者更高效地训练、评估和部署世界模型。Cosmos数据工厂提供五类云端蓝图,用于自动驾驶、缺陷检测等合成数据生成;框架支持微调、强化学习、蒸馏和量化。保时捷、ANYbotics等已应用,可大幅减少实车测试并缩短开发周期。
千诀科技发布预测式世界模型Polibrain,不追求生成完整画面,而是聚焦物理规律与关键状态预测,构建感知、决策、执行、反馈闭环。其隐变量可辨识性研究早于LeCun团队约一年。公司还研究多项式表征与因果记忆以提升泛化能力,并采用松耦合架构,让不同形态机器人共享对世界的理解,探索跨本体数据复用。
2026年10月19日,医疗健康世界模型分会在南京举行,主题为“预见疾病·推演生命”。八场演讲围绕临床需求、建模方法、科研验证与应用,探讨疾病演变与干预推演。会上发布高质量数据集共建计划、医疗世界模型一体机、五项慢病模型、地贫筛查模型及数据底座等成果,并强调模型须经真实数据验证,不能替代医生决策。
VAST发布并开源实时世界模型EdenLive,首次实现任意参考输入、任意画风生成与长时连续运行。该模型采用状态维护与视觉渲染解耦路线,由上游交互系统维护世界状态,模型负责实时渲染。在单张RTX 5090、720P下,5B模型生成速度超24FPS,端到端延迟百毫秒级,可分钟级连续生成,适用于游戏预览、动画预览、视频换皮和具身数据增强。
清华特奖得主吴海旭创立物原科技,切入搭载物理建模能力的世界模型赛道,已快速完成多轮融资,估值达数亿美元,投资方包括蚂蚁、美团、达晨财智、星连等。其研究延续GeoPT路线,通过合成动力学让模型学习粒子轨迹演化以获得物理直觉。吴海旭曾提出Autoformer等里程碑工作,现于MIT CSAIL从事博士后研究,谷歌学术被引近3万次。
世界模型让AI学习环境动态并预测未来,用于规划与决策。本文推荐五大学习资源:伯克利CS285强化学习课打基础,斯坦福世界模型讲座入门,Ha与Schmidhuber的原始论文,斯坦福论文阅读清单,以及清华综述与资源库,另附世界模型手册。建议从基础逐步深入。
上海张江AI小镇推动具身智能落地,VLA模型让机器人在药房、工厂上岗,解决“能干”问题;世界模型负责“想清楚再干”,预测未来状态。蚂蚁灵波、智元、擎朗等企业探索两者融合,多条技术路线并行验证。行业认为二者互补,标准与评测体系正加速制定,最终以真实场景可靠性为检验标准。
RSI-Anything让AI先预测再行动,真正的难题才刚刚开始! RSI-Anything是Gen-Verse团队推出的开源递归自我改进框架。它串联起世界模型、外部评价与策略更新,尝试让AI在代码修复、浏览器自动化、实验室方案规划以及化学反应优化任务中持续迭代变强。这项工作最核心的突破,是把每一次行动的真
昆仑万维发布Matrix-Game 4.0,为全球首款可在单张RTX 5090上实时运行的开源游戏世界模型。其核心思路是“给视频模型套上Harness”:游戏引擎用代码维护世界状态与规则,视频模型仅负责实时生成画面,从而实现盾牌耐久、血量结算等真实游戏逻辑。通过结构草图、动态Caption、少步蒸馏等优化,按键响应不到0.15秒,60帧运行,显存峰值约18.5GiB,并开源模型与代码。
完成下面两步后,将自动完成登录并继续当前操作。