Vercel 现支持用 Python 为 FastAPI、Flask、Django 等框架编写路由中间件,在请求到达应用前运行,可重写、重定向或直接响应请求。中间件需在 vercel.toml 中配置 proxy 入口,作为独立 ASGI/WSGI 应用运行,依赖放入 pyproject.toml 的 vercel.proxy 组。vercel-proxy 包提供 Proxy 等工具,支持按路径路由;未匹配任何路由的请求将原样转发给应用。
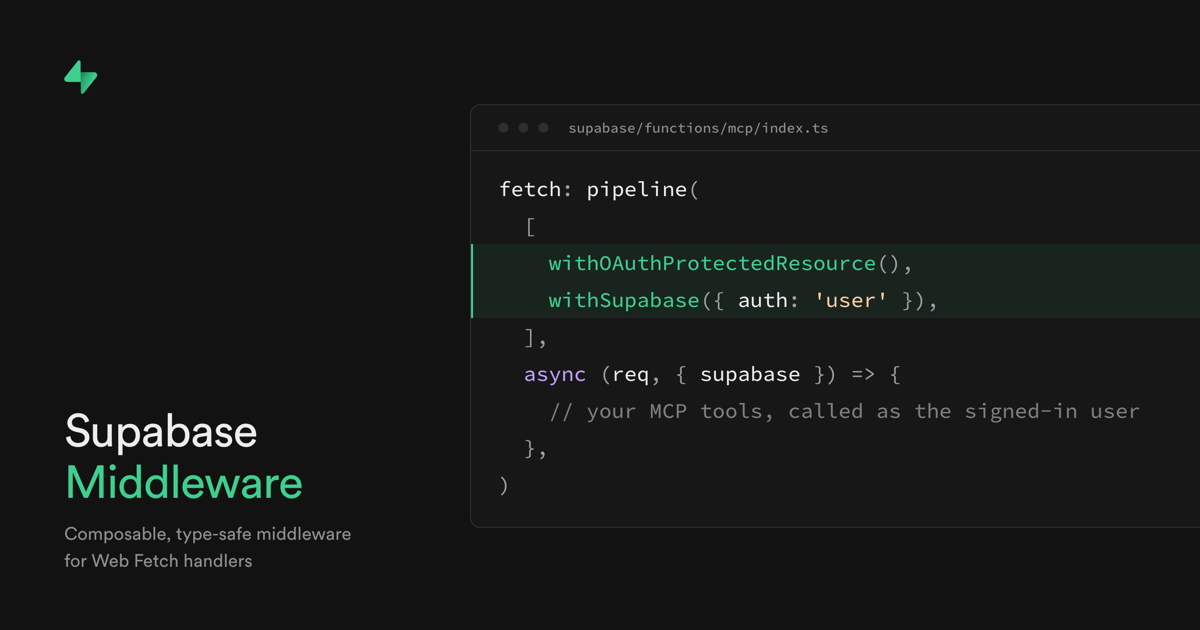
Supabase 发布 @supabase/middleware,为 Web Fetch 处理器提供可组合、类型安全的中间件。开发者编写一次每请求逻辑,即可在任意支持 fetch 的运行时及 Hono、NestJS 等框架中复用。内置 CORS、JWT 验证、客户端注入等中间件,支持自定义扩展与打包共享,采用 MIT 许可,不绑定 Supabase。
Vercel 新增 skipMiddlewareRequestBody 选项,允许路由中间件跳过接收客户端请求体,以减少 Fast Origin Transfer 用量并改善首字节时间,尤其适合大请求体。仅在中间件不读取请求体时启用,Vercel Functions 和重写目标仍能收到请求体。可在 vercel.json 或 vercel.ts 中设为 true,需重新部署生效,默认关闭。
本文介绍 Node.js 与 Express.js 入门:Node.js 是浏览器外的 JavaScript 运行环境,支持 CommonJS 与 ES 模块,并可用 http 模块创建服务器;Express.js 简化了路由、中间件和响应处理,支持 Router 分组路由、静态视图与 EJS 动态模板。
TypeSafe AI 推出决策小模型 Jev,专用于选择题、打分和是非判断,每百万输入 token 仅 0.042 美元,输出免费,比大模型快 200 倍、便宜 400 倍。文章介绍其三种题型与十步集成方法,并展示浏览器操作、邮件分类、安全护栏、模型路由、上下文压缩五大场景,指出智能体约八成调用实为选择题,应交给 Jev 处理。
2026年多项专利申请显示,在LLM输入前进行“瘦身”成为趋势,包括日志折叠、子句剪枝、动态截断、工具清单最小化等。Token管控从事后记账前移至喂模型前,但缺少通用审计与裁剪的中间层。独立开发者可开发Token浪费审计CLI与压缩代理,帮助AI外包开发者降低成本,约1500-3000元、2-3周可出MVP。
该文聚焦AI Agent工具调用权限管控的专利趋势,指出2026年多项专利将权限管理下沉至操作系统层,视Agent为不可信对手。技术方向包括独立拦截、沙箱暂停、委托凭证等,但个人开发者本地轻量守门层仍空白。文章提出落地机会:开发本地工具调用代理,通过YAML白名单和审批队列拦截高危操作,并建议开源守门器加审计服务,面向编码Agent用户。
近12个月,微软、Palo Alto、蚂蚁、Radware公开了五件提示词注入防御专利,OWASP将其列为LLM头号风险。专利分为输入过滤与行为防御两类,均作为独立中间层实现。小团队缺乏低成本验收测试,可使用garak生成变体攻击并输出风险报告,或构建内容过滤中间件,成本控制在五千元内,4周内可完成MVP。
Cloudflare Pages会将.html网页自动308重定向到无扩展名地址,且无法配置关闭。作者尝试多种方法无效后,通过英文AI获得解决方案:在项目根目录创建functions文件夹,添加_middleware.js文件,用中间件拦截.html请求,内部获取无扩展名HTML并返回200状态,从而保留.html扩展名,避免重定向。
该文聚焦2026年大模型API中间层专利趋势,涉及NVIDIA、IBM等公司的路由、缓存与成本预测技术。核心机会在于为开发者构建中间件,通过语义缓存、智能路由和成本护栏降低API费用。建议提供成本审计服务和垂直优化代理,月费99-299元,但需警惕大厂内置风险,应垂直化积累经验。
DeepSeek Harness采用“万物皆插件”架构,核心Agent由多个插件组合而成,而非固定程序加扩展。插件通过声明依赖(如tools)动态连接,系统持续管理其生命周期(PENDING至DISPOSED),卸载时自动清理注册的工具、监听器和定时器(effect机制)。Fiber记录插件运行状态,waterfall中间件链允许权限检查等拦截流程。Bundle打包多个插件,Profile定义组装方案,安装插件即下载并加入Profile。
美国国家内容与技术合作组织(NCTC)与Minerva达成协议,旨在扩大独立运营商的技术解决方案,提升视频产品和策略。Minerva提供的云原生平台支持直播、点播和流媒体服务,帮助运营商改善用户体验,加速向下一代电视服务转型,降低运营复杂性,创造新的盈利机会。
MAF中的ReAct循环通过FunctionInvokingChatClient中间件实现,AIFunction调用由此驱动。TransferMoney工具函数在用户未确认转账时,会注入风险提示消息,确保用户提供验证码。MessageInjectingChatClient用于注入消息并存储在Session的StateBag中,增强了风控能力。
OpenTelemetry已成为应用和服务可观测性的标准。OpenTelemetryChatClient中间件通过重写方法,支持LLM调用的链路跟踪和性能监控。结合Prometheus和Grafana,开发者可以轻松搭建监控环境,收集和展示性能指标。示例代码展示了如何使用ActivitySource记录调用链信息,并在控制台和Grafana中查看性能数据。
本文讨论了ReAct循环中ChatHistoryProvider的消息存档机制。默认情况下,消息在循环结束后存档,可能导致数据丢失。为提高可靠性,建议使用PerServiceCallChatHistoryPersistingChatClient中间件,实现每次迭代后即时存档,确保数据安全。通过示例展示了如何创建和使用该中间件,以持久化对话历史,防止数据丢失。
本文介绍了如何利用ImageGeneratingChatClient中间件与ImageGenerator结合生成高质量图片。用户通过与Agent对话描述图片,LLM生成专业提示词,ImageGenerator根据提示生成图片。示例展示了如何输入描述并生成不同风格的布偶猫图片,强调了提示词的细节要求和生成过程中的工具使用。
本文介绍了如何使用IChatClient和ChatClientAgent动态配置ChatOptions,以实现不同模型的交替使用。通过ConfigureOptionsChatClient中间件,可以在每次调用时设置模型ID。同时,AIContextProviderChatClient中间件利用AIContextProvider生成增强的请求消息,提升对话质量。示例代码展示了对话摘要处理和动态配置的实现。
ReducingChatClient是一种中间件,旨在通过精简对话内容来提高Agent的决策准确性。它利用SummarizingChatReducer对对话进行摘要处理,保留关键信息,减少上下文干扰,从而优化LLM推理质量。系统通过设置targetCount和threshold参数,确保在不丢失基本语义的情况下保留必要的对话信息。
我参加了Rust线上黑客松,主题是用Rust编写轻量级Web服务框架。活动氛围轻松,大家互相交流和代码审查。我优化了一个解析中间件,并成功合并到demo仓库,收获颇丰。主办方建立了资源群,提供了技术大厂的机会,鼓励大家多参与此类活动。
CachingChatClient是一个中间件,用于缓存LLM调用结果,减少重复调用的时间和费用。它通过检查缓存返回相同输入的响应,若不存在则调用LLM并存储结果。DistributedCachingChatClient是其具体实现,利用IDistributedCache作为缓存存储,确保相同输入得到相同输出,提高效率。
完成下面两步后,将自动完成登录并继续当前操作。