DeepSeek-V4.1在主干外有两处改动。视觉端:自研DeepSeek-ViT从零训练,采用2D-RoPE、RMSNorm、SwiGLU,经3×3 pixel-unshuffle将token数除以9,再投影到5120维;1302×1302图像占994个位置,文本与图像token各用一套MoE负载均衡偏置。优化器端:head-wise Muon按注意力头分别正交化query权重;Sinkhorn-balanced update以行列交替归一化替代Adam二阶动量,仅存一份动量即可训练196B参数的Engram表。
PostgreSQL 19 将新增查询提示功能,通过 pg_plan_advice 等扩展模块,用户可指定连接顺序、扫描方式和索引,覆盖优化器默认计划。该功能适用于无法修改的查询或函数估算错误场景,但官方提醒优化器通常正确,应优先分析表和调优索引,提示仅按查询 ID 精准使用,并常检查执行计划。
DeepSeek-V4采用Muon优化器,通过谱范数最速下降实现逐矩阵正交化,用Newton-Schulz迭代逼近SVD,混合系数提升小奇异值并精确稳定大值。RMS匹配对齐AdamW,部分参数仍用AdamW。Q/KV归一化替代QK-Clip防logit爆炸,Anticipatory Routing打断MoE路由正反馈,MTP预测多token,训练配方含32T token等细节。
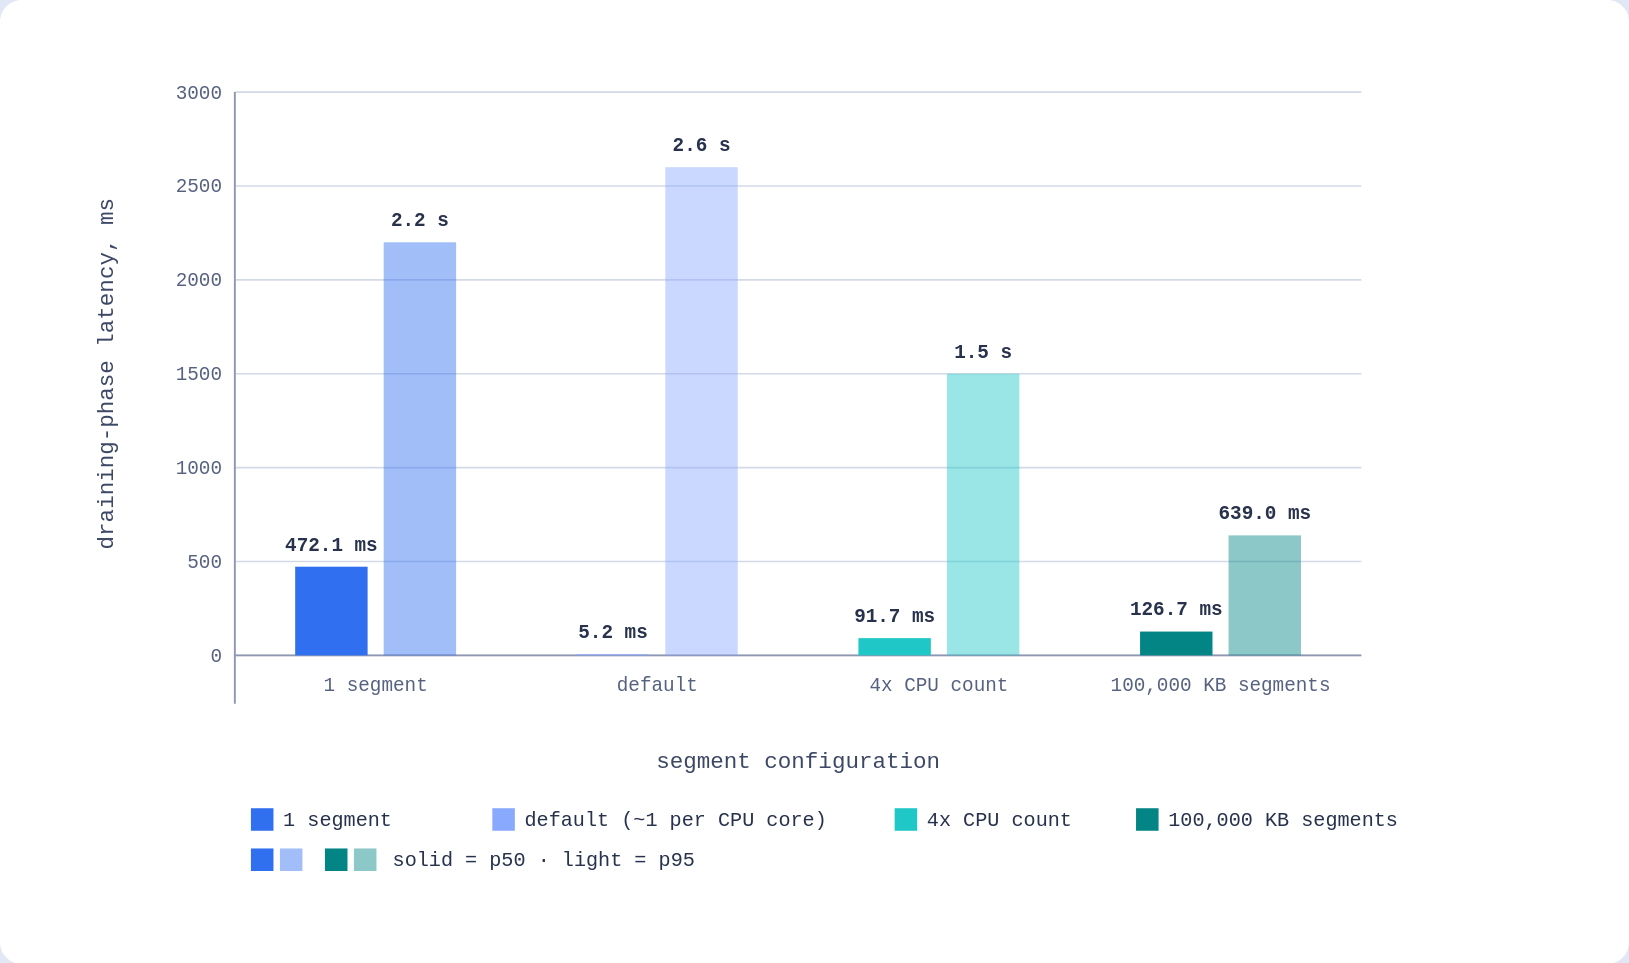
本文通过基准测试,量化了Qdrant优化器配置对搜索延迟的影响。连续索引虽在加载后需恢复期,但稳态延迟可降180倍;启用prevent_unoptimized能大幅降低排空期延迟,但新点暂不可见。单段配置稳态最快但恢复慢,限制段大小则相反。串行化优化线程可平滑延迟但延长排空。提高删除阈值可避免真空干扰。建议根据负载权衡配置。
Qdrant批量导入后,优化器积压会导致查询延迟飙升。基准测试显示:启用持续索引时,排空阶段p50延迟为780毫秒,优化完成后降至4.3毫秒;禁用索引则稳态延迟高达256毫秒。实验性prevent_unoptimized标志可将排空延迟降至10.2毫秒,但新写入点暂时不可搜索。单段配置稳态最快,但恢复超一小时;限制段大小可加速恢复12.7倍。串行化优化线程可降低p95延迟,但延长排空时间。提高deleted_threshold可避免vacuum干扰搜索。
本文介绍OLAP查询规划器与优化器的实现,涵盖三个阶段:绑定器解析名称和类型、优化器通过谓词下推、常量折叠和投影下推提升效率、物理规划器将逻辑算子映射为可执行算子。以DuckDB为例,展示逻辑计划树构建及优化过程,最终减少数据处理量,提高查询性能。
本文讨论了优化器在 SQL 查询中的重要性,特别是 Apache Calcite 和 Trino 的关系。Calcite 提供逻辑计划和优化规则,而 Trino 则采用自研规划器,借鉴 Calcite 的代数思想。文章还介绍了物理计划的执行约定、优化规则及其在 Trino 中的实现,强调了优化阶段的流水线和调试手段。
在蒙特利尔的开发者培训计划中,参与者深入学习了PostgreSQL的优化器、IPC和共享内存等内容。Robert Haas的课程受到高度评价,学员们积极参与讨论和实践,计划未来继续研究优化器源代码和相关补丁,以提升对PostgreSQL的理解和应用。
本文讨论了MySQL 8.0.36中优化器与处理器的关系,重点介绍了索引条件下推(ICP)和多范围读取(MRR)机制。ICP通过在二级索引上过滤条件来减少回表次数,而MRR则通过批量收集主键来优化IO性能。文章分析了优化器如何利用统计信息选择索引,并使用EXPLAIN分析执行计划。同时,强调了MySQL与PostgreSQL在处理机制上的差异。
Postgres 19引入了pg_plan_advice和pg_stash_advice模块,提供查询建议功能,帮助优化器选择更好的执行计划。此功能允许DBA在特定情况下调整查询计划,提升Postgres的灵活性和性能。
DeepSeek-V4系列模型推出了1.6T和284B参数的两个版本,采用混合注意力架构和流形约束超连接,提升了长上下文处理效率。通过Muon优化器和多项基础设施优化,模型在训练和推理阶段展现出更高的稳定性和效率。预训练后,DeepSeek-V4在多个基准测试中超越前代,设立了新的性能标准。
本文梳理关系查询优化器的发展主线:System R 以左深动态规划和 interesting orders 奠定代价优化范式;Volcano/Cascades 通过 memo、规则与物理性质组织搜索;DPccp/DPhyp 改进连接枚举。实验表明,查询图稠密度比表数量更影响枚举规模,基数估计误差是产生坏计划的主因。PostgreSQL 16 默认在超过 12 个表时转为 GEQO,学习型优化器宜作为补充。
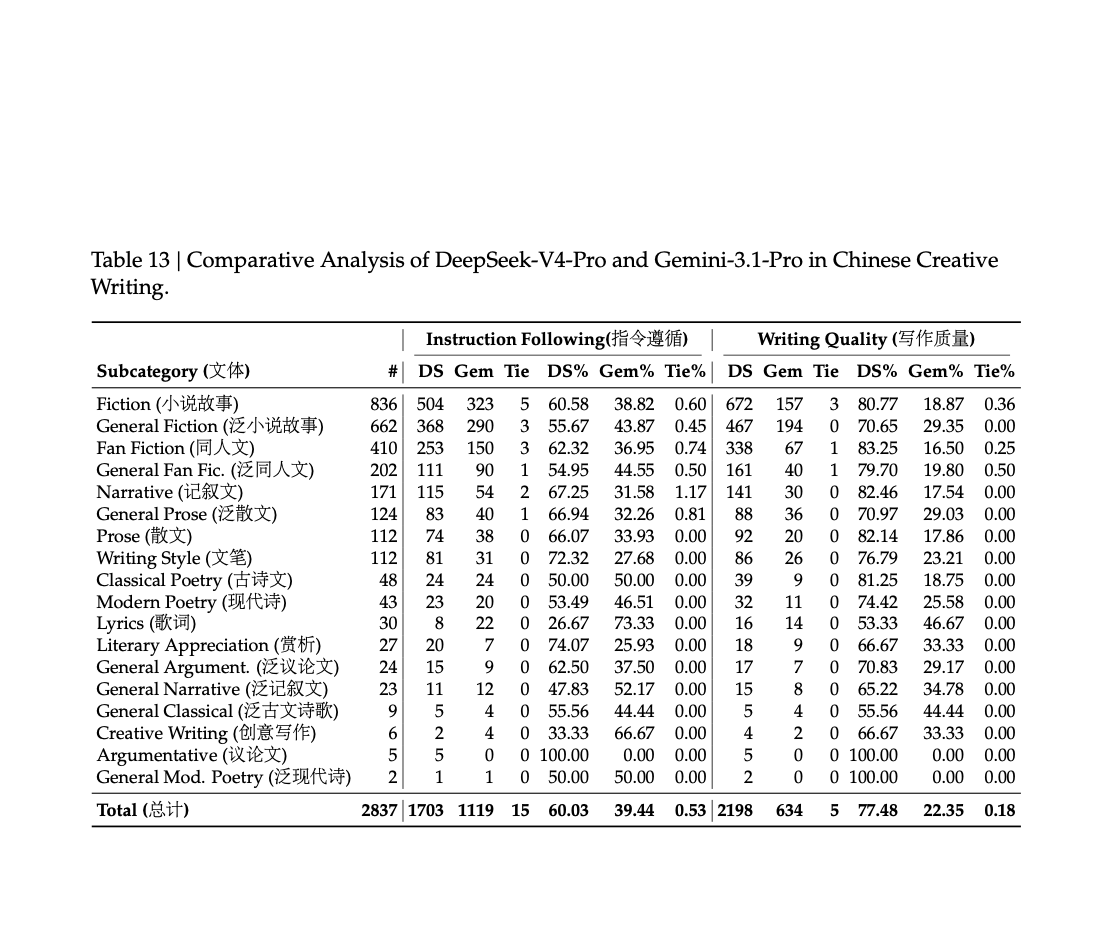
DeepSeek-V4技术报告强调通过改进注意力机制和优化器,提高超长上下文处理效率,能够高效处理1M上下文,降低计算和缓存成本。模型在中文写作和白领任务中表现良好,但在复杂任务上仍需提升。整体目标是解决长上下文的成本问题,提供完整的技术方案。
本文探讨了在Transformer模型中将点积结果除以√d_k的原因。这一操作旨在避免softmax函数饱和,确保梯度有效传播。通过数学推导,证明了点积的方差为d_k,缩放后方差归一化为1,从而保持训练的稳定性。文章还讨论了不同维度下的训练效果及现代优化器如何与√d_k的设计结合,以提升模型性能。
文章讨论了优化器的选择与学习率的调整,指出不同任务对优化器的需求。SGD在某些视觉任务上优于Adam,学习率过小可能导致训练缓慢和局部极小值问题。此外,梯度消失与爆炸仍是深度学习中的挑战,需要理解其在现代架构中的表现。
本文介绍了机器学习中自动微分的实现方法,通过将复杂函数拆解为基本运算构建计算图,以精确高效地计算导数。文章还展示了反向传播、梯度更新及优化器的实现,并提供了一个类似PyTorch的开源框架。
在MySQL中,可以通过开启优化器跟踪来分析索引使用情况,从而了解优化器如何处理查询以及未使用预期索引的原因。
PostgreSQL 18引入了多列B树索引的跳过扫描功能,显著增强了优化器。在低基数情况下,跳过扫描能显著提升查询速度,而在高基数情况下,全索引扫描仍然更优。
最近笔者刷到论文《Why Adam Works Better with β1=β2: The Missing Gradient Scale Invariance Principle》,顾名思义,...
文章讨论了客户在批处理后首次执行查询时速度缓慢的问题。分析显示,查询计划在两次执行中不同,主要由于连接策略变化:首次使用合并连接,第二次使用嵌套循环连接。尽管表未清理或分析,优化器行为仍不同,导致执行时间差异。最后,作者提供了重现此现象的脚本。
完成下面两步后,将自动完成登录并继续当前操作。