小红花·文摘
  • 首页
  • AI Tokens🪙
  • 排行榜🏆
  • 直播
  • FAQ
Dify.AI
沉浸式翻译 immersive translate

本文介绍在Ubuntu系统上部署WanGP并运行MiniMax H3视频模型的方法。MiniMax H3支持文生视频、图生视频和多模态参考生成,可输出4至15秒、768P或2K视频。WanGP面向低显存设备,最低6GB显存即可运行,内置加速组件并能自动下载模型。作者使用官方脚本安装,建议内存32GB以上,首次测试选用FL2VA模型、480P、5秒,约五分钟即可生成。

Ubuntu 下 WanGP 部署 MiniMax H3

碎言博客 碎言博客 · 2026-10-17T07:25:37Z
发布Paints-UNDO安装程序 - 像从零开始绘制一样撤销图像 - Windows和RunPod的一键安装

PaintsUndo应用程序能够模拟艺术家绘制图像的过程,生成绘制步骤和视频输出,支持低显存模式和一键安装,适用于Windows等平台。

发布Paints-UNDO安装程序 - 像从零开始绘制一样撤销图像 - Windows和RunPod的一键安装

DEV Community DEV Community · 2025-02-01T00:35:50Z

该文综述大语言模型量化与LoRA微调结合的研究,包括LoftQ、QA-LoRA、ModuLoRA、ApiQ、QLoRA、LQ-LoRA、L4Q等方法,旨在降低显存占用,实现4位乃至2位量化微调,同时保持下游任务性能,部分方法在摘要等任务上超越现有水平。

通过信息保留实现 LLMs 的精确 LoRA 微调量化

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2024-02-08T00:00:00Z
令人难以置信!用这项新技术在仅有 4GB GPU 的设备上运行 70B 大语言模型推理 [译]

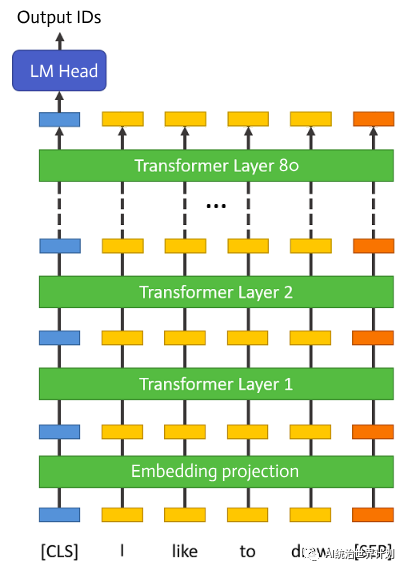
文章介绍了一种分层推理技术,可在仅4GB显存的单GPU上运行70B大模型:按需从磁盘逐层加载Transformer层(每层约1.6GB),用完即释放;结合Flash Attention降低注意力内存、按层分片模型文件并用safetensors内存映射加速读取、借助HuggingFace元设备实现零内存加载。作者开源了AirLLM库,几行代码即可实现,已在16GB T4上验证显存占用不足4GB,但速度较慢,适合离线文档分析。

令人难以置信!用这项新技术在仅有 4GB GPU 的设备上运行 70B 大语言模型推理 [译]

宝玉的分享 宝玉的分享 · 2023-12-04T00:00:00Z
  • <<
  • <
  • 1 (current)
  • >
  • >>
👤 个人中心
在公众号发送验证码完成验证
登录验证
在本设备完成一次验证即可继续使用

完成下面两步后,将自动完成登录并继续当前操作。

1 关注公众号
小红花技术领袖公众号二维码
小红花技术领袖
如果当前 App 无法识别二维码,请在微信搜索并关注该公众号
2 发送验证码
在公众号对话中发送下面 4 位验证码
小红花技术领袖俱乐部
小红花·文摘:汇聚分发优质内容
小红花技术领袖俱乐部
Copyright © 2021-
粤ICP备2022094092号-1
公众号 小红花技术领袖俱乐部公众号二维码
视频号 小红花技术领袖俱乐部视频号二维码