

令人难以置信!用这项新技术在仅有 4GB GPU 的设备上运行 70B 大语言模型推理 [译]
内容提要
文章介绍了一种分层推理技术,可在仅4GB显存的单GPU上运行70B大模型:按需从磁盘逐层加载Transformer层(每层约1.6GB),用完即释放;结合Flash Attention降低注意力内存、按层分片模型文件并用safetensors内存映射加速读取、借助HuggingFace元设备实现零内存加载。作者开源了AirLLM库,几行代码即可实现,已在16GB T4上验证显存占用不足4GB,但速度较慢,适合离线文档分析。
延伸解读
分层推理的代价:速度与适用场景
文章指出,分层推理虽然将显存需求降至4GB以下,但每层都需要从磁盘加载,而磁盘读取速度是整个推理过程的最大瓶颈。作者在16GB T4 GPU上测试,确认显存占用不足4GB,但速度较慢,不适合聊天机器人等实时交互场景,更适合离线文档分析或PDF处理。这意味着该技术以时间换空间,适用于对延迟不敏感、但硬件受限的任务。
不压缩模型:保持原精度的内存优化
文章强调,所介绍的内存优化技术不涉及量化、蒸馏或剪枝等可能损害模型性能的压缩手段。分层推理仅按需加载Transformer层,每层约1.6GB,配合Flash Attention降低注意力内存、按层分片模型文件并用safetensors内存映射加速读取,以及利用HuggingFace元设备实现零内存加载。因此,模型精度得以保留,但代价是推理速度受磁盘I/O限制。
训练与推理的内存需求差异
文章对比了训练与推理:推理时只需前一层的输出执行下一层,因此可分层执行;但训练需要前向传播保存各层结果用于反向传播计算梯度,分层执行并不能减少内存。作者提到梯度检查点等技术可降低训练内存,但未展开。这表明分层推理主要适用于生成任务,而非训练,读者需区分两者场景。
当前限制与开源实现
作者开源了AirLLMLlama2库,几行代码即可实现分层推理,但目前仅支持基于Llama2的模型。文章提到在16GB T4 GPU上验证显存占用不足4GB,但未提及其他硬件配置或模型规模下的表现。读者应注意,该技术依赖磁盘读取速度,且仅支持特定模型架构,实际部署前需评估自身硬件和模型兼容性。
Q&A
如何在只有4GB显存的GPU上运行70B大语言模型?
使用分层推理技术:按需从磁盘逐层加载Transformer层(每层约1.6GB),计算后立即释放内存;结合Flash Attention降低注意力内存、按层分片模型文件并用safetensors内存映射加速读取、借助HuggingFace元设备实现零内存加载。开源库AirLLM已实现,几行代码即可调用。
分层推理为什么能大幅降低GPU内存占用?
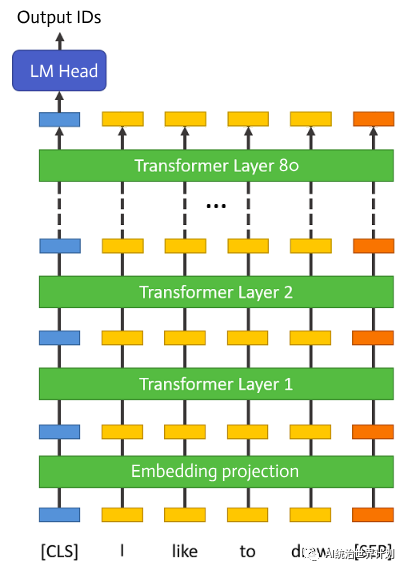
因为大语言模型推理时各层依序执行,每一层的输出是下一层的输入,同一时刻只有一个层在执行。因此无需将所有层保留在GPU内存中,只需按需加载当前层,计算完即释放。每层参数约占整个模型的1/80(70B模型约1.6GB),加上KV缓存等,总内存可控制在4GB以内。
Flash Attention在分层推理中起什么作用?
Flash Attention通过分块计算自我注意力,避免存储O(n²)的中间结果,将内存复杂度从O(n²)降至O(n),并优化CUDA内存访问以提升速度。这减少了注意力计算所需的内存,是整体内存优化的重要组成部分。
AirLLM库怎么用?需要多少代码?
安装:pip install airllm。然后导入AirLLMLlama2,用模型仓库ID或本地路径初始化,再像普通Transformer一样调用generate即可。示例代码仅需几行,支持Llama2架构模型。
用4GB GPU跑70B模型的速度和适用场景如何?
在16GB Nvidia T4上测试,显存占用不到4GB,但生成速度较慢。低端GPU不适合实时交互场景(如聊天机器人),更适合离线数据分析,例如文档分析或PDF处理。
分层推理技术能用于训练大模型吗?
不能。训练需要前向传播和反向传播,反向传播计算梯度时需要保存前向各层的结果,因此分层执行无法减少内存。但可以采用梯度检查点等其他技术来降低训练内存需求。
