本文讨论开源中国赴港上市传闻。其业务包括社区、Gitee代码托管及企业研发管理,收入更依赖企业客户。截至公开信息,港交所披露易与证监会备案公示均无对应文件,上市主体架构亦未明确。判断进展应以披露易、备案公示和工商信息为准,而非融资新闻或传闻。上市主要影响企业客户信任与经营透明度,而非产品功能。
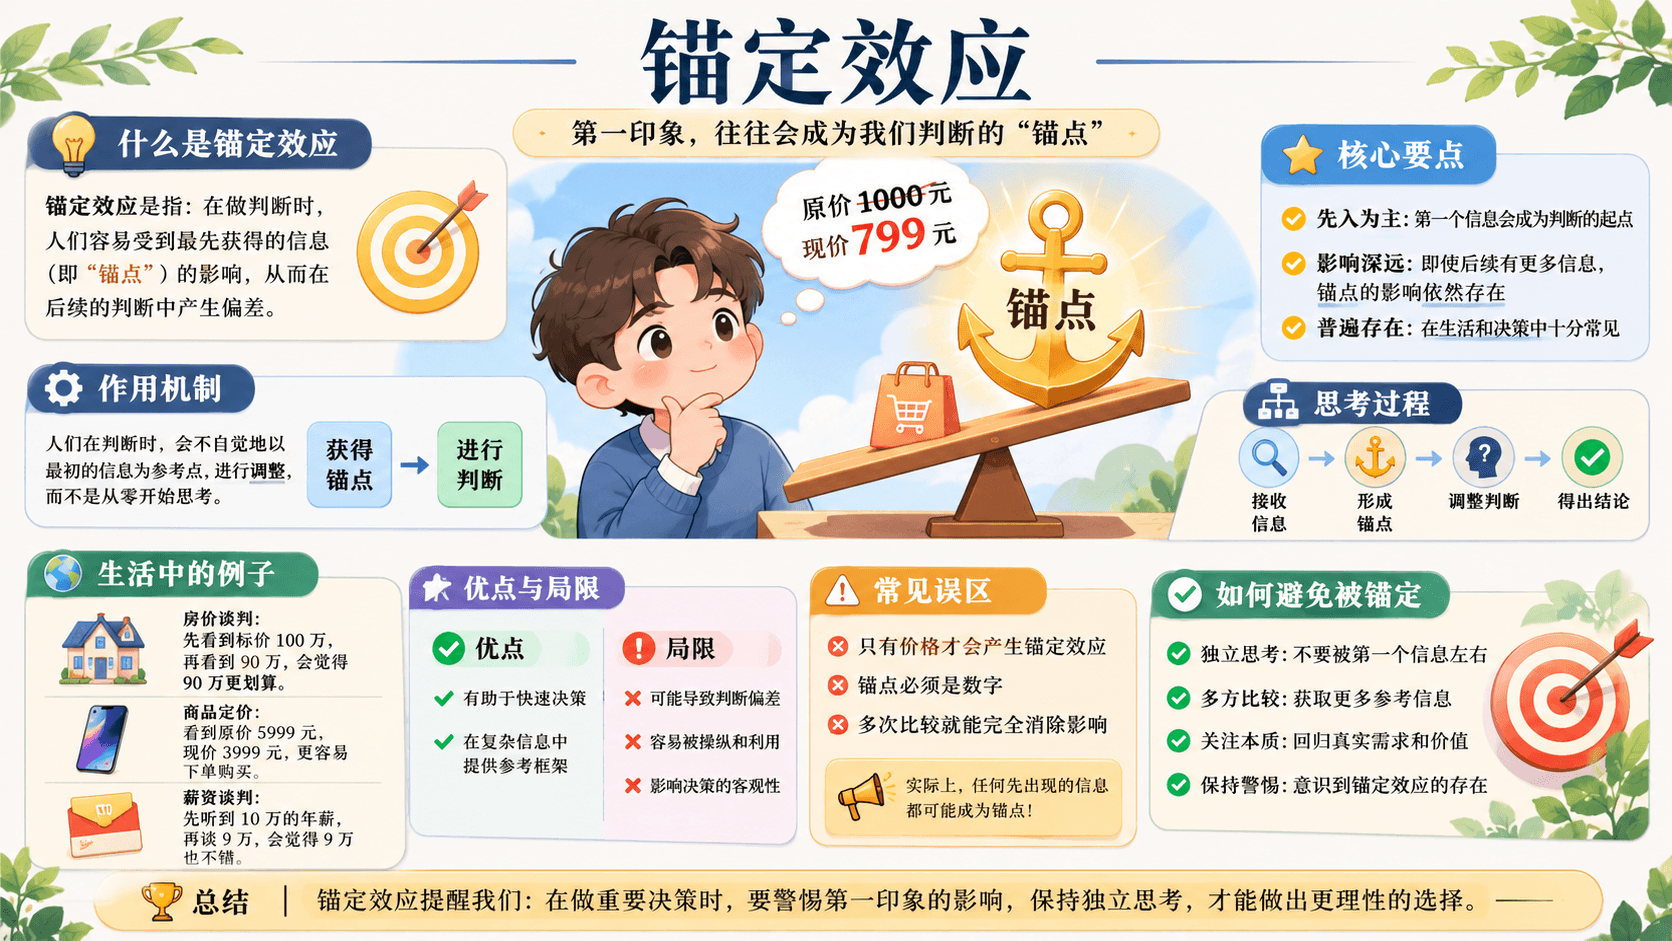
锚定效应是一种认知偏见,指人们决策时过度依赖最初接触的信息(锚点)。Tversky和Kahneman于1974年通过幸运轮实验首次证实随机数字也会显著影响人们的估计,其机制是调整不足和选择性确认,即使专家也无法免疫。该效应广泛应用于谈判、定价和薪资谈判,如亚马逊用标价制造折扣错觉。应对方法是接触外部数字前先形成独立判断,并质疑首个数字的相关性。
2026年选择研发效能度量平台,应优先评估以代码仓库为数据源、覆盖需求到发布全链路的一体化平台,而非先采购独立度量层,因为度量可信度取决于底层流程是否跑通。信通院与DORA数据均表明,工具普及不等于效能改善。度量读取代码提交、构建、发布等工程数据,区别于项目管理工具。选型需关注数据边界、部署合规与私有化运维能力。建议先落地5到8个核心指标服务复盘,避免铺全指标或挂钩个人绩效。
2026年选研发效能度量工具,关键在于数据源是否贴近代码与研发流程,Gitee等一体化平台能让数据从提交、评审到发布自然沉淀,度量更可信。选型应看自主可控与落地匹配度,而非功能数量。建议先理顺流程,从5至8个核心指标起步,避免指标过多、做成汇报工具或等同个人绩效。Gitee效能度量仍为beta版,适合研发人员占比高、代码集中的团队。
Anthropic推出AI助手Claude Duet,可监控已连接应用,在后台主动处理任务并判断优先级。公司用内部评分器测试其任务排序准确性,但承认紧迫性判断主观、评估不完美,Duet可能误读对话或误判紧急程度。Duet将执行与意图核查分离以防范提示注入,敏感操作需用户批准,部分操作不可撤销。后台检查每数小时一次,可能漏掉紧急事项,且计入订阅用量。目前仅限美国Pro和Max用户候补使用。
个人助手选型需关注三点:是否了解你、能否替你办事、数据存放何处。PocketClaw 为 U 盘便携方案,配置与凭证加密存于本地,但需联网调用模型,适合重视隐私且愿花时间部署的用户;云端产品更省事,但数据会经第三方服务器。选型应看账号生态重叠度与行动权限,加密不能替代备份,国际账号限制需按功能具体判断。
本文探讨IP网段重叠算法的工程实现,提出以IP前缀树替代二分法,实现最长前缀匹配,具备查找快、易动态更新的优势。通过统一业务属性池、连续内存存储和并发查询优化内存,大幅压缩千万级IP记录的内存占用,适用于高频IP业务碰撞场景。
本文延续IP区间重叠检测算法,讨论工程化中的两类特殊情况:一是IPv6转大整数后与IPv4量级不同,采用分治并行,分别建立IPv4和IPv6数轴;二是浮点运算精度丢失,将数轴最小单位由0.1改为1并等比例放大,修复IPv4/v6同轴遍历及IPv6精度问题。
提出一种IP重叠判断算法:将IP段映射到数轴,用扫描线算法处理CIDR嵌套继承,使小段自动继承大段业务标签。IP段用(start,end,length)三元组表示,采用u128结构避免溢出。通过维度聚合,将(ip,维度,值)排序后线性扫描,以O(N)复杂度完成标签继承与去重,可应用于攻击源IP匹配等场景,百万级/24段60秒内完成。
GitHub 动态工作流采用“确定性骨架+概率性节点”模式:用代码固定步骤、依赖、数据格式与审批点,仅将需判断的局部交给 Agent。该模式可重复执行、可观测、可控成本,并支持版本对比与测试。设计时需区分确定性工具、概率性判断和副作用节点,分别处理重试、超时与审批,适用于发布检查、事故研判等重复且失败代价高的任务。
Cloudflare开源了决策模型Clef,它不生成任何文本,而是像电路开关一样直接给出概率化判断,让AI智能体用38.8毫秒做决定! 一个决策模型的核心秘密在于,它把AI推理过程中最昂贵的环节——一个字一个字生成文本——整个砍掉了。Cloudflare在2026年10月1日发布了两款决策模
文章探讨IP网段重叠算法的工程实现:用IP前缀树替代二分法进行最长前缀匹配,查询快且支持动态更新;通过统一业务属性池将存储复杂度从O(M×N)降至O(N),节点连续内存布局提升读取速度;兼容IPv4/IPv6与并发查询,并可直接使用ClickHouse的ip_trie字典。
本文拓展IP重叠判断算法,将其用于业务维度碰撞,如筛选命中攻击事件的源IP。以128位结构表示IPv6,用(start,end,length)三元组描述IP段。针对CIDR嵌套继承问题,采用扫描线算法,将IP段拆为进入和离开事件,维护active集合,实现子段继承父段标签,复杂度O(N),可高效处理百万级IP段。
本文延续前篇IP数轴重叠检测算法,讨论工程化中的两类特殊情况:一是IPv6转大整数后与IPv4量级不同,浮点运算会丢失精度,故采用分治,分别建立IPv4与IPv6数轴并行处理;二是浮点误差问题,将数轴最小单位由0.1改为1,并对IPv6坐标等比例放大两倍,避免科学计数法导致精度丢失,从而修复两问题。
2026年9月,Jev、Laya等决策模型将“判断”从生成中剥离为独立基础设施:一次前向传播返回带概率的选项、分数或布尔值,答案空间预先锁定,并用RLCD训练校准置信度,高置信度自动执行、低置信度转人工。.NET生态随后跟进,出现NLaya、layar两个移植版,TensorSharp、Sezika两条原生路线,以及统一客户端SystemOneSharp。OpenClaw.NET的PR #246与#255演示了接入生产所需的校准、影子模式、回滚等护栏,最终收敛为纯.NET技术栈。核心规律:成本优势上限等于弃权率的倒数。
TypeSafe的Jev模型通过单token输出概率分类,速度快、成本低,被Vercel AI Gateway率先采用。其底层logprobs技术并不新颖,已有六个团队复刻,OpenAI也在工具调用中使用类似机制。Jev的真正优势在于训练数据与概率校准。OpenAI可能将分类能力直接整合进主力模型推理,实现零延迟判断并扩展至多模态。TypeSafe的生存取决于其数据工程深度。
Thorsten Ball 提出 16 条判断:代码审查、单元测试和终端将消亡,写代码的手艺贬值,工程师价值转向理解业务与判断取舍;“好代码”共识可能崩塌,Token 成为新计算范式,PM、设计、工程三角瓦解,小团队优势扩大,UI 将实时生成。他强调变革需一代人时间。
AI是能力杠杆,而非认知替代品:它降低了公开知识获取与代码执行的成本,但知识生产、判断、验证和责任依然昂贵。瓶颈已从“做出来”转向“证明对”,验证与怀疑变得更稀缺。人应退出低价值执行,保留目标、判断与最终控制权,并主动寻找反例,避免自我合理化。
TypeSafe AI 于2026年9月发布模型 Jev,仅做判断,通过 Choice、Score、Noul 三种原语直接返回类型化结果与概率,同一请求中的多问题可并行求值,以降低延迟与成本。作者用六条中英文样本实测,验证了意图区分与概率输出,但指出官方“快193.6倍”等数据来自其自身评测,未独立复现,且中文能力弱于英文,需自行验证。
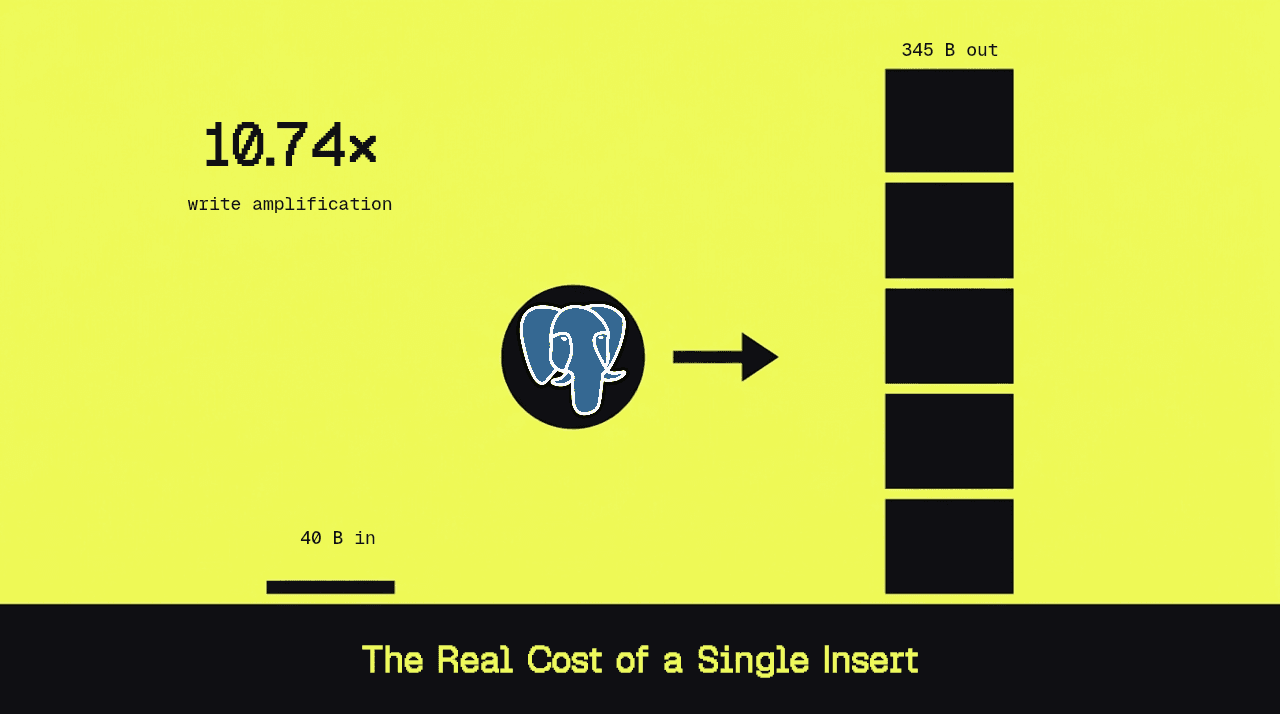
PostgreSQL单次插入的真实成本受写入放大影响,索引会成倍增加WAL日志量。可通过测量表上的WAL体积,并采用四种无需修改模式的方法来降低开销。
完成下面两步后,将自动完成登录并继续当前操作。