本文介绍Neki数据库系统的计划外故障转移设计:主库P失联时,Admin不单凭自身健康检查判断,而是询问各副本;若仍有副本在流式复制则不切换,仅当至少一个可达副本报告复制中断且无相反证据时才判定P死亡。切换前断开副本连接以防P恢复后重新获得副本,并冻结各副本WAL位置;随后选择已重放最高WAL位置的副本提升为新主库,其余副本可顺利跟随。P被标记为TEARDOWN,保留用于事后分析。
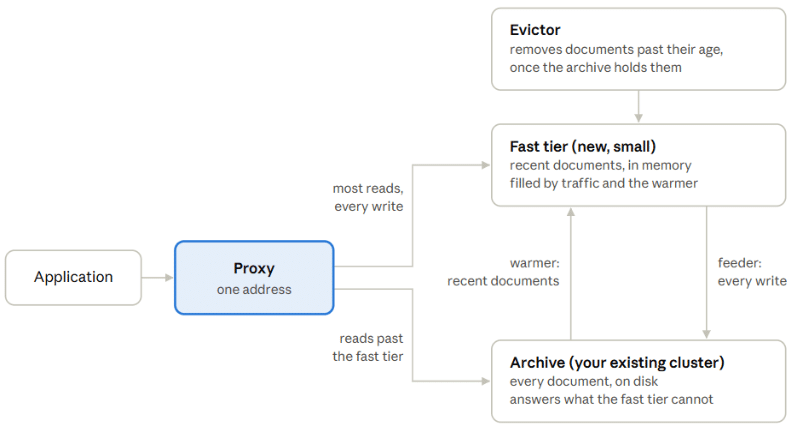
文章介绍MongoDB存储分层方案Thermocline:保留现有副本集作为归档层,前置小型快速副本集存放近期数据,应用通过代理连接,按数据年龄决定存储层。测试中吞吐量提升1.6至5.2倍,读延迟p95从86毫秒降至6毫秒,且无需分片或修改应用。该方案为概念验证,尚未用于生产。
Polar Proxy 提出一种在 PostgreSQL 事务内安全分流只读语句的方案:事务仍保留在主库,只读语句借用副本连接执行。该方案仅适用于读已提交隔离级别、WAL 已刷盘且不含锁子句的顶层 SELECT。通过导入事务 XID 并等待副本回放至目标 LSN,确保能读到事务自身的写入及此前已提交的数据。副本连接在事务期间保持复用,事务结束后才归还;副本故障时按策略重试或回退主库。
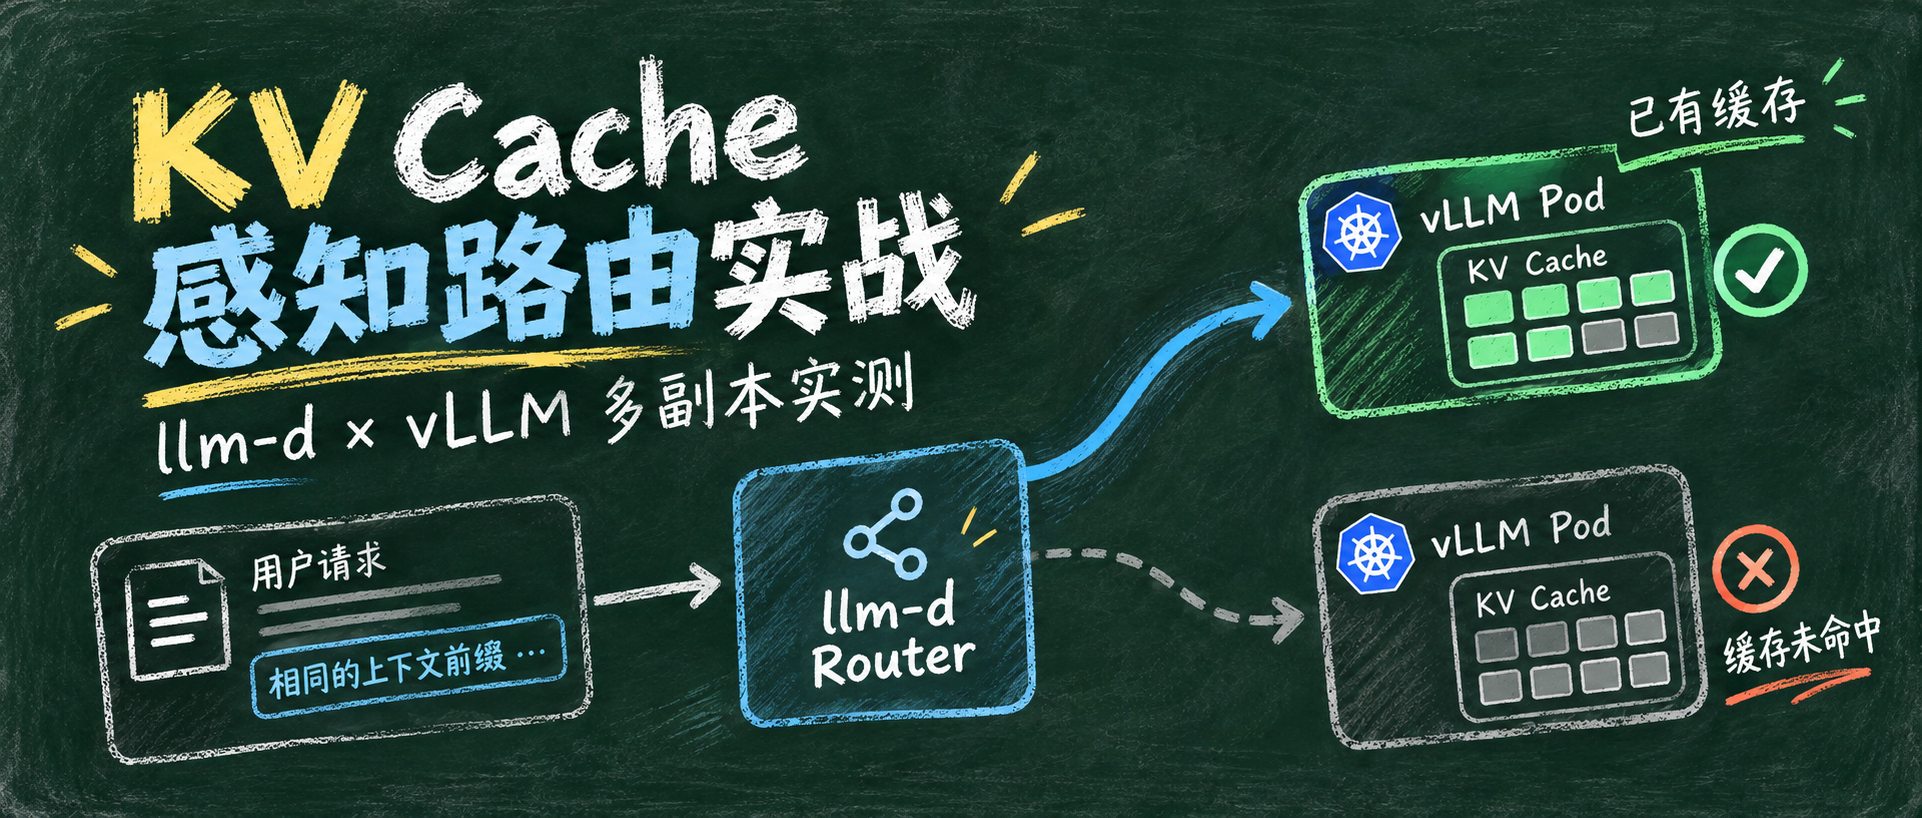
文章探讨多副本vLLM部署中KV Cache的复用问题:单实例APC仅能本地复用缓存,多副本需路由配合。llm-d Router通过近似前缀记录、评分与选点,将请求优先发往可能已有缓存的实例。实验对比随机路由与前缀感知路由,后者使后续请求100%回到原副本,前缀命中率由56.56%升至99.60%,Prefill token均值由2261.5降至21.0,TTFT P95由2018ms降至159.2ms。
PlanetScale的分片Postgres服务Neki预览版发布一个月,新增只读副本和低至每月50美元的小型Metal实例。工程团队合并超650项改动,重点提升查询层:支持更多SQL语法、标准工具导出、批量写入提速(分布式INSERT SELECT约76倍、COPY约5倍),并新增分布式执行计划查看。此外还支持Terraform管理扩展、Azure区域部署、分支指标接入MCP。
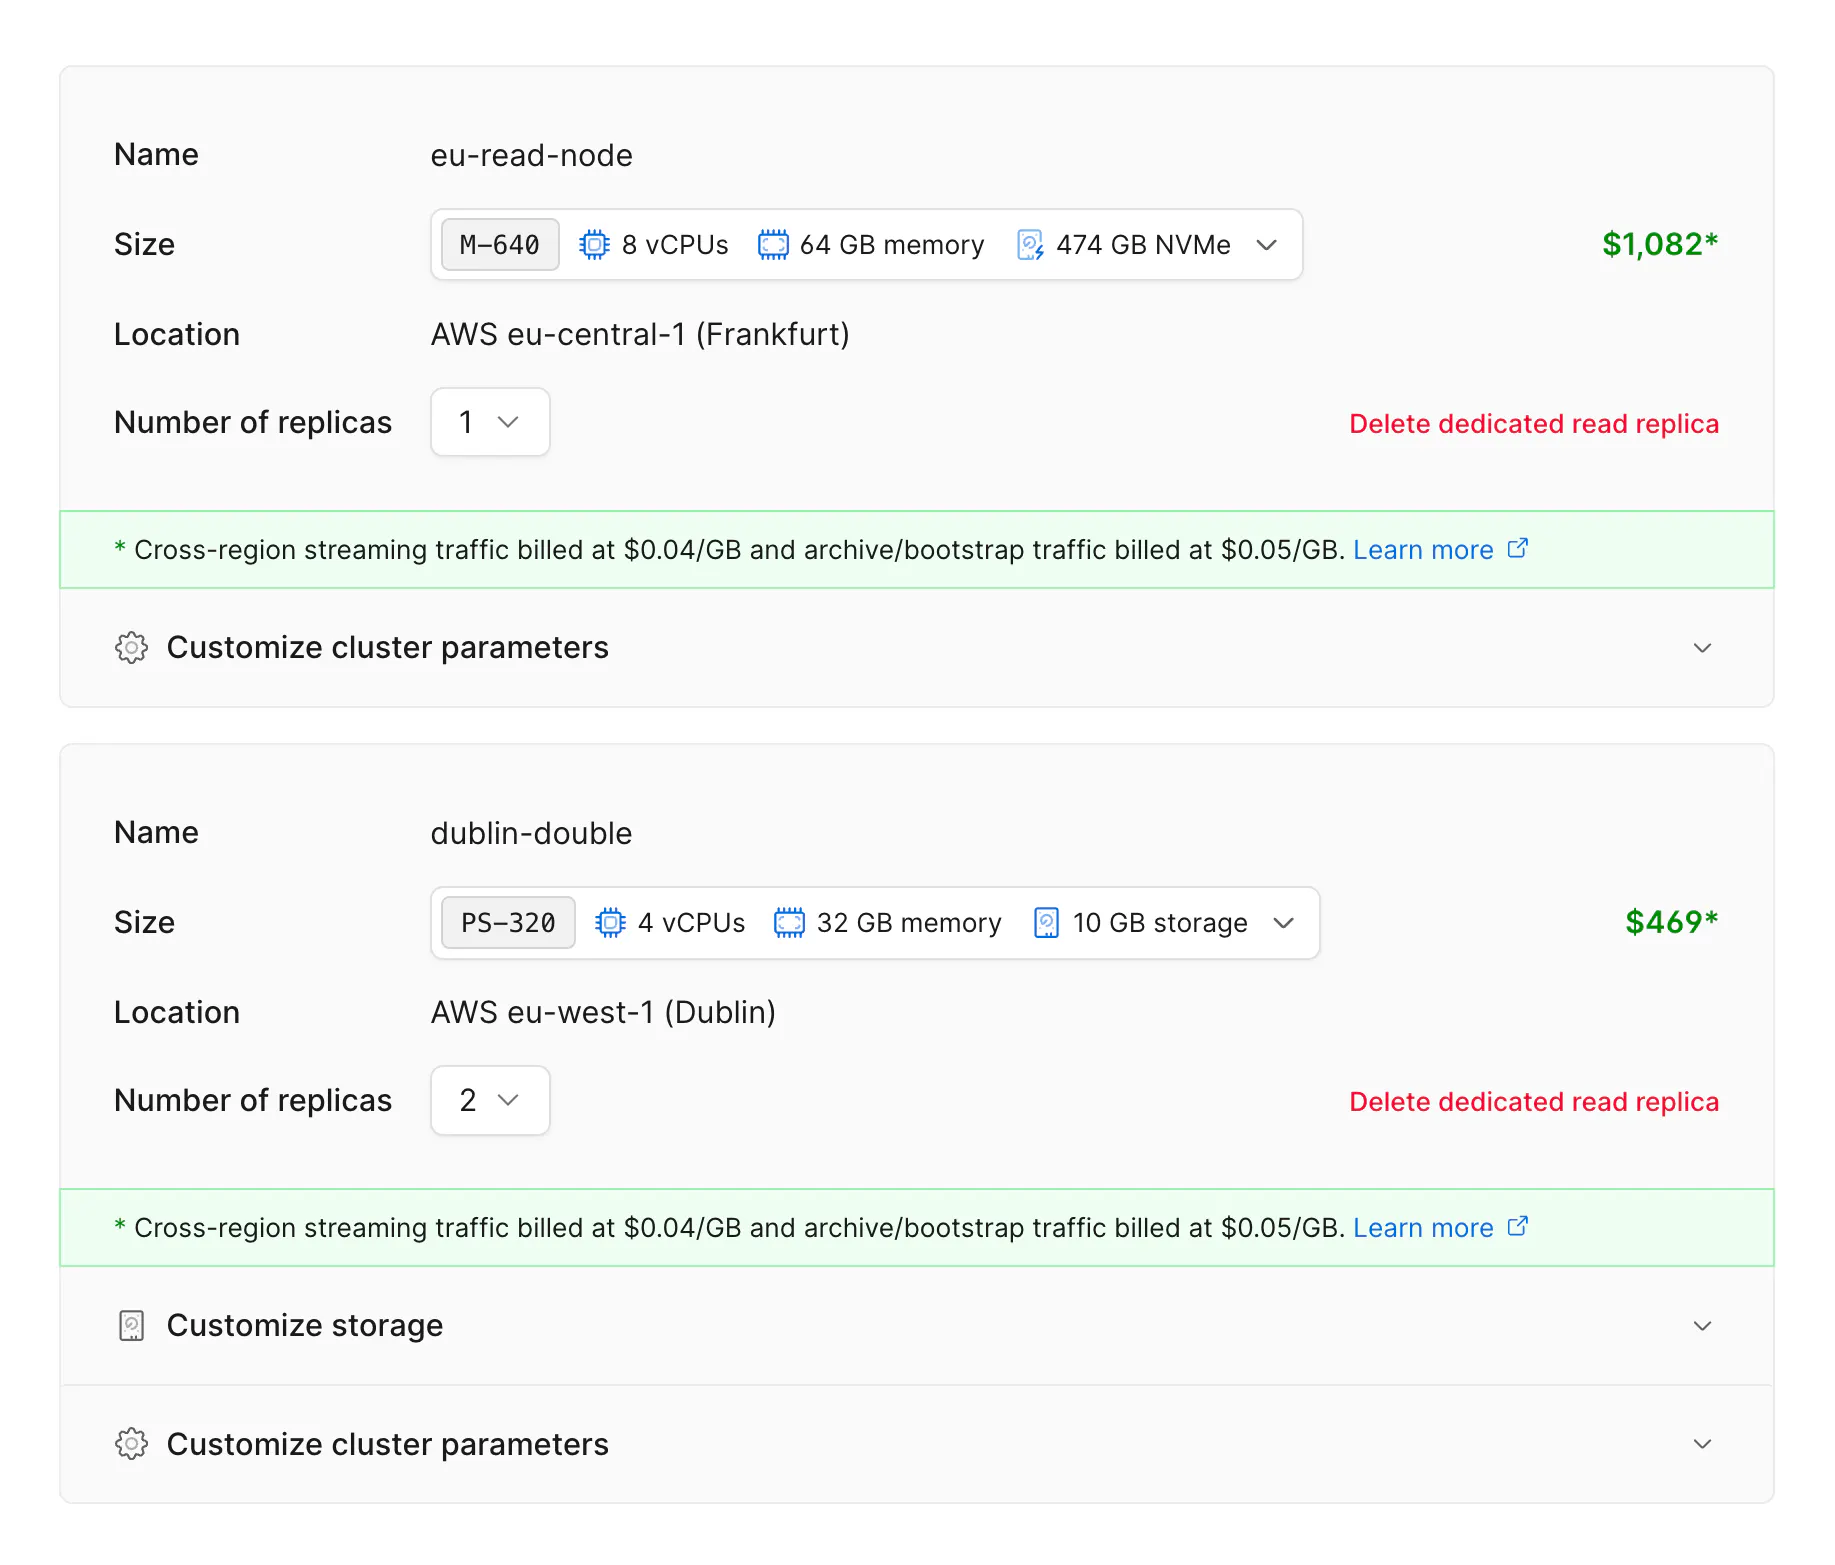
PlanetScale 推出 Postgres 专用只读副本,支持异步复制主集群。用户可通过仪表盘、API 或 CLI 创建和管理,并独立配置实例大小与磁盘。该副本可降低全球用户的读取延迟,也能在同一区域内分流向量搜索、分析等查询,避免影响生产。
本文介绍Elasticsearch的基本概念与指标:近实时搜索延迟约1秒;集群由多节点组成,统一进行索引和搜索;节点是集群中的服务器;索引是相同特性文档的集合;文档是最小索引单元,以JSON表示;分片用于突破单机存储限制,副本保障可用性;fielddata用于文本字段内存查询;doc values支持高效聚合;norms存储评分因子;召回率衡量查全,准确率衡量查准。
测试环境ES因索引分片过多、副本多且磁盘性能差,导致单机IO打满、查询超时。优化建议:改用SSD,分片减至2个,副本减为1,并引入Tair缓存,让ES仅处理复杂查询以减轻压力。
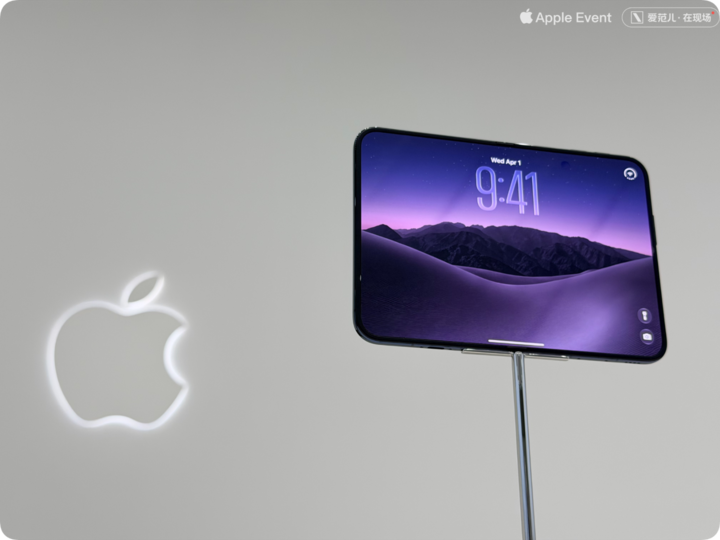
苹果推出折叠屏iPhone Duo,重点不在抢首发,而在解决折痕、屏幕适配与交互割裂。其内外屏采用√2比例以保持空间秩序;显示结构用十层材料、钛板与胶层分担折叠应力,降低折痕可见性。铰链角度成为系统输入,C2自研基带实现端到端能效控制。苹果意在让用户忘记自己正在使用折叠屏。
Percona博客近期发布多篇技术文章,涵盖Stefan Fercot加入Percona的缘由及其在Percona Live Amsterdam大会上的亮相,MySQL的OpenID Connect认证现已完全开源,以及关于PostgreSQL供应商锁定风险的探讨。
Percona公司博客近期发布多篇技术文章,包括Stefan Fercot加入Percona的缘由及其在Percona Live Amsterdam大会上的亮相,MySQL的OpenID Connect认证现已开源,以及探讨PostgreSQL供应商锁定风险。
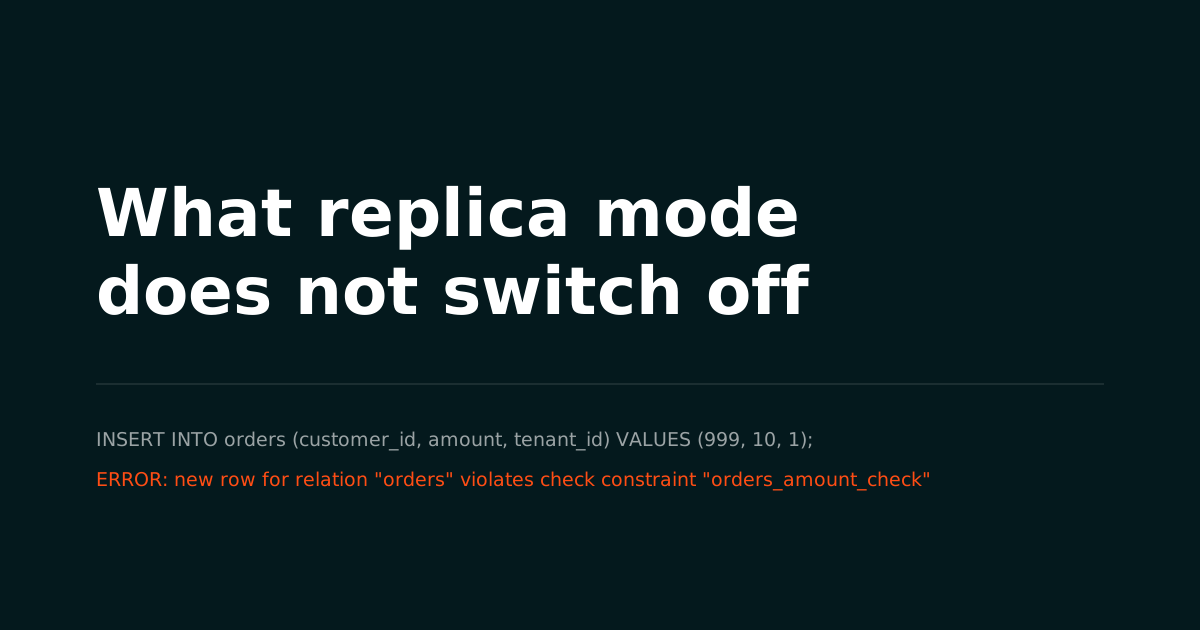
本文探讨PostgreSQL中三种绕过外键约束的方法:`session_replication_role=replica`仅关闭外键等触发器,但CHECK、NOT NULL等仍生效;`DISABLE TRIGGER ALL`需超级用户,影响全局且不检查数据;`NOT ENFORCED`(PG18+)可单约束关闭,重新启用时会扫描数据。三者均不绕过行级安全,各有适用场景和风险。
数据库写入速度的“成功”定义决定数据安全:内存写入最快但断电即失,本地SSD需刷盘但丢主机风险高,对象存储慢但更稳,三副本最慢但最可靠。性能与可靠性是权衡,低延迟常以数据丢失风险为代价,选型时需细查“成功”标准。
TiKV 通过 Raft Snapshot 解决副本落后问题,允许副本直接从 Leader 同步,避免日志重放开销。日志 GC 定期清理不再需要的日志,确保副本正常追赶。TiKV 支持 Voter、Learner 和 Witness 三种副本形态,以提高系统容错能力和存储效率。
本文探讨了Elasticsearch 8.x中的索引、主分片、副本及其与Lucene的关系,强调了分片数对集群状态更新的影响,主分片和副本的读写机制,以及通过哈希路由优化数据分布的重要性,最后讨论了分片规划的重要性,以避免过多分片导致的性能问题。
Redis 的异步复制模型可能导致副本读取到旧数据。主库通过 replication.c 向副本广播命令,副本在断连期间仍可提供陈旧数据。配置参数如 repl-backlog-size 和 replica-read-only 会影响复制行为。理解这些特性有助于优化 Redis 的使用和故障处理。
本文讨论了Milvus 2.6.x版本的内存副本、流服务和数据处理架构。内存副本允许在多个查询节点加载同一段,提高性能和可用性。流服务支持WAL迁移,确保写路径的可用性。通过协调段分布和负载均衡,优化查询和写入性能。文章还探讨了副本的成本和工程间隙,并提出未来的开放问题。
本文对比了Milvus 2.6.x与Qdrant在向量检索引擎中的架构和部署方式。Milvus强调存算分离,采用多组件架构,而Qdrant则提供单节点的简化部署,适合中小规模应用。两者在分布式部署、数据过滤和扩展性方面存在显著差异,选择时需考虑团队需求和运维复杂度。
本文讨论了Kafka 3.x(KRaft模式)中的副本与消费组的工程语义,包括Leader、Follower、ISR、HW、LEO的定义及作用。介绍了producer的ack配置对数据持久性的影响,以及consumer group的分配策略和rebalance过程。强调了offset提交模式与Flink的checkpoint机制的区别,指出两者在数据恢复中的不同角色,并提供了Kafka副本和消费组的最佳实践建议。
文章讲述了一个软件开发团队将私有代码库转变为公开工具包的过程。他们解决了历史遗留问题,如删除过大的文件和修正错误的调用。团队意识到构建与理解是两个不同的过程,决定在夜间进行构建,白天进行理解和修正。最终,项目获得了新的地址,标志着其可以被广泛使用。
完成下面两步后,将自动完成登录并继续当前操作。