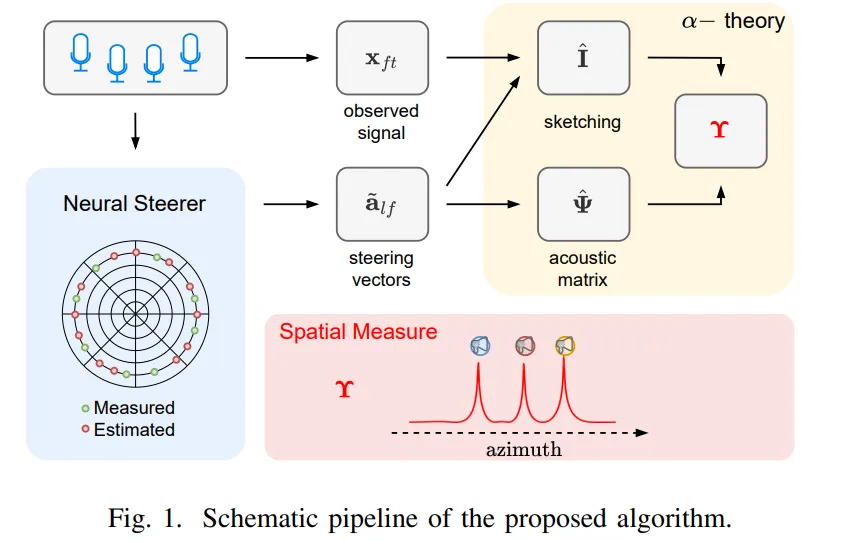
声源定位(SSL)在增强听觉和自动驾驶等领域应用广泛。日本理化学研究所提出的新型混合技术SHAMaNS,结合α稳定模型与神经网络,成功解决了稀疏测量和噪声鲁棒性问题。实验结果显示,SHAMaNS在多声源场景中表现优异,适应能力强,未来计划扩展至三维定位。
移远通信推出端云混合大模型机器人大脑解决方案,结合AI与声源定位技术,提升机器人交互能力。端侧大模型实现毫秒级响应,云端提供实时信息和多轮对话。通过智能路由和多麦克风阵列,增强机器人的听觉,成为理解与沟通的智慧伙伴。
该论文提出了一种新的声学嵌入方案sound-word2vec,应用于文本检索和电影制作等任务。研究探讨了无监督神经网络模型在语音与图像的语义关联,提出了基于双流网络的算法用于声源定位,并通过自监督学习提升性能。此外,介绍了Spatial LibriSpeech数据集用于训练模型,展示了在声音景观映射和跨模态检索中的优越表现。
本文介绍了一种新颖的无监督学习算法,通过声音和视觉场景定位声源。研究提出了多种方法,包括基于双流网络的半监督学习、迭代对比学习框架和自监督预测学习,均在声音定位任务中表现优异。False Negative Aware Contrastive方法有效解决了错误负样本问题,提升了定位准确性。最新的Tri-modal joint embedding模型展示了在多源混合中分离音视源的能力,具有良好的零-shot迁移性能。
本文探讨了结合盲音频录音与3D场景信息进行新视角声学合成的优势。通过2-4个麦克风的录音和场景的3D几何及材料信息,估计场景中的声音。主要挑战包括声源定位、分离和去混响。研究表明,利用3D重建的房间脉冲响应(RIR)显著提高合成质量。模型在Matterport3D-NVAS数据集上表现优异,声源定位准确率接近完美,声源分离和去混响的PSNR和SDR指标优于现有方法。
本研究提出了一种基于双流网络的无监督算法,用于在视觉场景中定位声源,并通过半监督学习修正误差,增强算法的可靠性。研究还介绍了神经声学场(NAFs)和SoundSpaces 2.0平台,以提高声源定位和音频-视觉分离的效果。实验结果表明,该方法在性能上优于现有技术。
本文提出了一种跨模态对齐任务,旨在提高音频和视觉模态的交互,增强声源定位和跨模态检索的性能。研究开发了音频-视觉空间整合网络和无监督算法,利用空间线索和递归注意机制,提升声源定位的准确性和可靠性。实验结果表明,该方法在多个数据集上优于现有技术。
本文提出了一种结合物理和机器学习的方法来分析声学信号,主要包括贝叶斯推断、神经物理模型和非线性最小二乘法。该框架在模拟数据上验证了其有效性,特别是在受限环境中的声源定位,F1得分达到0.786。
本文提出了一种基于3D高斯扩散的新视角合成方法,结合可微渲染框架和空间注意力模块,提升了渲染质量和速度。通过音频与3D场景信息结合,解决了声源定位和分离问题,取得了优异的声学合成效果。此外,FSGS方法实现了实时高质量视角合成,MVSGaussian方法有效重建未见场景,展现出良好的综合性能。
本文研究了多种基于神经网络的模型,旨在提高地下水污染、声源定位和空气质量预测的准确性。通过结合物理知识与深度学习,提出了新方法如AirPhyNet和流导向定位,显著提升了预测精度和模型的泛化能力。
本文介绍了一种名为EZ-VSL的无监督音频-视觉源定位方法,旨在识别视频中的声源。该方法通过对齐音频和视觉信息,显著提高了定位精度,CIoU指标从76.80%提升至83.94%。研究还探讨了自监督学习、音频-视觉类别权重及新数据集,展示了在声源定位方面的优越性能。
本文综述无人机感知与自主飞行技术,涵盖多微型飞行器协同动作捕捉、学习型导航滤波器、ICA声源探测、模仿学习避障、卷积网络端到端避撞、MAV检测、多任务故障分类、单目SLAM导航以及麦克风阵列声源定位与跟踪。
该文综述音频深度网络可解释性研究,涵盖解释器设计、LRP分析、音乐自动标注、FocalNet视觉建模、时间特征调制、COVID-19检测、声源定位及GAN生成解释等方法,涉及分类、检测与音视频任务,强调解释性与性能的权衡。
该文介绍了一个跨模态对齐任务,以促进音频和视觉模态之间的交互学习,实现了声源定位和跨模态检索的高性能和语义理解。
完成下面两步后,将自动完成登录并继续当前操作。