谷歌发布开源轻量多模态嵌入模型 EmbeddingGemma 2,基于 Gemma 4 架构,7.4 亿参数,Apache 2.0 许可。该模型首次将文本、图像、音频、视频统一映射到同一嵌入空间,支持端侧运行,文本模式最低约 191MB 内存。其采用模块化设计,支持向量维度动态截断,存储最多减少 6 倍,上下文窗口扩至 8K,代码性能显著提升,适用于本地搜索、RAG 与多模态检索。
谷歌发布开源多模态嵌入模型EmbeddingGemma 2,参数7.4亿,可将文本、代码、图像、视频和音频映射到同一768维向量空间,无需预生成字幕或转录。模型基于Gemma 4,采用Apache 2.0许可,支持端侧部署,上下文窗口8192 token。借助Matryoshka技术,向量可截断至256或128维,节省存储的同时多模态检索质量仍保持约95%。
谷歌发布EmbeddingGemma 2,基于Gemma 4架构,7.4亿参数,采用Apache 2.0许可。该模型首次将文本、代码、图像、视频和音频统一到同一嵌入空间,支持端侧多模态检索。文本任务仅需2.7亿参数,输出向量可压缩至128维,存储减少6倍。在Pixel 11 Pro上,纯文本仅占约191MB内存。支持8K上下文,可处理5.5分钟音频或29张图像,适合离线隐私检索与RAG。
谷歌推出了Gemini Embedding 2,旨在帮助开发者和企业利用多模态嵌入技术提升项目智能。Gemini API和Vertex AI的正式发布将支持这些多模态项目的生产应用。
谷歌发布了Gemini Embedding 2,这是首个原生多模态嵌入模型,能够将文本、图像、视频和音频映射到3072维向量空间。音频嵌入以固定长度的向量表示,捕捉声音的语义内容,实现跨模态检索。研究显示,模块组合方法在小模型中表现优异,音频嵌入在智能系统、实时监控和多模态工作流中有广泛应用。
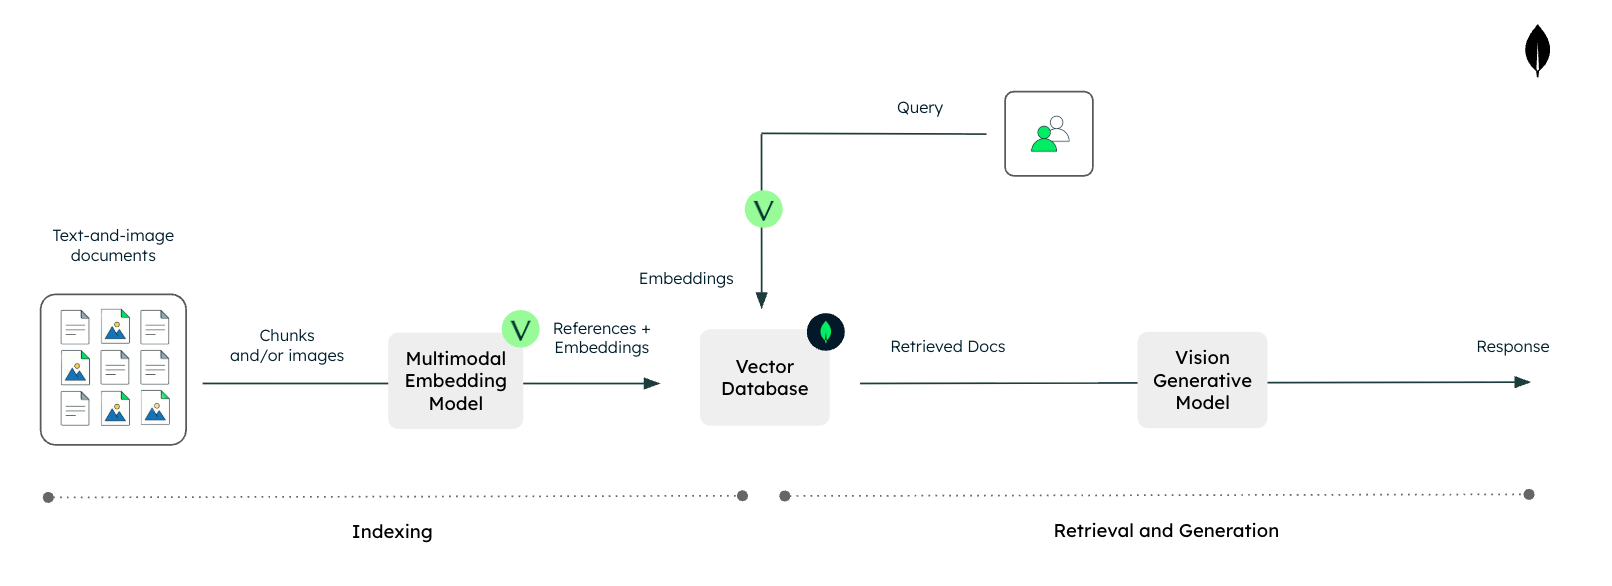
Vision RAG是一种新型的信息检索和生成技术,能够高效处理复杂文档中的文本和图像。它通过多模态嵌入模型直接索引整个文档,避免了传统OCR的低效和高成本,提升了企业数据的搜索和分析能力,并能从图表和图像中提取关键信息。
本方案利用Amazon的Nova多模态模型,实现视频高光识别与剪辑。通过视觉-语言模型(VLM)理解视频,输出高光片段时间点,并结合多模态嵌入模型(MME)进行语义匹配,以提高识别准确性,适用于多种视频场景。
jina-embeddings-v4推出了先进的多模态嵌入,支持文本、图像和复杂文档的向量搜索。通过修改llama.cpp,实现了多模态嵌入的生成,解决了图像处理和注意力机制的问题。调试后,llama.cpp模型的嵌入结果与参考模型相近,未来可优化视觉编码器和支持多向量嵌入。
本文讨论了在Databricks上实现多模态嵌入模型的过程,重点在于如何处理医疗领域的结构化和非结构化数据。通过生成嵌入和创建向量搜索索引,用户能够高效检索和分析不同类型的数据。文章还介绍了使用开源模型和DSPy框架来简化数据处理和查询的步骤。
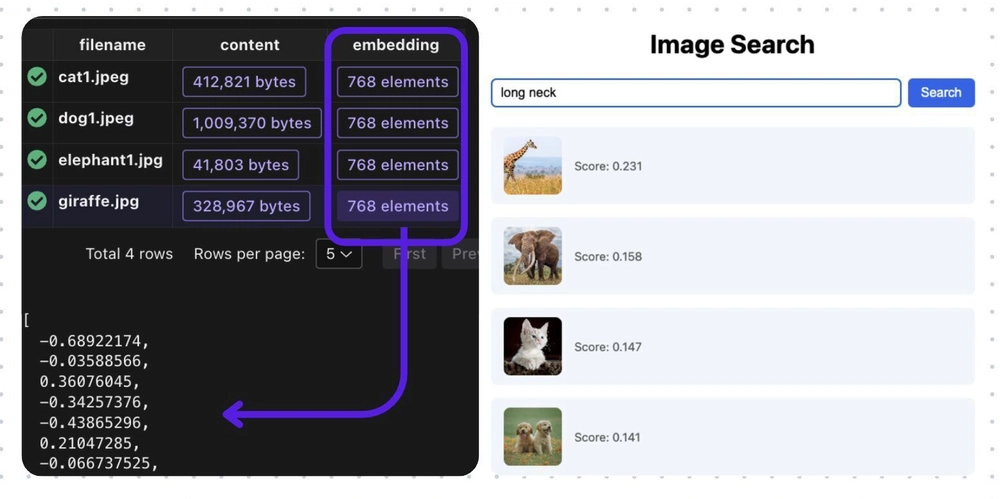
本文介绍了如何构建一个实时图像搜索系统,用户可以通过自然语言查询图像。该系统使用多模态嵌入模型和CocoIndex框架处理图像并建立向量索引,利用CLIP模型生成图像嵌入,Qdrant数据库存储嵌入,FastAPI构建API接口,实现语义搜索功能。
本文介绍了如何利用Amazon Bedrock和AWS服务,将视频和音频内容转化为可搜索的向量表示。通过提取视频帧、生成多模态嵌入和语音转文本等步骤,构建了一个支持自然语言查询的应用,实现高效检索视频中的特定时刻。
本文介绍了如何利用Amazon Bedrock、Transcribe和Aurora PostgreSQL将视频内容转化为可搜索的向量,通过提取视频帧和音频转录生成多模态嵌入,实现自然语言查询,支持图像和文本检索,提升用户体验。
本研究提出了一种新颖的A-MESS框架,旨在改善多模态意图识别中的模态间联系和意图语义表示。通过引入基于锚点的多模态嵌入和语义同步策略,该框架优化了多模态表示,并在实验中显示出显著效果。
2024年信息检索(IR)将迎来重大变革,深度学习和大型语言模型(LLMs)推动从传统关键词匹配向智能检索的转变。检索增强生成(RAG)技术的成熟使其在企业搜索和知识管理等领域得到广泛应用。未来,RAG、多模态嵌入和AI基础设施将继续推动创新。
本文介绍了一种新颖的无监督学习算法,通过声音和视觉场景定位声源。研究提出了多种方法,包括基于双流网络的半监督学习、迭代对比学习框架和自监督预测学习,均在声音定位任务中表现优异。False Negative Aware Contrastive方法有效解决了错误负样本问题,提升了定位准确性。最新的Tri-modal joint embedding模型展示了在多源混合中分离音视源的能力,具有良好的零-shot迁移性能。
本文提出了一种新方法,通过音频生成高质量图像,利用音频编码器和多模态嵌入空间进行图像操纵。该方法在零样本音频分类和语义图像分类上优于现有技术,显示了声音与图像之间的良好关系,并探讨了声音景观映射和视觉诱发音频生成,取得了显著效果提升。
本文综述多模态言论与情感分析研究,提出条件因式分解基线,将言论分解为单、双、三模态因子,通过加权平均获得嵌入,推理速度较神经模型快十倍。相关研究涵盖EffMulti情感框架、JM3D三维表示、双人对话建模、社交媒体实体识别及视频标题一致性检测,均验证了跨模态融合的有效性。
完成下面两步后,将自动完成登录并继续当前操作。