小红花·文摘
  • 首页
  • AI Tokens🪙
  • 排行榜🏆
  • 直播
  • FAQ
Dify.AI
沉浸式翻译 immersive translate

大语言模型易产生幻觉,检索增强生成(RAG)通过外部知识降低错误。但标准RAG流程线性、仅单次检索,难以应对多步推理、跨文档综合等复杂查询。Agentic RAG将模型变为自主推理引擎,形成“规划—执行—评估—循环”,具备查询路由、查询分解、自我反思与工具调用四种机制。简单查询宜用标准RAG,复杂高精度场景宜用Agentic RAG,也可混合使用。

Agentic RAG 与朴素 RAG:当你的检索系统应当自主思考时

KDnuggets KDnuggets · 2026-10-16T14:00:00Z

Gemini 3.8 Flash是谷歌最智能的主力模型,在软件工程、智能体任务和复杂多步推理上较3.7 Flash显著提升,性能接近更昂贵的前沿模型。其核心设计是“更努力”:面对复杂任务时执行更多推理步骤并迭代调用工具,输出更准确。社区已用它制作卫星轨道模拟、日式海浪动画、3D恐龙骨架和自动变速器交互模型。

看看4位开发者用Gemini 3.8 Flash打造了什么

The Keyword The Keyword · 2026-09-28T16:00:00Z

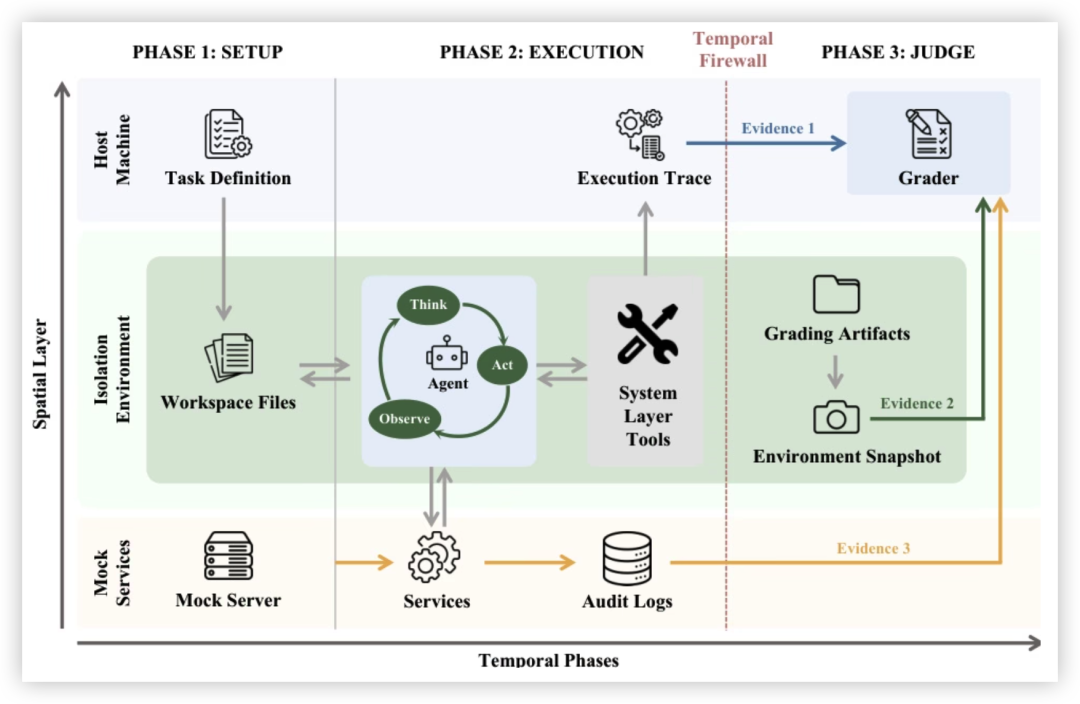
AI代理评估比单轮LLM更难,因多步推理与工具调用会累积错误。应分层评估推理、行动与执行结果,使用清晰可测任务和匹配的评分器(确定性、代码、模型、人工)。保持环境隔离、多次试验,关注pass@k与pass^k,并阅读对话记录。将评估自动化接入开发流程,结合监控形成持续反馈闭环。

如何为AI代理构建有效的评估

KDnuggets KDnuggets · 2026-09-16T12:00:50Z
Gemini 3.8 Live与Extended Thinking发布:Google把语音模型劈成两半

2026年9月15日,Google发布Gemini 3.8 Live与Extended Thinking两款语音模型,分别主打低成本对话与多步推理。后者语音质量指数82.6分居首,但真实客服任务完成率仅68.6%,银行场景更低至35.1%,暴露语音智能体在工具调用、多语言识别与治理上的共同瓶颈。

Gemini 3.8 Live与Extended Thinking发布:Google把语音模型劈成两半

极道 极道 · 2026-09-15T21:45:00Z
Gemini 3.8 Live 模型现已上线 AI Gateway

谷歌Gemini 3.8 Live与Extended Thinking已上线AI Gateway。Live支持实时音频、视觉定位、97种语言自动切换及后台工具调用;Extended Thinking增加与语音并行的多步推理,可边回应边播报进度。两者均可通过AI SDK实时API接入,需安装Gateway提供商和WebSocket客户端,获取短期令牌后连接使用。

Gemini 3.8 Live 模型现已上线 AI Gateway

Vercel News Vercel News · 2026-09-15T00:00:00Z
数据集汇总丨AI Agent 评测数据集,Microsoft/北大/港大/上海交大等发布 10 个数据集,从长程记忆到真实环境任务执行全覆盖

AI Agent 正在从对话工具转变为任务执行者,广泛应用于自动化办公和代码生成等领域。与传统大语言模型不同,Agent 能够拆解任务并自主推进。为支持其能力,相关数据集强调过程能力,包括长程规划和多步推理。本文整理了10个关键数据集,涵盖长上下文理解、任务规划和工具调用等能力,推动 AI Agent 的研究与应用。

数据集汇总丨AI Agent 评测数据集,Microsoft/北大/港大/上海交大等发布 10 个数据集,从长程记忆到真实环境任务执行全覆盖

HyperAI超神经 HyperAI超神经 · 2026-07-06T11:01:54Z
人工智能论文评审:链式思维提示激发大型语言模型的推理能力

大型语言模型在多步推理任务中的表现有限。研究提出了“链式思维提示”,鼓励模型展示推理过程后再给出答案,从而显著提升推理能力。这一方法无需额外训练,适用于算术、常识和符号推理任务,尤其在大型模型中效果显著。研究表明,适当的提示可以激发推理能力,改变了对语言模型推理的理解。

人工智能论文评审:链式思维提示激发大型语言模型的推理能力

freeCodeCamp.org freeCodeCamp.org · 2026-06-15T22:43:25Z
谷歌的代理开发工具包是什么?架构巡礼

谷歌的代理开发工具包(ADK)通过事件驱动架构改变了AI应用的开发方式,支持多步推理和实时反馈。ADK的设计确保可观察性、测试隔离和灵活性,使开发者能够构建复杂的AI系统。

谷歌的代理开发工具包是什么?架构巡礼

The New Stack The New Stack · 2025-12-15T15:30:10Z
R-HORIZON:探索长程推理边界,复旦NLP&美团LongCat联合提出LRMs能力评测新框架

大型推理模型(LRMs)在长链推理能力上面临挑战,现有评测体系无法有效评估其复杂任务表现。复旦大学与美团推出的R-HORIZON框架通过问题组合方法提升了模型的多步推理能力。评测显示,主流模型在长链推理中性能普遍下降,存在推理长度、反思机制和预算分配等瓶颈。通过强化学习训练,R-HORIZON显著提升了模型推理性能,标志着研究范式的转变。

R-HORIZON:探索长程推理边界,复旦NLP&美团LongCat联合提出LRMs能力评测新框架

美团技术团队 美团技术团队 · 2025-11-28T00:00:00Z
如何通过知识图谱解决5个常见的检索增强生成(RAG)系统失效问题

标准的检索增强生成(RAG)系统在处理复杂问题时常常失效,无法保持上下文关系。本文提出了一种基于知识图谱的解决方案,通过明确的节点和边存储数据,增强系统推理能力,有效应对多步推理、歧义消解和矛盾信息,提高知识系统的可靠性。

如何通过知识图谱解决5个常见的检索增强生成(RAG)系统失效问题

freeCodeCamp.org freeCodeCamp.org · 2025-11-13T15:20:24Z
《Agentic Design Patterns:构建智能系统的实战指南》- 第一章 提示链

提示链模式通过将复杂任务分解为小的子任务,提升了大语言模型的可靠性与可控性,适用于构建智能体系统,解决多步推理与工具集成问题。

《Agentic Design Patterns:构建智能系统的实战指南》- 第一章 提示链

实时互动网 实时互动网 · 2025-10-16T02:17:09Z

中科院与清华大学等提出的SE-Agent框架突破了Claude-4的编程限制,提升了多步推理能力,成功率提高20.6%。该框架通过轨迹协同进化优化解决方案,刷新了开源框架的性能记录,展现出智能体自我改进的潜力。

突破Claude-4编程上限!自进化Agent框架拿下新SOTA,已开源

量子位 量子位 · 2025-08-19T09:38:07Z

阿里推出的WebDancer是一款具备多步推理和自主决策能力的信息检索智能体,凭借创新的数据合成和ReAct框架,在复杂信息检索任务中表现出色,展现出强大的泛化能力。未来将集成更多工具,扩展任务范围,推动智能体发展。

阿里智能体多轮推理超越GPT-4o,开源模型也能做Deep Research

量子位 量子位 · 2025-06-06T07:59:00Z

大模型在法律推理中的应用面临挑战,最新的LEXam基准数据集旨在评估其能力。研究表明,现有LLM在复杂法律问题,尤其是多步推理方面表现不佳。LEXam提供高质量法律考试题目,帮助深入理解LLM的能力缺陷,并引入“LLM-as-a-Judge”模式以提升评估的透明性和可靠性。

大模型结构化推理优势难复制到垂直领域!最新法律AI评估标准来了,抱抱脸评测集趋势第一

量子位 量子位 · 2025-06-05T08:20:28Z

本研究提出了AdvKT框架,旨在解决知识追踪模型在多步推理中的错误累积和数据稀疏性问题。通过对抗学习和数据增强,显著提升了智能辅导系统的推荐模型性能。

AdvKT: An Adversarial Multi-Step Training Framework for Knowledge Tracing

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-04-07T00:00:00Z
全新CoD颠覆推理范式,准确率接近但token消耗成倍降低

Zoom 研究团队提出了 Chain of Draft(CoD)技术框架,以提高大语言模型(LLM)的推理效率。CoD 通过生成简洁且信息密集的输出,显著降低计算资源和延迟,提升推理性能。实验结果显示,CoD 在多步推理任务中的信息密度是传统思维链(CoT)的 14.7 倍,推理延迟和 token 消耗显著减少,适合高频金融交易等应用。

全新CoD颠覆推理范式,准确率接近但token消耗成倍降低

机器之心 机器之心 · 2025-03-10T10:29:59Z

本研究提出了一种双重逆向链推理框架(DRCR),用于隐性情感分析,解决了捕捉微妙情感的难题。该框架结合对比推理和多步推理,显著提高了情感分类的准确性,并在多个模型上实现了先进性能。

Application of Multiple Chain-of-Thought in Contrastive Reasoning for Implicit Sentiment Analysis

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-03-10T00:00:00Z

本研究提出了DocPuzzle基准,用于评估大型语言模型在长篇上下文中的推理能力。基准包含100个需要多步推理的专家级QA问题。评估结果表明,慢思维推理模型优于一般指令模型,而蒸馏推理模型与教师模型之间存在显著差距。

DocPuzzle:评估现实长篇上下文推理能力的过程意识基准

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-02-25T00:00:00Z

本研究提出了一种名为FastMCTS的新采样策略,旨在解决合成多步推理数据中的低效和不平衡问题。实验结果表明,FastMCTS生成的正确推理路径比拒绝采样方法增加超过30%,并提升了模型性能3.9%。

FastMCTS: A Simple Sampling Strategy for Data Synthesis

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-02-17T00:00:00Z

本研究提出了大记忆模型(LM2),通过引入辅助记忆模块,克服了标准Transformer在多步推理和长上下文整合方面的局限性。实验结果表明,该模型在多跳推理和大上下文问答中表现优异。

Large Memory Model (LM2)

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-02-09T00:00:00Z
  • <<
  • <
  • 1 (current)
  • 2
  • 3
  • >
  • >>
👤 个人中心
在公众号发送验证码完成验证
登录验证
在本设备完成一次验证即可继续使用

完成下面两步后,将自动完成登录并继续当前操作。
1 关注公众号
小红花技术领袖公众号二维码
小红花技术领袖
如果当前 App 无法识别二维码,请在微信搜索并关注该公众号
2 发送验证码
在公众号对话中发送下面 4 位验证码
友情链接: MOGE.AI 九胧科技 1tok 菜鸟教程 Remio.AI DeekSeek连连 53AI 神龙海外代理IP IPIPGO全球代理IP 东波哥的博客 匡优考试在线考试系统 开源服务指南 蓝莺IM Solo 独立开发者社区 AI酷站导航 极客Fun 我爱水煮鱼 周报生成器 He3.app 简单简历 白鲸出海 T沙龙 职友集 TechParty 蟒周刊 Best AI Music Generator 模力方舟 Gitee AI

小红花技术领袖俱乐部
小红花·文摘:汇聚分发优质内容
小红花技术领袖俱乐部
Copyright © 2021-
粤ICP备2022094092号-1
公众号 小红花技术领袖俱乐部公众号二维码
视频号 小红花技术领袖俱乐部视频号二维码