为WordPress老博客添加多语言功能时,可采用前端翻译挂件方案:不改动原有代码,调用大模型将页面翻译成目标语言,并按词语或段落缓存译文以提升效率。该方案接入快,适合老项目,但翻译准确度和效率不如预先写好译文。
多语言自监督语音模型在相同预训练数据量下逊于单语模型。在英法HuBERT实验中,通过加入辅助语言分类器或按语言k-means目标强化语言辨别能力,音素辨别错误率从11.6%降至10.4%,词汇与韵律表现也明显提升。语言辨别在首轮训练引入效果最佳,后期或重复引入收益较小且加剧语言隔离。
文章提出数据库多语言设计方案:将翻译抽为独立子模式,用语言表、文本表、译文表统一管理业务文本与界面文字,业务表仅存文本编号。新增语言只需补数据,无需改表结构和代码。加列、JSON字段、每语言一行、每表配翻译表四种方案因冗余、绑定或维护问题均不推荐。
谷歌发布 Gemini 3.8 Flash TTS 和 Flash-Lite TTS,支持通过描述或录音创建自定义语音。复刻语音需同一说话人两段 10 至 30 秒录音及同意声明,经 Voices 端点完成,项目最多可存 200 个语音一年。文本视为逐字稿,情感指令放入 speech_metadata。支持双人对话和多语言,Flash-Lite 更快更便宜。
谷歌为AI Max推出新功能:AI Brief测试版新增荷兰语、法语、德语、意大利语、日语、葡萄牙语和西班牙语,广告主可用自然语言提供业务背景。谷歌广告同时新增报告功能,统一展示搜索广告旅程,包括触发广告的搜索词、用户看到的创意素材及落地页,帮助广告主了解AI驱动的表现。更多细节将于今年晚些时候公布。
谷歌AI网关上线Gemini 3.8 Flash-Lite TTS与Flash TTS两款语音模型,支持超100种语言、长文本朗读、语气节奏控制及双人对话。Lite版适合大批量语音生成,Flash版可通过自然语言提示设计音色与角色,支持口音和表演提示。开发者可用统一API调用并追踪用量成本。
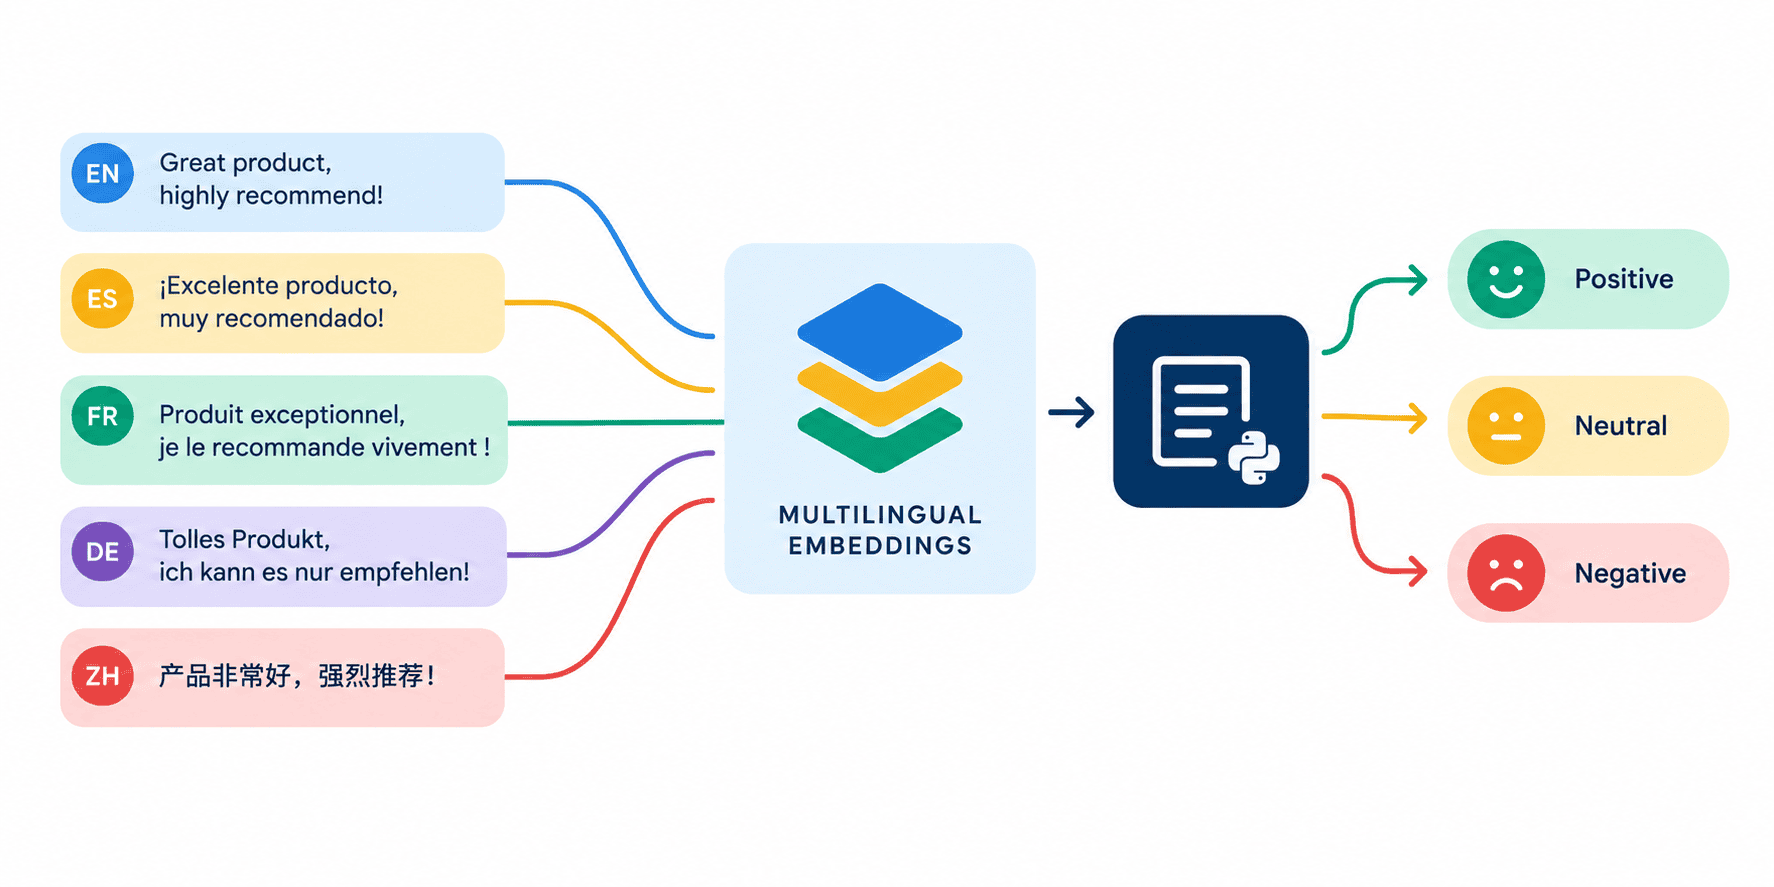
本文介绍使用Scikit-LLM与多语言嵌入构建多语言文本分类流程:通过Ollama本地运行BGE-M3模型,将英西双语评论映射到统一向量空间,再训练逻辑回归分类器,无需为每种语言单独建模。在2000条亚马逊评论上准确率约57%,极端评分预测较好,中等评分较难区分。
多语言RAG中,嵌入模型常按语言而非语义聚类,导致跨语言检索效果差。SHIFT方法通过翻译对计算各语言偏移向量,索引时将非英语文档向量减去偏移,使其对齐英语语义空间。实验显示跨语言召回率大幅提升,但同语言召回下降,适合答案跨语言的场景。偏移量几百对即可稳定,且随语料变化,建议用自有数据估计。
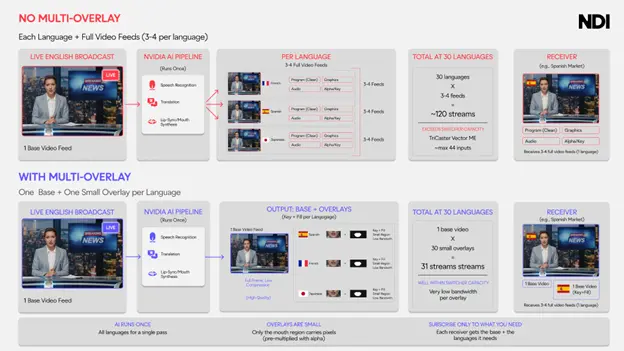
NDI与NVIDIA合作开发AI驱动工作流程,使广播公司能实时创建和分发多语言内容。该方案结合NDI原生媒体连接与NVIDIA NIM微服务,从同一媒体流生成多语言体验,支持实时翻译、唇形同步配音和区域语言适配,无需重复制作。内部测试10种语言时,仅需八分之一视频传输量即可达到相同效果,有望降低带宽和分发成本。方案目前正在测试中。
作者用Astro重构博客,弃用SvelteKit,经三次Codex开发实现静态站点生成器,保留原页面表现。新增动态多语言路由和交互服务,评论数据存本地并渲染为静态页。还加入作者声明、数字签名与时间戳防抄袭功能,部署于Cloudflare Worker。
Meta推出实时语音识别模型Muse Voice Transcribe,支持70多种语言、区分20多位说话者及长对话,在基准测试中词错误率3.1%,优于竞品。模型采用自适应延迟机制,通过强化学习平衡准确性与速度。API定价每小时0.18美元,但不开放权重。Meta因眼镜和Mac应用等产品需求,持续推动该技术发展。
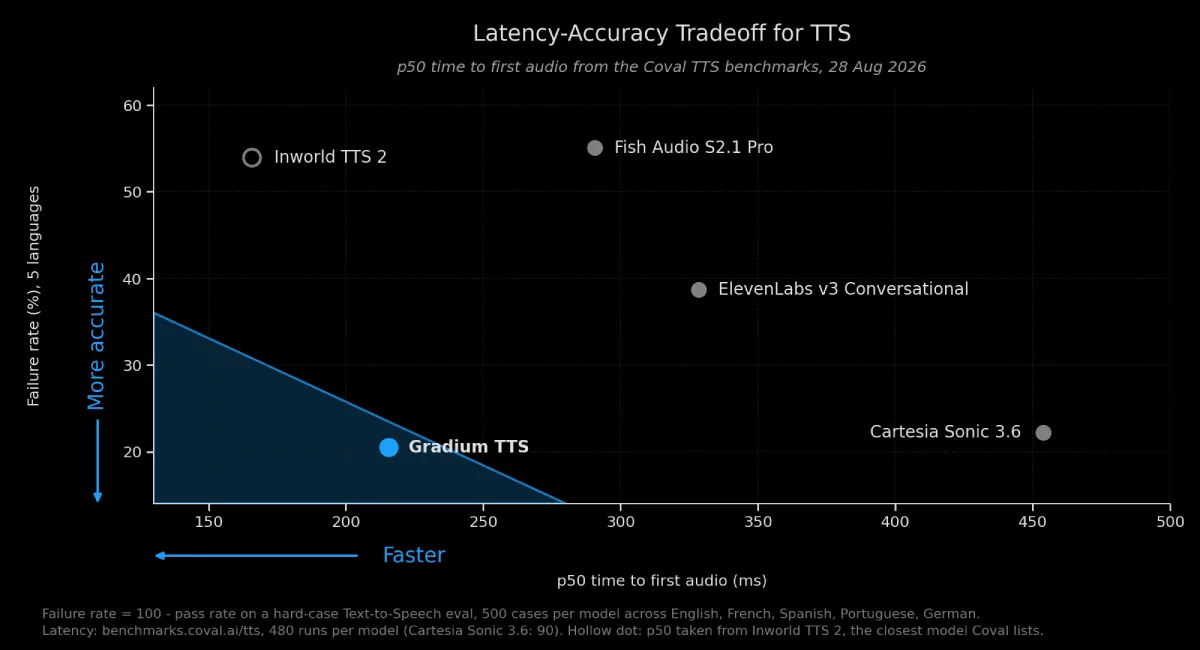
Gradium AI发布新TTS模型并设为默认,在500句难例测试中人工评分通过率81%,领先Cartesia和ElevenLabs。首音频延迟216毫秒,低且稳定。支持多语言,无需文本归一化即可准确朗读号码和邮箱。基准测试由厂商运行,评估集已开源。
谷歌发布Gemini 3.5 Transcribe语音转文本模型,提升实时转写准确率、降低延迟,支持85种语言,自动去除口头语并修正表达,可区分说话者。流式转写延迟低于1秒,错误率低至2.6%。已通过Gemini API公开预览,未来支持Chrome浏览器。
谷歌发布Gemini 3.5 Transcribe语音转文字模型,支持实时流式与预录音频处理,词错率低至2.6%,覆盖85种语言,可识别自定义词汇、多说话人及自动清理语气词。该模型已集成至Gemini应用、Android及开发者API,并获合作伙伴好评。
本文提出LINK方法,通过双语词汇表对高资源语言(英语)预训练数据进行词汇替换,实现跨语言知识迁移。该方法无需额外模型训练或平行数据,仅需低成本双语词典。在八种语言、五种模型规模上评估显示,目标语言下游任务性能显著提升,训练速度最高提升2倍。
该研究大规模探讨了非英语和多语言环境下的GRPO训练,发现用母语推理训练与英语训练效果差距小,且跨语言迁移强,但具体表现因模型和语言而异,某些语言训练可能导致其他语言能力严重退化。因此,RLVR虽能带来广泛跨语言收益,但需全面评估以检测特定语言退化。
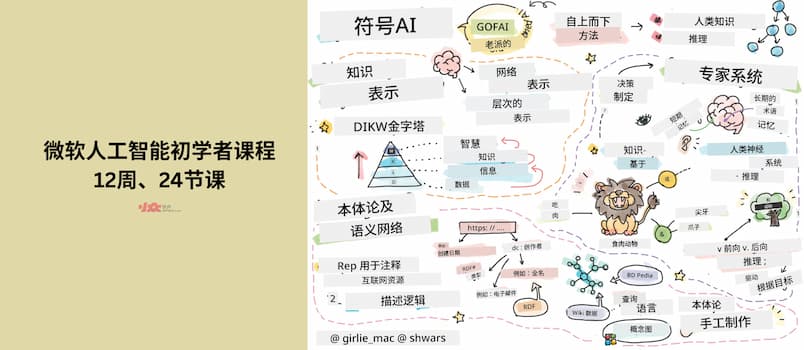
微软开源AI初学者课程,获6万多Star,支持多语言。课程共12周24节课,涵盖TensorFlow、PyTorch及AI伦理,内容从环境设置、AI历史到神经网络、计算机视觉、自然语言处理、强化学习等,附实验与测验,适合学生及自学者。
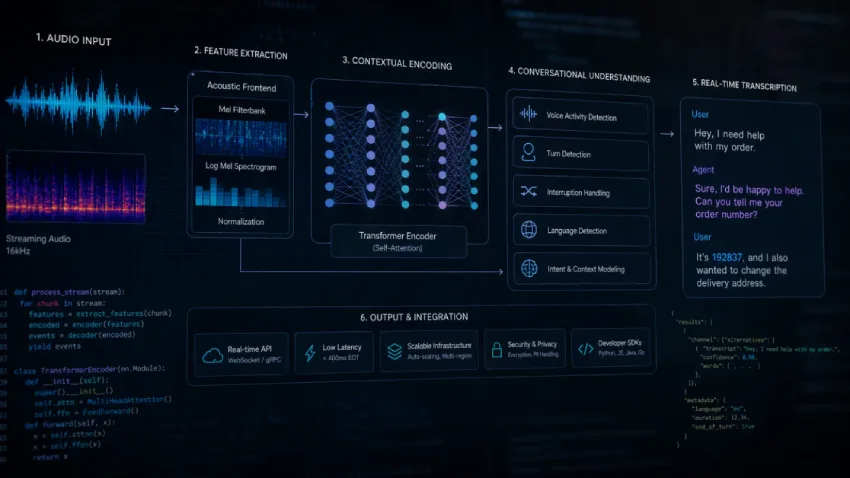
对话式语音识别(CSR)正取代传统自动语音识别,通过理解对话的实时展开、轮流发言和时机,实现低延迟响应。它支持多语言切换,已在客服、医疗、金融等领域应用,推动人机交互更自然、更人性化,成为下一代语音AI的基础。
Claude语音模式升级,现支持Opus和Sonnet模型,可进行深度对话和问题解决。用户可切换模型,练习演讲、头脑风暴、评估假设等。语音模式支持多语言切换,并能连接工具执行任务,如调整日程、生成文档、回复邮件。该功能对所有用户开放,付费计划可使用更多模型和工具。
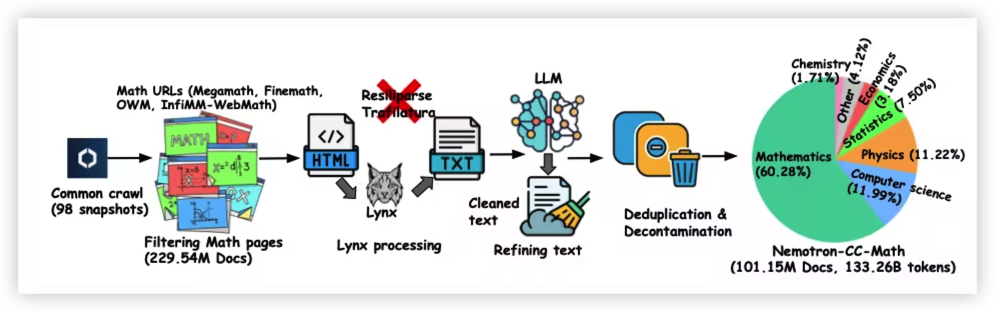
训练数据在大模型竞争中至关重要,NVIDIA推出的Nemotron系列数据集强调数据质量和任务适配性,涵盖通用文本预训练、监督微调和代码生成等核心能力,推动模型训练从数量向精准转变。这些数据集为大模型研究提供系统性支持,提升模型能力。
完成下面两步后,将自动完成登录并继续当前操作。