
使用Scikit-LLM与多语言嵌入的多语言文本分类
内容提要
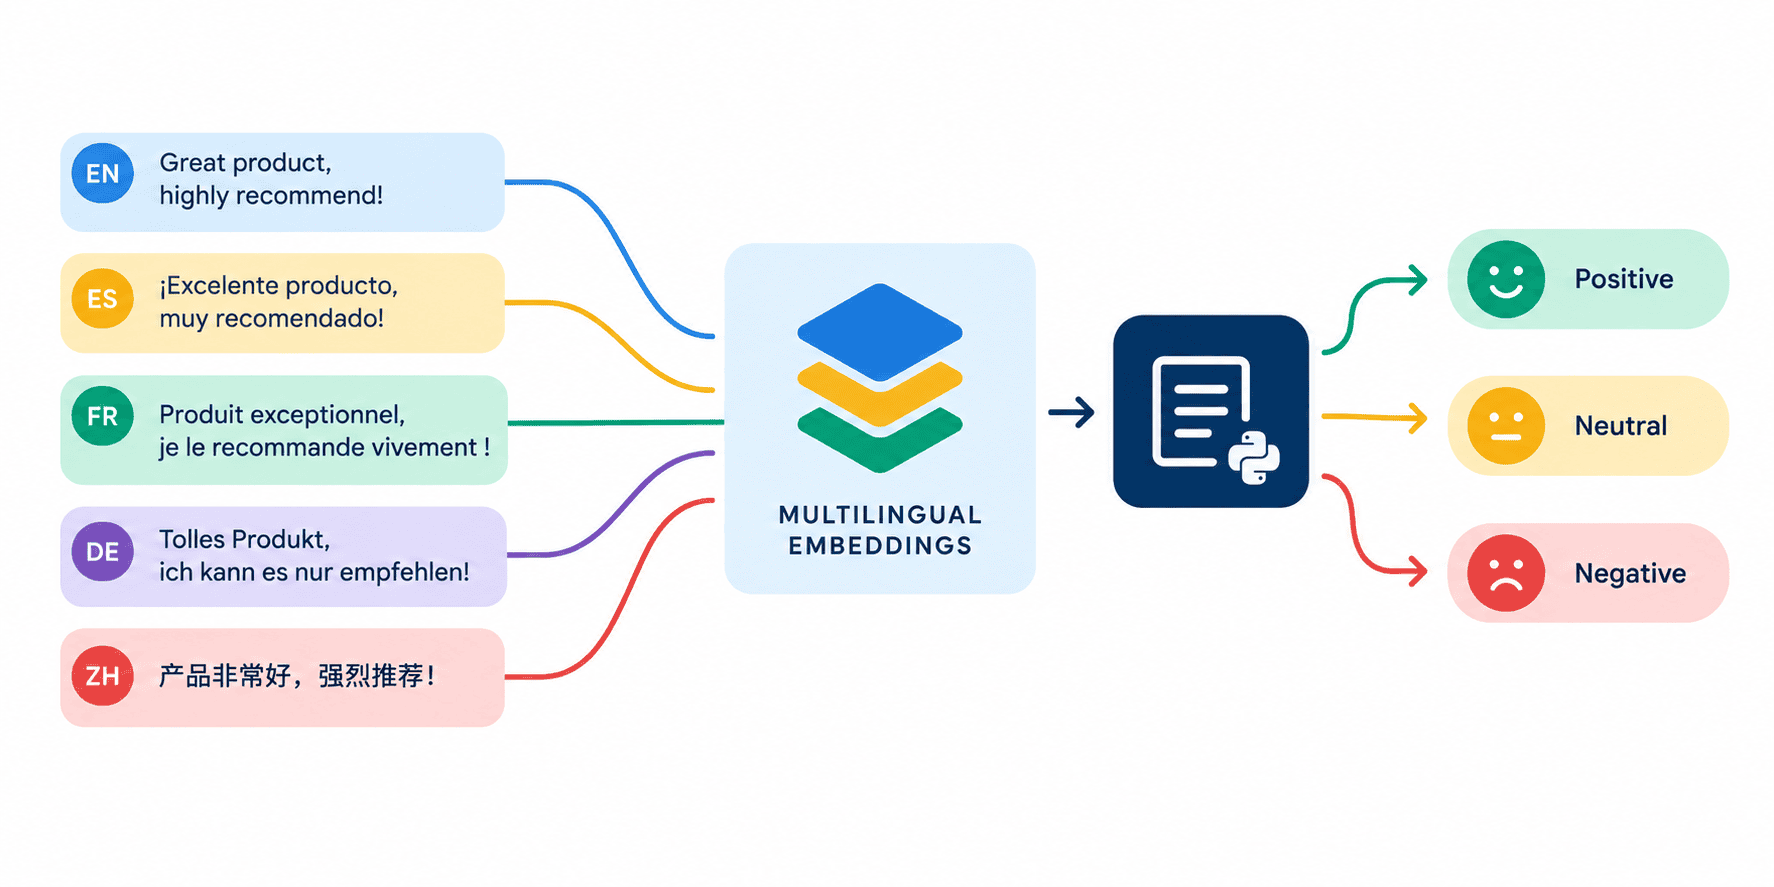
本文介绍使用Scikit-LLM与多语言嵌入构建多语言文本分类流程:通过Ollama本地运行BGE-M3模型,将英西双语评论映射到统一向量空间,再训练逻辑回归分类器,无需为每种语言单独建模。在2000条亚马逊评论上准确率约57%,极端评分预测较好,中等评分较难区分。
延伸解读
多语言嵌入如何消除语言壁垒
文章使用BGE-M3模型将英语和西班牙语评论映射到统一的向量空间,使得语义相似的文本(如“This product is fantastic!”和“¡Este producto es fantástico!”)在嵌入空间中几乎相同。这样,下游分类器无需区分语言,只需基于语义特征进行评分预测,从而避免了为每种语言单独训练模型的繁琐。
本地免费方案的技术栈选择
为了完全免费且可在多种环境运行,文章选择通过Ollama在本地运行BGE-M3模型,并利用Scikit-LLM的GPTVectorizer生成嵌入。配置时只需将Scikit-LLM指向本地Ollama服务并设置一个虚拟API密钥,无需依赖OpenAI等付费API,适合在笔记本或云端环境中实验。
分类性能与挑战:极端评分更易区分
在2000条英西双语亚马逊评论上,逻辑回归分类器的准确率约为57%。极端评分(1星和5星)的F1分数超过0.7,而中间评分(2星和3星)的F1分数仅0.34和0.46。这表明模型更容易捕捉强烈情感,而区分中等评分则更具挑战性,部分原因是任务本身难度高且训练样本较少。
小样本高维数据的过拟合风险
文章指出,仅使用2000个样本(其中80%用于训练)且每个样本为1024维嵌入,容易导致过拟合。虽然当前结果尚可,但若想提升性能,建议增加训练样本数量。这提醒读者在类似高维小样本场景中,需注意模型泛化能力,并考虑通过更多数据来缓解过拟合。
Q&A
多语言文本分类为什么不需要为每种语言单独训练模型?
因为多语言LLM嵌入(如BGE-M3)能将不同语言的文本映射到统一的向量空间,基于语义而非具体词汇。这样,分类器在训练和推理时不再关心语言,只需一个轻量级分类器即可处理多种语言。
如何用Ollama和BGE-M3搭建本地的多语言嵌入管道?
首先安装Ollama并启动服务,然后拉取BGE-M3模型。接着通过Scikit-LLM的配置模块将GPT URL指向本地Ollama实例(如http://localhost:11434/v1/),并设置一个虚拟API密钥。最后在Scikit-LLM的GPTVectorizer中指定模型为bge-m3即可生成嵌入。
在Scikit-LLM中如何构建多语言文本分类的完整流程?
使用scikit-learn的Pipeline,包含两个阶段:第一步用GPTVectorizer(模型设为bge-m3)生成嵌入,第二步用LogisticRegression训练分类器。将数据分为训练集和测试集后,直接调用pipeline.fit和pipeline.predict即可完成训练和预测。
这个多语言分类模型在亚马逊评论数据集上的表现如何?
在2000条英西双语评论上,模型准确率约为57%。极端评分(1星和5星)预测较好,F1分数分别为0.72;而中等评分(2星、3星、4星)较难区分,F1分数在0.34到0.55之间。
为什么模型对极端评分预测更准,而中等评分难以区分?
原因有二:一是任务本身具有挑战性,区分3星和4星评论比区分正面、负面、中性情感更难;二是仅使用了2000个样本(其中80%用于训练),而每个样本是1024维的嵌入,高维小样本容易导致过拟合。
使用多语言嵌入相比传统方法有什么优势?
传统方法要么将所有数据翻译成一种基础语言(慢、贵且易丢失细微差别),要么为每种语言单独训练模型。而多语言嵌入模型(如BGE-M3)能透明地将多种语言映射到统一空间,只需训练一个下游轻量级分类器,大大简化了流程。
