


多语言RAG中的语言偏移
内容提要
多语言RAG中,嵌入模型常按语言而非语义聚类,导致跨语言检索效果差。SHIFT方法通过翻译对计算各语言偏移向量,索引时将非英语文档向量减去偏移,使其对齐英语语义空间。实验显示跨语言召回率大幅提升,但同语言召回下降,适合答案跨语言的场景。偏移量几百对即可稳定,且随语料变化,建议用自有数据估计。
延伸解读
语言偏移的适用场景与代价
SHIFT方法通过减去语言偏移向量,将非英语文档对齐到英语语义空间,从而提升跨语言检索召回率。但实验显示,同语言召回率会下降,例如德语同语言召回从0.61降至0.35。因此,该方法适合答案经常跨语言的场景,如多语言知识库;若用户查询和答案通常同语言,则可能损害检索质量。
偏移量的估计与稳定性
偏移量通过翻译对计算,实验表明仅需几百对即可稳定方向,无需数十万对。但偏移量随语料变化,不同数据集估计的偏移量余弦相似度约0.93,并非通用常数。建议使用自有数据估计偏移量,以更好匹配文档领域,提升检索效果。
参数调整与索引兼容性
偏移强度alpha需根据模型和场景调整,论文中e5-large最佳值约0.6,而e5-small在alpha=1时召回率最高。实验还验证了偏移后的向量在HNSW索引下近似搜索质量与精确搜索相当,召回率差异约0.005,说明该方法对近似最近邻搜索友好。
Q&A
多语言RAG中为什么会出现语言偏移问题?
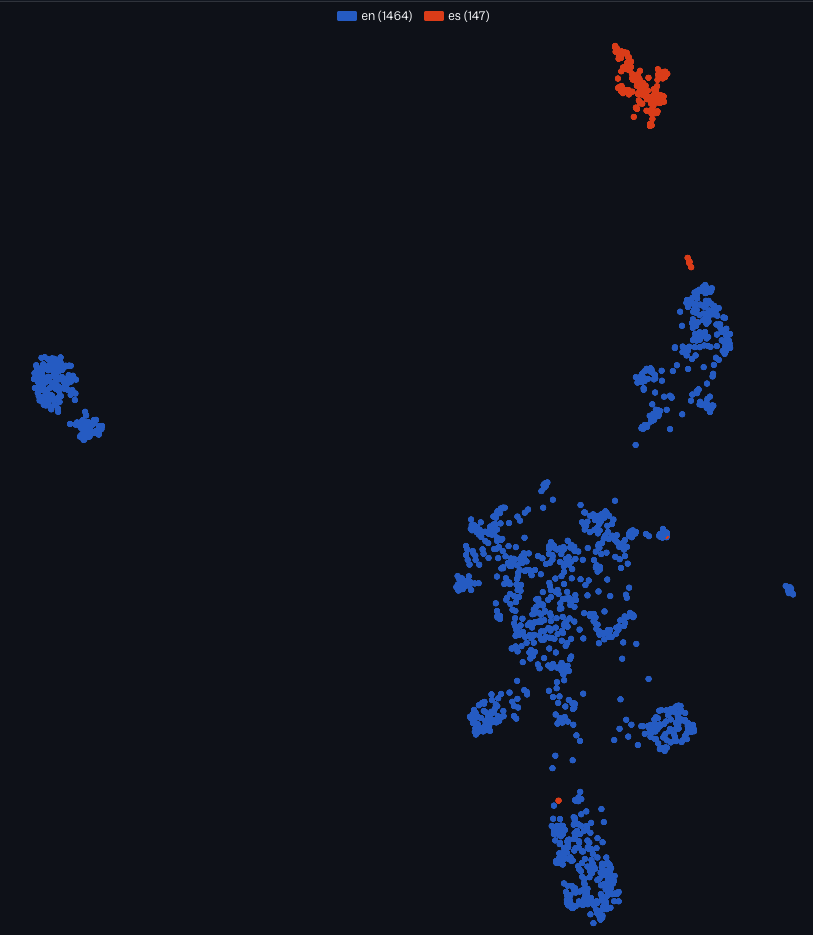
多语言嵌入模型在训练时,不仅按语义聚类,还会按语言聚类,导致语言分组往往胜过语义分组。例如,用德语提问,很可能只返回德语答案,而更好的英语答案却因语言偏差无法被检索到。
SHIFT方法是如何解决语言偏移的?
SHIFT方法通过翻译对计算每种语言的偏移向量,然后在索引时从非英语文档向量中减去该语言的偏移向量,使其对齐到英语语义空间。查询时,非英语查询也做同样偏移。
SHIFT方法对检索效果有什么影响?
SHIFT方法能大幅提升跨语言召回率,但会降低同语言召回率。例如在XRAG数据集上,跨语言召回率从0.083提升到0.240,同语言召回率从0.608下降到0.488。
使用SHIFT方法需要多少翻译对来估计偏移?
偏移量在几百对翻译对时就能稳定下来。实验表明,使用3000对已经足够,且两个独立样本的余弦相似度达到0.9999。
SHIFT方法在HNSW索引下是否仍然有效?
是的,在HNSW索引下,SHIFT方法的召回率与精确搜索几乎一致,差异在0.005以内。例如XRAG数据集上,精确搜索和HNSW的召回率分别为0.297/0.488/0.240和0.297/0.487/0.240。
SHIFT方法适合哪些场景?
SHIFT方法适合答案经常跨语言的场景,即查询和答案通常使用不同语言。如果查询和答案几乎总是同一种语言,则不适合,因为同语言召回率会下降。
