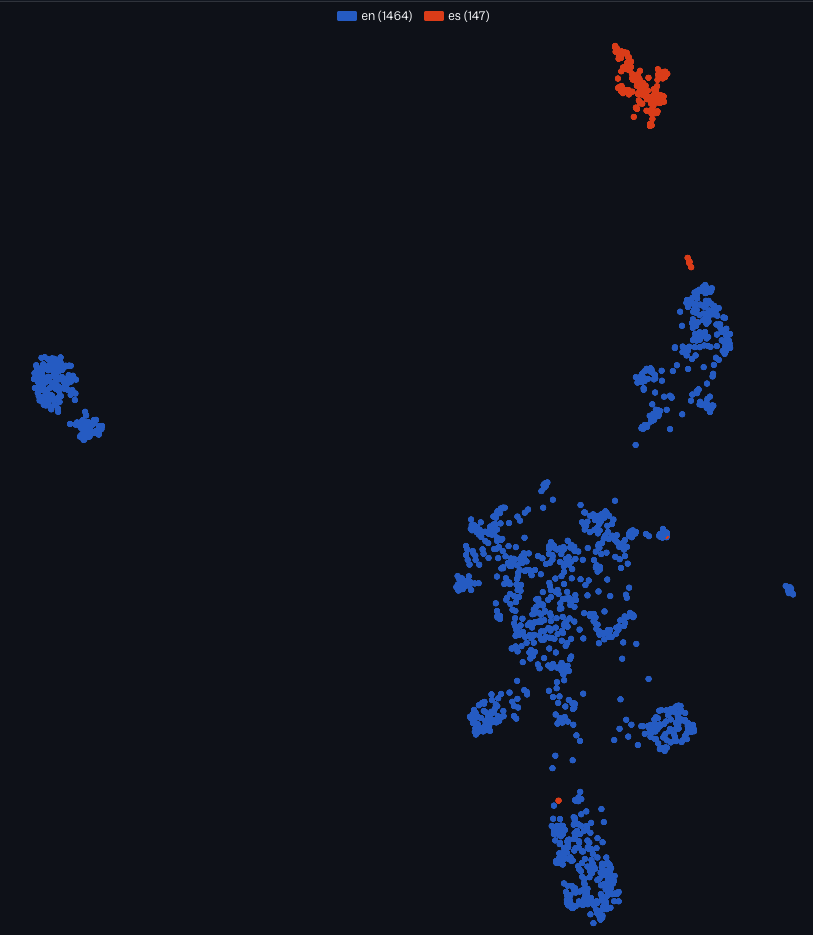
miniCOIL EN-ES是首个双语稀疏神经检索器,能将英语和西班牙语中意思相同的词(如home与casa)映射到稀疏向量的同一概念槽位,无需翻译即可用单一倒排索引跨语言检索。模型基于multilingual-e5-small,用MUSE词典构建约1.2万概念,实际训练2398个概念头,并保留BM25回退。评测显示单语检索略有提升,跨语言检索召回率优于翻译加BM25,但排序精度稍逊。
多语言RAG中,嵌入模型常按语言而非语义聚类,导致跨语言检索效果差。SHIFT方法通过翻译对计算各语言偏移向量,索引时将非英语文档向量减去偏移,使其对齐英语语义空间。实验显示跨语言召回率大幅提升,但同语言召回下降,适合答案跨语言的场景。偏移量几百对即可稳定,且随语料变化,建议用自有数据估计。
本文探讨了信息检索系统与语言模型的结合,评估了多种检索模型和方法,包括跨语言检索、稀疏检索和排名模型的改进。研究表明,新模型和算法显著提升了检索的准确性和效率,满足了高效问答系统的需求。
本研究提出了多种跨语言跨模态检索方法,如CL2CM和CoVLR,旨在提高视觉与目标语言的对齐和检索准确性。通过对比学习和知识共享等技术,解决了机器翻译的不完美问题,并在多个数据集上验证了方法的有效性和鲁棒性。
本文提出了一种名为XPR的方法,从无标注例句中提取短语表示以实现跨语言短语检索,并创建了包含65K双语短语对和4.2M例句的数据集。实验结果表明,XPR在多语言和交叉语言任务中优于传统方法,具备良好的零-shot迁移能力。此外,研究探讨了通过上下文检索提升大型语言模型性能的方法。
本文介绍了一种名为XPR的跨语言短语检索方法,利用无标注例句提取短语表示,并创建了包含65K双语短语对和4.2M例句的数据集。实验结果表明,XPR在零样本迁移和多语言检索任务中表现优异,显著提升了检索能力。
本文综述代码切换在多语言与跨语言自然语言处理中的应用。利用双语词典生成混合语言数据训练排序模型,可提升跨语言与多语言检索效果;代码切换预训练能增强多语言序列到序列模型性能、缩小跨语言表示距离,并提升机器翻译、意图识别、语音识别及低资源语言任务表现,且计算成本增加有限。
该文综述大语言模型在信息检索中的研究,涵盖离线总结与运行时检索结合的个性化方法、无监督查询翻译、跨语种检索增强上下文学习、多语言神经模型提升跨语言检索、低资源跨语言文档重排、基于交互历史的个性化查询建议、机器翻译质量对检索的影响,以及个性化调整提升主观任务性能。
该文综述对比学习在自然语言处理中的应用,涵盖高效持续预训练、音频分类微调、句子表示提升、简历与职位匹配、跨语言检索及产品匹配等任务。研究表明,对比学习结合数据增强、课程学习和硬样本挖掘,可提升模型性能与泛化能力,并减少计算内存和标注需求。
该文介绍了一种跨语言事实核查框架,利用自监督算法和翻译的文章标题来创建训练实例,并在多种语言下实现证据的汇集。在X-Fact数据集上,该方法在零-shot跨语言设置下,绝对F1上获得了2.23%的改进。
通过创建新数据集、使用跨语言查询和提出多阶段框架,实现了跨语言检索任务中已证伪叙述的横跨不同领域和零-shot学习。多阶段检索框架表现出鲁棒性,胜过了BM25基线,并且在不显著损害模型性能的情况下进行了跨领域和零-shot学习。
本文介绍了如何使用LlamaIndex和Qdrant构建多模态和多语言的语义搜索应用。通过结合图像和文本数据,利用vdr-2b-multi-v1模型实现跨语言检索,简化数据提取过程。示例展示了如何上传图像及其描述,并进行文本与图像的相互查询,强调了多模态搜索在电商和媒体管理等领域的应用。
完成下面两步后,将自动完成登录并继续当前操作。