“老董工具箱”中的字节计算器用于转换文件大小与存储单位,支持十进制、十六进制、二进制、八进制、ASCII、UTF-8等格式互转,可选择逗号、空格、分号或无分隔符,并提供转换、交换、清空、复制结果及字符数、字节数、行数统计。
字节跳动正筹备类似Meta Muse的个人AI智能体,推动豆包从聊天工具升级为能记忆需求、主动规划执行任务的个人助理。此前已通过豆包手机助手、豆包工作等探索手机与电脑端自动操作,并接入出行、住宿等服务。豆包月活达4.19亿,用户使用频繁;抖音超10亿月活及推荐系统,有望将“猜你喜欢”延伸至“帮你完成”。
字节跳动整合AI产品:TRAE中国版个人账号将于11月18日升级为豆包飞书账号,可统一登录TRAE、豆包、飞书、火山引擎等产品。代码、项目、会员权益和积分保留,头像昵称优先采用豆包资料。若TRAE与豆包绑定不同手机号,将形成两个独立账号;希望关联现有豆包账号者须在11月18日前手动换绑,之后不再支持。
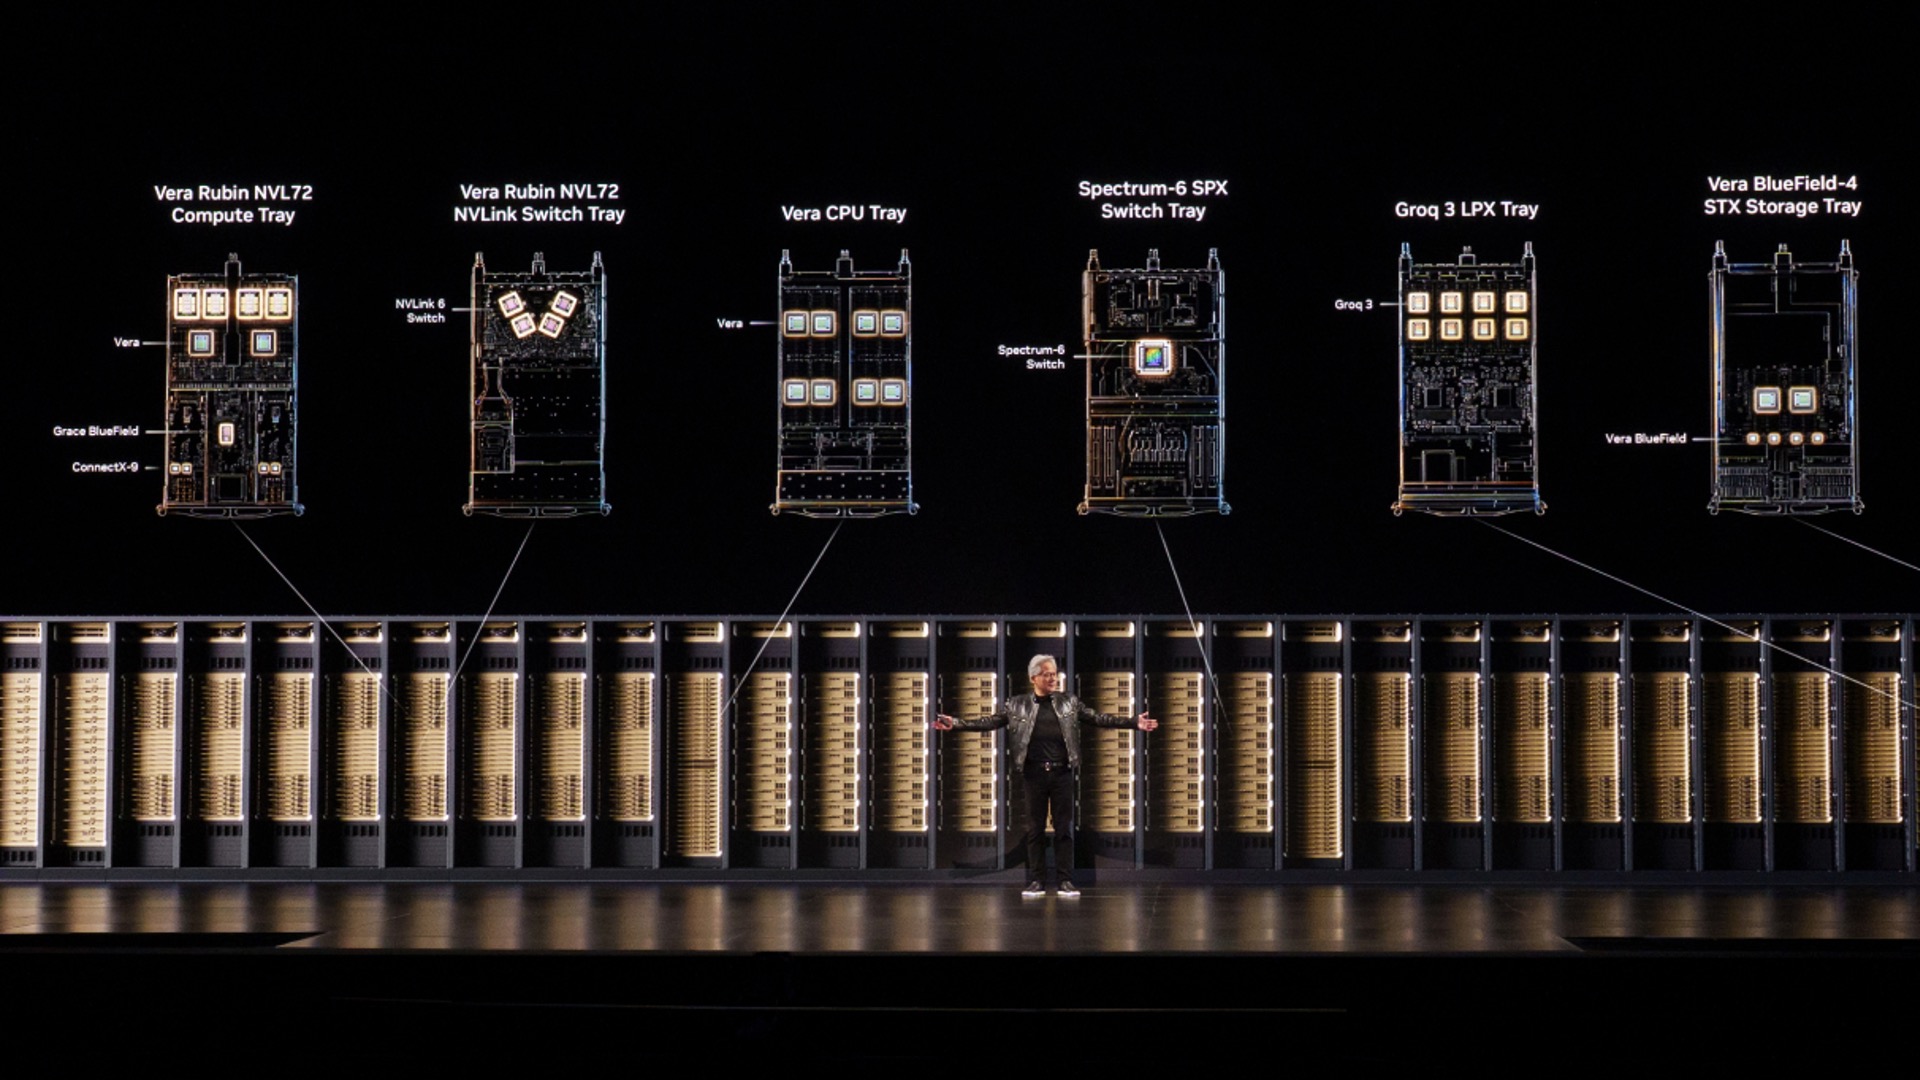
英伟达提出“全栈协同设计”以应对AI内存压力:模型参数、KV缓存和RAG数据激增使HBM容量与带宽成为瓶颈。其方案包括用NVFP4压缩权重与KV缓存、在NVL72内分布式存放权重、借助Vera CPU和Dynamo软件将闲置上下文卸载至CMX存储层,并让RAG索引留在HBM之外,从而提升每字节内存的有效产出。结果显示,Vera Rubin NVL72每美元吞吐量较GB300 NVL72最高提升30倍,而每GPU的HBM容量仅增约3%。
JetBrains在IntelliJ IDEA中实测Java 27默认启用的紧凑对象头(JEP 534):对象头由12字节压缩至8字节,堆内对象占用减少约6%–8%,分配总量降8.8%–13%,GC次数与耗时下降,大型项目最低可用-Xmx降低17%。但进程RSS无明显变化,IDE操作速度仅小幅提升。结论:收益取决于对象构成,需分别测量,不应盲目调低-Xmx。
字节跳动宣布扣子企业版套餐暂停新购并分阶段下线,称系企业级服务产品整合升级,后续方案另行公布。旧套餐超期未用部分将退款,服务最晚持续至2027年12月31日。扣子将公布数据导出与备份安排,建议用户提前迁移。此举或意味着扣子将被整合进豆包工作,反映字节内部赛马结束、AI产品逐步整合。
红果否认400亿收入并非撒谎:其短剧免费,靠广告、电商等后端变现,字节在整条产业链上获利远超此数。红果日活已达1.68亿,AI漫剧爆发式增长、成本大降,冲击传统影视。字节不上市、不认老大,意在“缓称王”避免被盯。制作方分账不透明、保底取消,回本率不足1.3%,行业无幸存者,多数人只是陪跑。
秦朔引用QuestMobile数据称字节系占移动互联网Top50 App使用时长40%以上,提出“字节时间”概念。抖音副总裁李亮反驳称该数据未计长尾App和PC端,份额未达二分之一,不构成支配地位,斥其“纯属瞎扯”。秦朔回应称这是对趋势的概括。争论实质是数据口径与判断尺度之争,有观点认为“字节时间”只是趋势比喻,没有永恒的行业格局。
字节跳动海外短剧应用PineDrama上线约9个月,全球下载量破1亿次,日活约700万,主攻巴西、印尼等市场。它复制红果“免费观看、广告变现”模式,并借TikTok账号登录与导流获客,内容以本土原创为主。下载破亿只是入场券,能否将新兴市场用户规模转化为可持续广告收入,仍待检验。
被字节跳动开除的实习生田柯宇创办AI实验室,主攻世界模型,已完成近3000万美元融资,投后估值2亿美元。他曾因模型投毒被辞退并判赔50万元,后以VAR论文获NeurIPS 2024最佳论文奖。团队约10人,计划用约20万符号视觉词典和1亿小时视频训练AI理解物理规律,完整模型预计2027年发布。
字节Seed团队发现DeepSeek-V4存在相位敏感性:同一问题仅改变无关Token数量,答案会以4个Token为周期反复对错,128K检索准确率最大相差40.2个百分点。原因指向其分块KV Cache压缩,不同压缩窗口位置的信息检索能力系统性不同。自训模型证实该现象随压缩步长变化,全注意力基线无此问题。后训练可缩小差距,但评估需按相位分别测试。
“老董工具箱”提供字节转换器,支持B至YB各单位互转,可选二进制(1024)或十进制(1000)标准:二进制常用于计算机系统与内存,十进制常用于存储设备与网络传输。页面还列出坡度、墙纸用量、墙面面积、增程车油电费用、新能源用车成本及时间转换等工具。
本期 Rust 资讯:cold-string 将不可变字符串压缩至 8 字节,引用计数版 ArcColdString 堆开销更低;ying-profiler 是面向生产环境的采样内存分析器,支持 retained memory 与异步栈;pqc-kem 实测混合后量子 KEM,加入 X25519 封装后慢近 3 倍但仍默认开启;Kobzol 发布八九月上游维护报告,重点缩小 target 目录并推进编译性能工作。
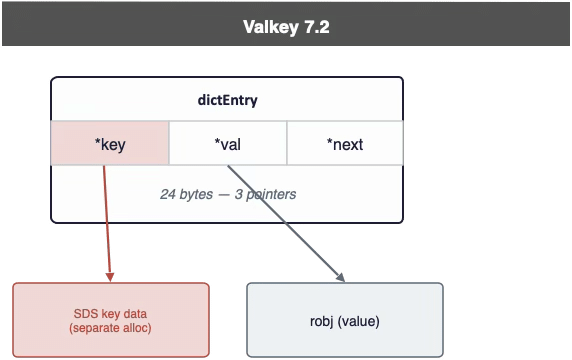
Valkey 7.2至9.1通过三项底层数据结构重构,将字符串密集型场景的每键内存从102.48字节降至64.02字节,减少37.5%。8.0将键内联进dictEntry节省8字节;8.1改用64字节缓存行对齐哈希表,嵌入键值并消除dictEntry,节省20-30字节;9.1将短字符串内联存储,节省最多20%。此外,用Hash存储同一数据比多个String键节省54%内存,但需权衡TTL与集群灵活性。
Meta FAIR与华盛顿大学提出字节级蒸馏新方法,将教师模型的Token概率分布转换为字节级目标,让学生模型直接学习字节分布。实验以Llama 3-8B为教师,提出Marginalize-It和End-Of-Token两种方案。End-Of-Token蒸馏下游准确率上限达52.4%,比传统Token蒸馏高4个百分点,且存储更省,但训练计算量更高。
本期周刊聚焦Python性能陷阱与工程实践,包括set/dict二次方耗时、读取__dict__拖慢属性访问、软弃用re.match()、大版本升级并跑策略、异步测试方法,以及从pandas迁移Polars。另介绍用1024字节写解释器、Pydantic与FastAPI插件架构等文章,并推荐NetAlertX、domonic等12个开源项目。
Cloudflare的1.1.1.1解析器现已支持后量子DNSSEC,可验证NIST标准化的ML-DSA-44签名。该签名达2420字节,超出UDP限制,需改用TCP传输。由于旧解析器仍需传统签名,存在降级风险,1.1.1.1通过DS记录强制要求后量子验证路径。这是为2029年实现全面后量子安全做准备,下一步将为权威DNS和注册商添加签名支持。
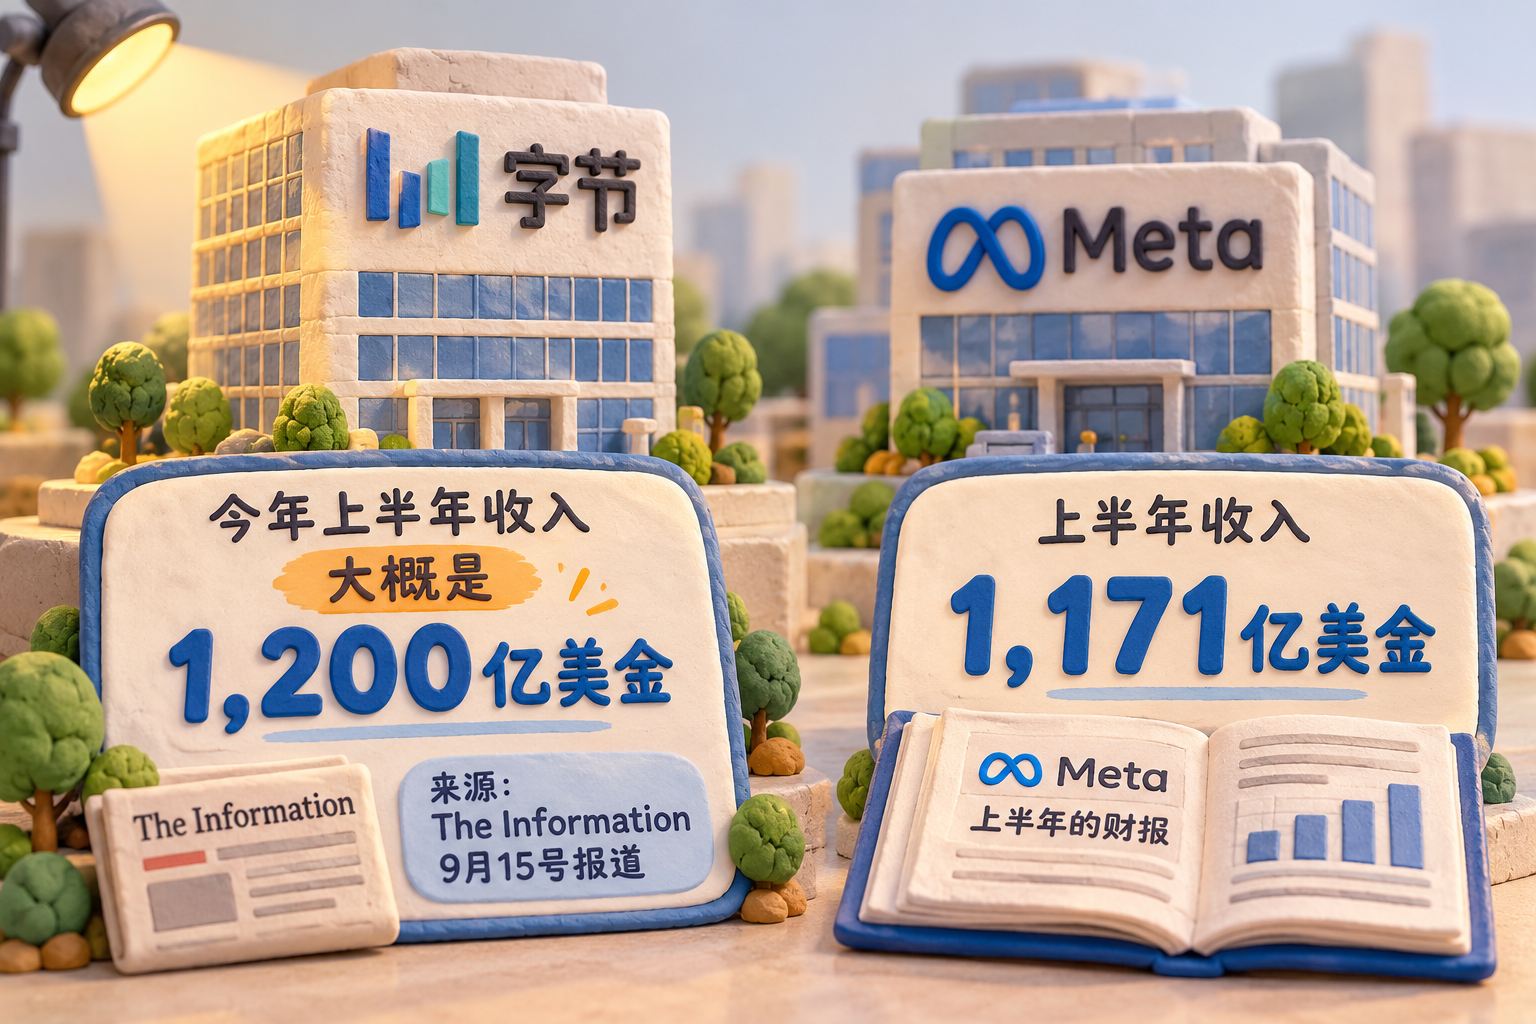
字节跳动选择通过近300亿美元银团贷款融资以支持AI资本开支,而非增发股票,因认为自身估值偏低。其年利润约480亿美元,市盈率仅10倍左右,贷款规模相当于0.62倍运营利润,风险可控。字节在AI领域激进投入,涵盖算力采购、产品开发及研究,采用闭源模型,凭借强大现金流和信用加杠杆,成为BAT中最具进攻性的企业。
该文讨论了一个用1024字节C代码实现的微型Python解释器实验。作者认为其价值不在生产可用,而在于揭示解释器核心取舍,帮助理解语言最小构成。对日常开发,它可作为学习工具和团队讨论素材,提醒在规则引擎等场景中谨慎选择脚本能力,避免维护负担。
前字节跳动强化学习专家孙鹏博博士加入星尘智能,负责机器人强化学习研发,将强化其全栈体系,推动机器人在真实环境中持续学习与部署,实现从Demo到稳定商业化的突破。
完成下面两步后,将自动完成登录并继续当前操作。