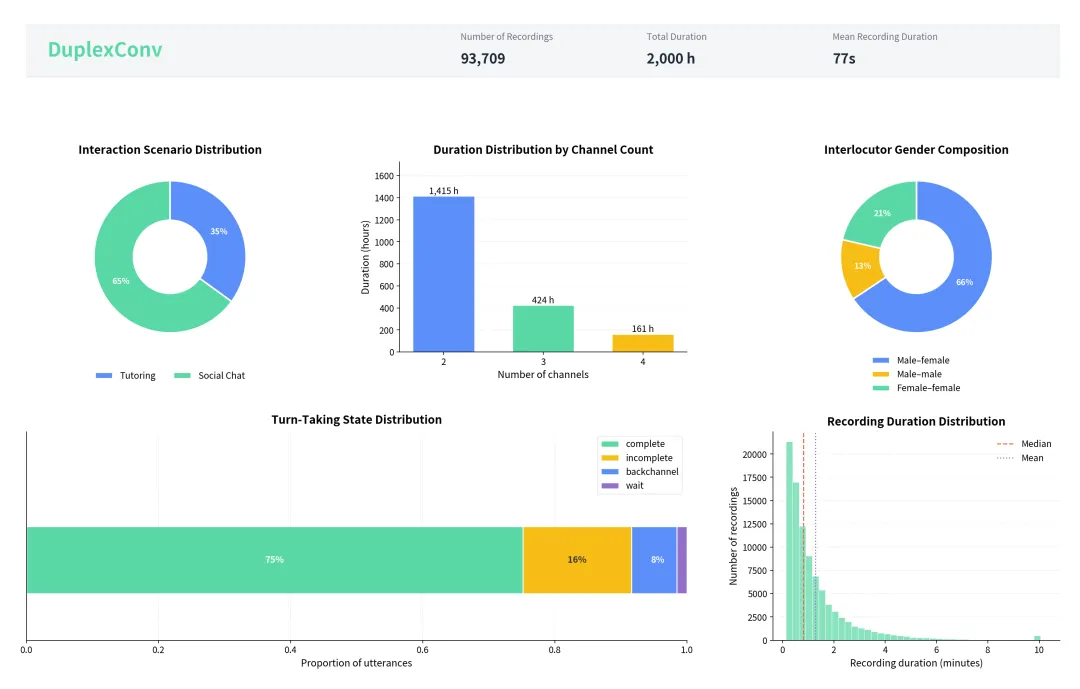
全双工人机交互技术受到关注,ASLP实验室与上海元音矩阵科技公司联合开源了SmoothConv和DuplexConv两个中文长音频对话数据集。这些数据集包含真实对话场景,旨在支持语音大模型研发,提供高质量对话数据,涵盖教育和闲聊领域,助力全双工系统的中断与响应决策。
在Kaggle上找到《老友记》对话数据集,计划构建聊天机器人。通过将对话分角色生成嵌入并存储在OpenSearch中,查询用户输入以返回相关对话。为缩小用户提示与返回对话之间的差距,最终使用Bedrock模型优化响应,确保保持角色语气。完成后,创建前端应用程序供用户聊天。
本研究提出了“多面心理技能”对话数据集,以解决大型语言模型在复杂社交对话中的技能规划问题。新模型“Thanos”显著提升了对话质量,促进了利社会行为。
大型语言模型和对话助手的发展需要动态、可扩展的对话数据集。知识图谱为生成最新的对话KGQA数据集提供了基础。我们提出了ConvKGYarn,能够生成高质量、可配置的数据集,以适应多种用户交互模式,提升对话助手性能。
NormSAGE框架通过语言模型和自我验证机制,发现多语言文化规范,提升对话的相关性和准确性。研究表明,ChatGPT在不同文化背景下的适应性存在差异,尤其偏向美国文化。NormDial和ReNoVi等项目构建了高质量的对话数据集,探讨中美社会规范差异,并提出评估大型语言模型文化适应性的工具,强调文化包容性在AI中的重要性。
本文探讨了领域外意图识别的方法,提出了基于Transformer的编码器微调、广义意图发现(GID)和自适应软伪标签(ASoul)等新技术。这些方法在多个对话数据集上显著提升了意图检测性能,尤其在多轮对话和超出预定义领域的任务中表现突出。通过对比学习和大型语言模型的应用,分析了当前技术的优势与挑战,为未来研究提供了指导。
本文介绍了多个大型语言模型(LLM)及其数据集的研究进展,如UltraChat、LMSYS-Chat-1M和WildChat,强调了通过对话数据集进行微调的有效性。同时,探讨了生成式语言模型在可视化和教育中的应用,提出了AI Threads和StuGPTViz等工具,以提升用户交互和教学效果。
本文探讨了如何利用大型语言模型(LLM)构建角色扮演对话数据集,并评估其角色扮演能力。研究开发了RoleBench和RoleInteract基准,涵盖多种角色和对话示例,揭示个体与群体互动中的表现差异。此外,提出了通过MORTISE改进角色对齐能力的策略,强调LLM在模拟人类行为和社会信念方面的潜力。
本文介绍了一种创建多模态对话数据集的方法,强调文本与图像结合的重要性。研究表明,上下文感知的理解方式可以提升对话质量。此外,提出了个性化展示和基于图片的对话任务,展示了多模态系统在推荐和解释生成中的潜力。
本文探讨了利用大型语言模型(LLM)生成个性化对话的研究,创建了多个对话数据集,如PersonalDialog和CPED,强调个性和情感在对话生成中的重要性。研究表明,基于个性特征的对话模型在多种情境下表现优越,推动了对话人工智能的发展。
该文综述问答系统研究,涵盖:利用众包与Wizard of Oz构建DoQA对话数据集;探究人类数据对模型性能的影响;提出英语问句生成框架;构建意图感知FAQ检索系统;采用深度迁移学习联合检索与阅读理解;基于BERT实现无监督FAQ检索;综述知识图谱等来源的算法;梳理评估指标与数据集;调查法律问答;回顾2016至2021年研究,指出多轮问答已取代单轮问答成为主导。
该文汇总了多项AI协作与交互研究,包括CoDraw协作绘画游戏及评估指标、基于知识图谱的交互式小说生成、语音驱动的实时演示系统RealityTalk、互动速写问答实现多轮信息交流、用大模型生成代码与VR内容、深度神经网络笔画视觉交流、知识图谱交互叙事数据集、Data@Hand健康数据探索、众包文字冒险游戏研究场景对话,以及Talk The Walk定位对话数据集与MASC机制。
该文介绍了文本风格转换在自然语言处理中的应用,重点研究了各种方法的内容保留能力。作者创建了一个对话数据集,包含必须保留的预定义语义槽。作者对无监督方法 LEWIS 进行改进,在任务中取得了明显的优势。
本文介绍了Conversation Chronicles数据集,用于实现长期对话设置。作者提出了一个对话模型ReBot,它表现出高人类参与度的长期上下文理解能力。
完成下面两步后,将自动完成登录并继续当前操作。