

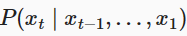
递归神经网络(RNN)用于处理序列数据,具备内部状态(记忆),适应多种输入输出结构。RNN通过递归公式更新隐藏状态并生成输出。长短期记忆(LSTM)通过门控机制解决梯度消失问题,增强信息流动。
递归神经网络(RNN)是一种处理序列数据的神经网络,具备“记忆”功能,广泛应用于自然语言处理、机器翻译和情感分析等领域。长短期记忆(LSTM)网络解决了基本RNN的梯度消失问题,增强了对长距离依赖的捕捉能力。尽管RNN存在训练困难和计算开销大的缺点,但其在深度学习中的重要性持续上升。
本研究探讨了递归神经网络(RNN)在序列数据学习中的维度问题,提出了一种非自治动态系统方法,建立了状态空间子集的分形维度上限。当输入序列来自N维可逆动态系统时,该子集的分形维度上限为N。这一结果对RNN的维度减少及动态系统的分形维度估计具有重要意义。
递归神经网络(RNN)用于处理序列数据,具备记忆能力。其变体LSTM和GRU解决了基本RNN的梯度消失和爆炸问题,广泛应用于语言建模、情感分析和时间序列预测等领域。
液态神经网络(LNNs)是一种新型递归神经网络,能够有效处理序列数据,克服传统深度学习模型的灾难性遗忘和适应性不足。LNNs通过动态调整连接强度,保持对新信息的适应性并减少内存使用。液态基础模型(LFMs)基于LNNs,具有更高效率和性能,适用于多种数据类型,推动生成AI技术的发展。
循环神经网络(RNN)是一种处理序列数据的神经网络,适用于时间序列和自然语言处理。RNN通过更新隐藏状态捕捉信息,但训练时可能遇到梯度消失或爆炸问题。长短期记忆(LSTM)和门控循环单元(GRU)解决了这些问题。尽管有局限性,RNN仍是序列建模的重要工具。
Mamba是一种新的架构,能够高效地捕捉序列数据中的复杂依赖关系。它结合了循环神经网络(RNN)和卷积神经网络(CNN)的优势,实现了线性或接近线性的计算成本。Mamba引入了选择机制和硬件感知算法来提高其建模能力和计算效率。它有潜力革新计算机视觉、自然语言处理和医学研究。然而,仍然存在一些挑战,如记忆丢失和难以推广到不同的任务。
《注意力就是你所需要的》是一篇经典论文,介绍了Transformer架构的重要性和应用。该架构利用注意力机制提高了序列数据的处理能力,加速了训练时间,并在自然语言处理等领域取得了突破。注意力机制是Transformer的核心组件,通过缩放点积注意力和多头注意力来计算表示。这一论文的发表推动了人工智能领域的创新和发展。
本文提出了SigGPDE,一个新的可扩展的稀疏变分推理框架,用于处理序列数据上的高斯过程。通过构造诱导变量来支撑稀疏近似,避免矩阵求逆,并展示了GP签名核的梯度是一个双曲型PDE的解。SigGPDE通过有效的反向传播算法,在大型数据集上实现了最先进的分类任务性能。
本文介绍了一种分解的分层变分自动编码器,能够无监督地学习序列数据的分离和可解释的表征。该模型在转换说话人或语言内容以及说话人验证和自动语音识别任务中优于基线模型。
本文介绍了一种新的多头状态空间架构(MH-SSM),用于处理序列数据。该架构在LibriSpeech语音识别数据集上表现出色,无需外部语言模型,实现了最先进的性能。
本文介绍了深度学习中的循环神经网络(RNN)及其在处理序列数据方面的应用。RNN可通过自回归模型和隐变量自回归模型来处理序列数据。文本预处理包括加载文本、拆分为词元、建立词表和转换为数字索引序列。基于深度学习的模型更适合语言建模。
完成下面两步后,将自动完成登录并继续当前操作。