小红花·文摘
  • 首页
  • AI Tokens🪙
  • 排行榜🏆
  • 直播
  • FAQ
沉浸式翻译 immersive translate
Dify.AI
归一化轨迹模型

归一化轨迹模型(NTM)将扩散模型每步反向过程建模为条件归一化流,实现精确似然训练。它结合浅层可逆块与深层并行预测器,可从头训练或基于预训练流匹配模型初始化。其精确轨迹似然支持自蒸馏,轻量去噪器四步即可生成高质量图像,在文生图基准上媲美或超越强基线,并保留精确似然。

归一化轨迹模型

Apple Machine Learning Research Apple Machine Learning Research · 2026-10-08T00:00:00Z
STARFlow2:弥合语言模型与归一化流,实现统一多模态生成

STARFlow2提出统一多模态生成模型,结合冻结视觉语言模型与自回归归一化流,通过残差连接和统一因果掩码实现连续、单遍生成。它支持文本与图像交错输出,直接进入KV缓存,无需重编码,在图像生成和理解基准上表现优异,验证了自回归流作为统一多模态建模基础的可行性。

STARFlow2:弥合语言模型与归一化流,实现统一多模态生成

Apple Machine Learning Research Apple Machine Learning Research · 2026-08-25T00:00:00Z
带有迭代去噪的归一化流

本文介绍了迭代去噪的归一化流(iTARFlow),一种新型生成模型。与扩散模型不同,iTARFlow在训练中保持完全的端到端似然目标,并在采样时结合自回归生成和迭代去噪过程。实验结果表明,iTARFlow在不同分辨率的图像生成任务中表现优异,展现了其作为强大生成模型的潜力。

带有迭代去噪的归一化流

Apple Machine Learning Research Apple Machine Learning Research · 2026-05-06T00:00:00Z
如果今天这篇注意力机制的帖子看不懂的话,就...可以重读大一了

Softmax通过两步将分数转化为概率分布:首先取指数以确保分数为正,然后进行归一化以得到权重。转置操作QKᵀ确保查询和键的相似度计算顺利进行。

如果今天这篇注意力机制的帖子看不懂的话,就...可以重读大一了

dotNET跨平台 dotNET跨平台 · 2025-10-28T04:44:08Z
第一归一化不完全矩的替代统计推断

本文重新审视了第一归一化不完全矩,这是一种在经济和社会科学中广泛应用的不平等度量。尽管该度量流行,但现有的统计推断未能满足现代分析需求。为此,提出了一种直观、计算高效且适应非标准情况的新方法。通过模拟和实际案例展示了该方法的理论和实践优势,并指出行业常见做法可能导致统计推断的挑战和误导决策。

第一归一化不完全矩的替代统计推断

Apple Machine Learning Research Apple Machine Learning Research · 2025-09-23T00:00:00Z
特征缩放实践:有效的方法与无效的方法

特征缩放是机器学习中的重要预处理步骤,能够提高模型性能。常见的缩放方法包括归一化、标准化、鲁棒缩放和最大绝对值缩放。特征缩放有助于加快收敛速度和提高准确性,但并非所有模型都需要,树模型对缩放不敏感。选择合适的缩放方法对模型效果至关重要。

特征缩放实践:有效的方法与无效的方法

MachineLearningMastery.com MachineLearningMastery.com · 2025-09-17T14:08:26Z
批量归一化入门

批量归一化是一种深度学习技术,旨在稳定训练过程并加速收敛。通过对神经网络各层输入进行归一化,解决内部协变量偏移问题,减少梯度消失现象。该方法通常应用于隐藏层,提高模型鲁棒性并减少过拟合。在Keras中实现批量归一化非常简单,只需在层定义和激活函数之间添加BatchNormalization()。

批量归一化入门

MachineLearningMastery.com MachineLearningMastery.com · 2025-09-05T12:00:46Z
STARFlow:扩展潜在归一化流以实现高分辨率图像合成

STARFlow是一种基于归一化流的生成模型,专注于高分辨率图像合成。其核心是Transformer自回归流(TARFlow),结合了归一化流的表达能力与自回归Transformer的结构建模能力。通过深浅设计、在预训练自编码器的潜在空间建模及新颖的引导算法,STARFlow显著提升了可扩展性和样本质量,接近最先进的扩散模型表现。

STARFlow:扩展潜在归一化流以实现高分辨率图像合成

Apple Machine Learning Research Apple Machine Learning Research · 2025-06-30T00:00:00Z
变换器模型中的LayerNorm和RMS Norm

本文探讨了变换器模型中的归一化技术,重点介绍了LayerNorm和RMS Norm。归一化层在深度学习中至关重要,有助于稳定训练并加速收敛。LayerNorm通过计算均值和方差对输入进行归一化,而RMS Norm则仅进行缩放。理解这些技术有助于构建更稳定和高效的变换器架构。

变换器模型中的LayerNorm和RMS Norm

MachineLearningMastery.com MachineLearningMastery.com · 2025-06-28T01:33:58Z

本研究提出了AlphaGrad,一种内存高效的条件无状态优化器,旨在解决自适应方法(如Adam)的内存开销和超参数复杂性问题。AlphaGrad在强化学习基准中表现优异,尤其在有状态学习机制上展现了更高的稳定性和效率。

AlphaGrad:非线性梯度归一化优化器

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-04-22T00:00:00Z

本研究提出了一种原型引导的自适应归一化策略(ProtoNorm),有效解决了时间序列数据在大规模预训练中因数据分布不匹配带来的问题,显著提升了分类和预测任务的性能。

通过原型引导归一化弥合时间序列基础模型预训练中的分布差距

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-04-15T00:00:00Z
使用凝聚层次聚类进行嵌入聚类(杂乱文件夹整理AI)

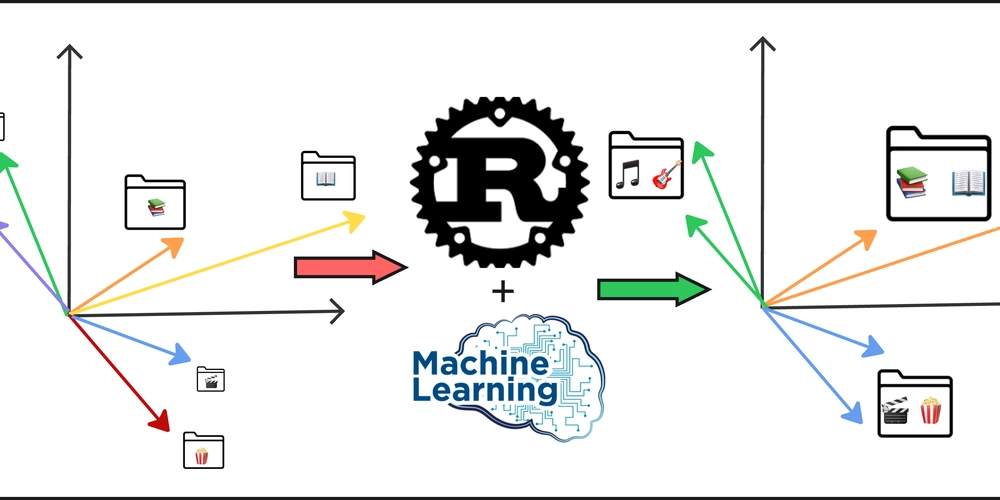
文章探讨了如何利用聚类算法(如凝聚层次聚类)整理杂乱文件夹。由于大型语言模型(LLM)存在上下文限制,无法一次处理大量文件名,因此需先进行聚类,以避免生成不相关的文件夹名称。选择凝聚层次聚类的原因包括无需预定义聚类数量和支持自定义距离度量。此外,文章强调了归一化和余弦距离在高维嵌入空间中的重要性。

使用凝聚层次聚类进行嵌入聚类(杂乱文件夹整理AI)

DEV Community DEV Community · 2025-03-28T15:42:16Z
线性代数中的正交向量和正交单位向量

在线性代数中,正交向量的点积为零,可以归一化为单位向量。正交单位向量既正交又大小为1。

线性代数中的正交向量和正交单位向量

DEV Community DEV Community · 2025-02-14T16:30:00Z

本研究在CrossQ框架中整合权重归一化,解决了强化学习的样本效率瓶颈,显著提升了训练的稳定性和效率。

通过批量和权重归一化扩大脱政策强化学习的规模

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-02-11T00:00:00Z

本文介绍了如何使用ffmpeg的loudnorm过滤器进行音频响度归一化,以解决不同歌曲音量不一致的问题。作者分享了改进后的脚本,强调了测量与调整的分步过程,以及音频文件处理时的参数选择和编码问题。

使用 ffmpeg 对音频文件进行响度归一化

依云's Blog 依云's Blog · 2024-12-11T03:43:45Z

本研究分析了逻辑回归和梯度下降在分类问题中的不足,特别是大步长的影响。提出了“归一化逻辑回归+梯度下降”方法,以提升收敛速度和理论保障。

From Logistic Regression to Perceptron Algorithm: Exploring the Impact of Large Step Sizes in Gradient Descent

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2024-12-11T00:00:00Z
利用历史数据对当前数据进行归一化以消除声音噪音的算法

在开发音乐播放软件时,我使用IIR滤波器实现音频均衡器功能。极端设置下会产生噪音,常规处理方法无法完全消除。我的改进方案是引入全局绝对最大值α,结合当前组最大值β进行归一化,尽管可能稍微降低音量,但从用户体验来看,这是最佳解决方案。

利用历史数据对当前数据进行归一化以消除声音噪音的算法

DEV Community DEV Community · 2024-12-09T13:18:17Z

本研究解决了多模态图像融合(MMIF)中自然图像与医学图像融合的显著差异问题,提出了一种新的归一化策略和卷积核组合。通过混合实例归一化和组归一化,该方法增强了特征关联性,同时采用大卷积核扩展了接收场,从而提高了图像融合的性能。实验结果表明,该方法在多项融合任务中表现出色,显著改善了下游应用的效果。

重新思考多模态图像融合中的归一化策略和卷积核

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2024-11-15T00:00:00Z

本研究解决了自适应优化算法(如Adam及其变种AdamW)在现代深度学习中的训练动态缺乏理论理解的问题。提出了一种Adam和AdamW的连续时间形式,能够更清晰地分析训练动态,发现Adam的超参数范围并验证了规范化层成功的隐含元自适应效应。研究结果有助于优化超参数选择和架构决策,推动深度学习进步。

自适应优化与归一化的连续时间分析

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2024-11-08T00:00:00Z

本文提出了一种针对神经网络表示的流形分析技术——归一化空间对齐(NSA),解决了不同维度的点云之间的距离比较问题。NSA不仅作为分析工具和可微损失函数提供了强有力的表示对齐手段,还具有高效的计算性能,能在小批量训练中近似全局结构差异,从而在多种神经网络训练模式下得到广泛应用。

归一化空间对齐:一种通用的表示分析度量

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2024-11-07T00:00:00Z
  • <<
  • <
  • 1 (current)
  • 2
  • 3
  • >
  • >>
👤 个人中心
在公众号发送验证码完成验证
登录验证
在本设备完成一次验证即可继续使用

完成下面两步后,将自动完成登录并继续当前操作。

1 关注公众号
小红花技术领袖公众号二维码
小红花技术领袖
如果当前 App 无法识别二维码,请在微信搜索并关注该公众号
2 发送验证码
在公众号对话中发送下面 4 位验证码
小红花技术领袖俱乐部
小红花·文摘:汇聚分发优质内容
小红花技术领袖俱乐部
Copyright © 2021-
粤ICP备2022094092号-1
公众号 小红花技术领袖俱乐部公众号二维码
视频号 小红花技术领袖俱乐部视频号二维码