PostgreSQL 19 查询优化新特性:新增 pg_plan_advice 扩展,可记录并回放计划器决策以稳定执行计划;pg_stash_advice 支持按查询标识自动应用建议。EXPLAIN 计时改用 TSC 寄存器降低开销。优化器可将非空列的 IS NOT DISTINCT FROM 转为等值连接,NOT IN 子查询在无 NULL 时可用反连接,虚拟生成列可建扩展统计,postgres_fdw 支持导入远程统计,JIT 默认关闭。
Postgres 可能因代价估算的微小波动为同一查询选择截然不同的执行计划,导致堆块访问从 73 暴增至 3449。作者用 ExoBench 在合成 FEC 数据上复现了这一“计划抛硬币”现象,发现两索引方案不稳定。最终通过创建单个多列 GIN 索引(结合 btree_gin 与 pg_trgm)将交集下推到索引内部,消除规划器决策,使查询从 193.8 毫秒降至 0.76 毫秒。
自动化工具常将操作意图埋入执行逻辑,导致迁移、审计和验证困难。文章主张在人类意图与执行器之间增加“操作规范”层,明确目标、前置条件、约束、证据和恢复规则;执行计划只负责实现方式,规范定义成功标准。这种分离对AI代理尤为重要,可让其灵活选择行动而不重新定义成功。
该文通过MusicBrainz数据集测试,对比SQLx与TeaQL查询性能。直观SQLx全局窗口查询耗时5871毫秒,而先选根对象的两阶段查询仅2.5毫秒,差距达2378倍。TeaQL通过声明业务边界(如根对象数量、关联限制),自动生成优化执行计划,避免处理无关数据。文章强调性能差异源于执行计划的数据量,而非驱动本身,并指出TeaQL优势在于减少手工维护执行细节,确保治理一致性。
Postgres在9表查询中因默认的join_collapse_limit=8,导致执行计划从0.3ms的嵌套循环剧变为467ms的哈希连接,性能下降1500倍。添加5行小表即触发此问题。SQL Server和MySQL无此缺陷。修复方法:设置join_collapse_limit=12,恢复最优计划。建议检查并调整此参数以避免类似性能悬崖。
本文介绍如何构建Postgres扩展querymem,用于预测查询内存消耗。通过解析查询、生成执行计划并遍历节点,累加work_mem和hash_mem_multiplier估算峰值内存。扩展支持GUC配置,可自动记录或阻止超限查询。作者强调源码是最终文档,鼓励开发者探索Postgres内部机制。
本文介绍如何优化SQL Server性能,涵盖T-SQL查询调优、索引设计、执行计划分析及实际优化技术。内容包括理解查询执行流程、识别慢查询、编写高效WHERE子句、优化JOIN和聚合操作、避免常见反模式,并通过Query Store和DMV监控性能。强调基于证据的迭代优化,避免过早优化,并展望智能查询处理等未来趋势。
RegreSQL 2.0 通过测试查询的执行计划和实际统计数据,确保数据库查询的正确性,捕捉到查询返回相同结果但执行方式不当的情况,避免因计划变化导致的性能问题。该工具在开发环境中模拟生产环境的统计信息,帮助开发者在代码合并前发现潜在问题。
Postgres的pg_stats用于生成统计信息,帮助查询规划器优化执行计划。通过ANALYZE命令更新统计数据,pg_stats提供列的独特值、常见值及其频率等信息。准确的统计数据对查询性能至关重要,错误的统计会导致不佳的执行计划。使用相关统计可以提高多列过滤的准确性。
CodeRabbit是一家成立于2023年的AI代码审查平台,旨在通过引入规划系统提高代码质量。该系统协调多个Claude模型,分析需求并明确假设,生成详细的执行计划,以确保团队在代码生成前达成共识,减少错误,从而提高最终代码的质量。
第七阶段连接了解析器和存储引擎,执行SQL查询。执行器解析SQL,查找表,生成执行计划并返回结果。此阶段实现了数据库的基本功能,后续将引入B树索引等优化。
Postgres 19引入了pg_plan_advice和pg_stash_advice模块,提供查询建议功能,帮助优化器选择更好的执行计划。此功能允许DBA在特定情况下调整查询计划,提升Postgres的灵活性和性能。
EXPLAIN和EXPLAIN ANALYZE是PostgreSQL中用于查询优化的重要命令。EXPLAIN显示执行计划,而EXPLAIN ANALYZE提供运行时统计信息。EXPLAIN还支持其他选项,如BUFFERS、MEMORY、WAL、SETTINGS和VERBOSE,这些选项可以帮助更全面地分析查询性能,识别潜在问题。
Jeremy Schneider建议在执行计划中增加I/O时间信息,以更好地理解并行执行性能。分析显示,PostgreSQL在处理39GB数据时,实际读取时间为2.5分钟,但由于并行处理,墙钟时间仅为53秒,工作者读取速度为272MB/s,总带宽需求为739MB/s。这一改进提供了更详细的执行计划视图。
文章讨论SQL查询优化。读者指出示例中连接条件“c1.category_id = c1.category_id”有误,应为“p.category_id = c1.category_id”,否则会导致自连接并影响执行时间。另有建议应优化查询执行计划而非SQL本身,并询问按维度表分组时是否先按部门再按分部聚合。
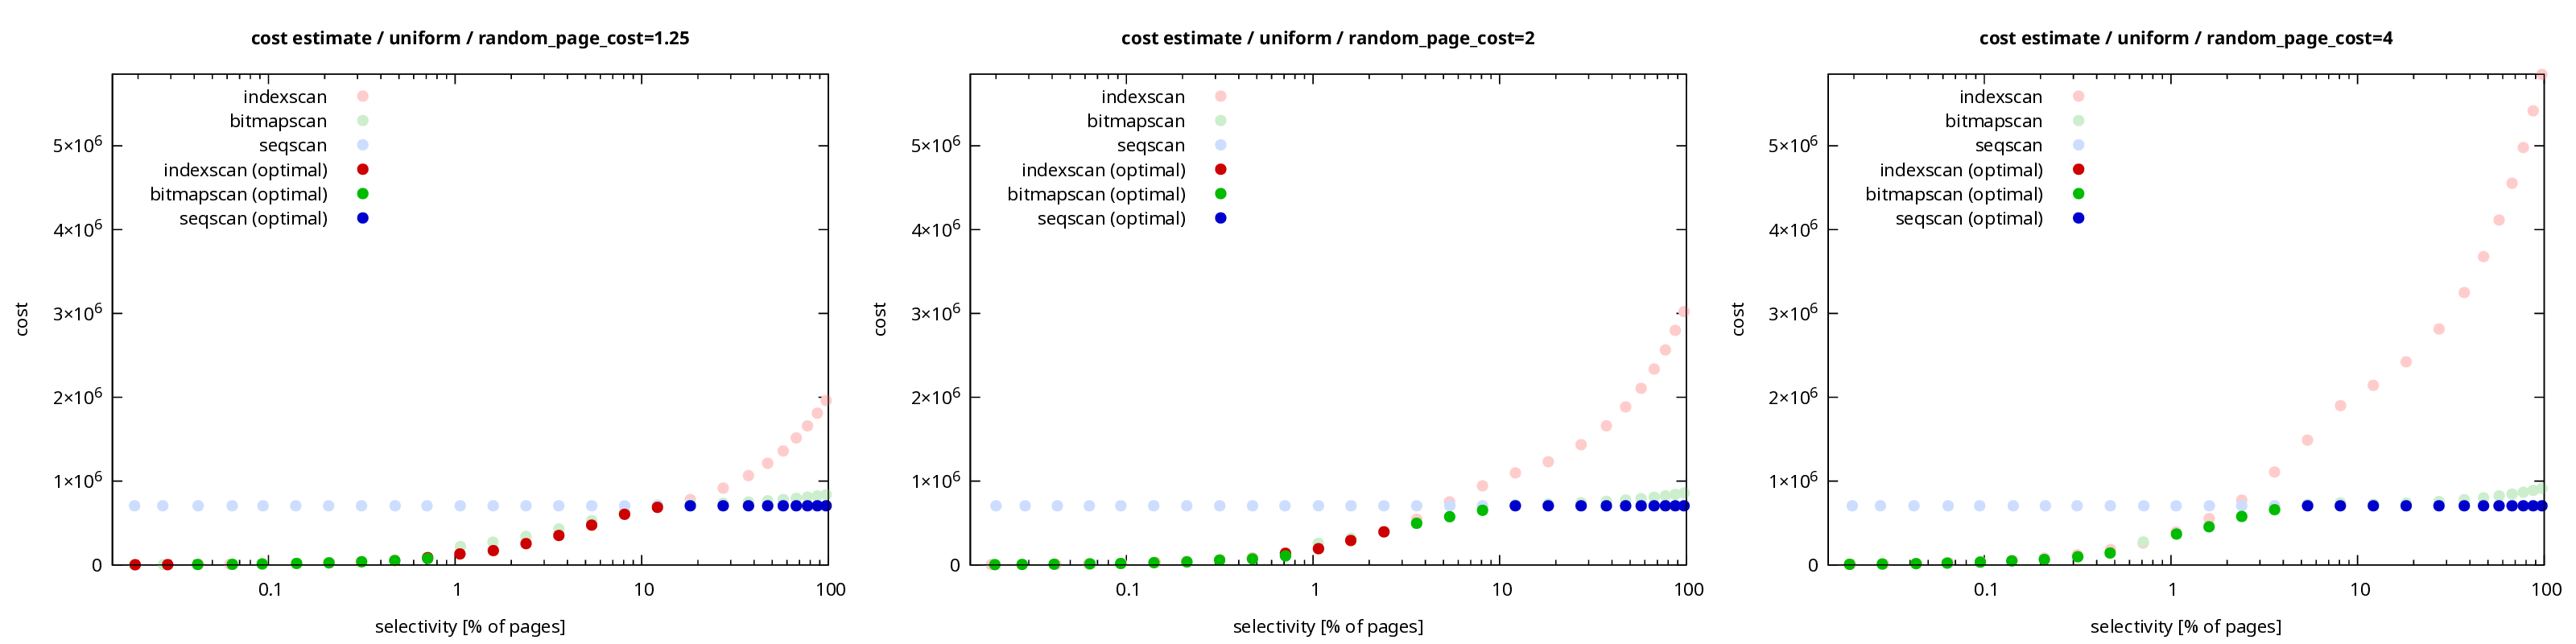
文章讨论了在数据库查询中选择最佳执行计划的挑战,特别是通过调整参数(如random_page_cost)来提升查询性能。作者提供了生成数据集和查询的SQL及bash脚本,并强调了重现结果时的注意事项。尽管优化器的决策基于简化的数据模型,但执行器仍需改进以应对潜在错误。
在TiDB Cloud v7.5.2环境中,通过分析执行计划、添加索引和重写SQL(使用EXISTS和UNION),将复杂评论查询的执行时间从40秒优化至11毫秒,为解决慢SQL问题提供了实战参考。
使用临时表替代派生表可以显著提高SQL查询性能,因为临时表只需计算一次并存储结果,减少了重复计算的开销。通过创建索引,临时表在处理大数据集时更高效。分析执行计划有助于优化查询性能。
优化SQL查询对数据库效率和数据完整性至关重要。通过指定列名、避免OR条件、优先使用数值类型等方法,可以显著提升查询性能并减少资源消耗。使用EXPLAIN分析执行计划、限制表连接和索引数量也是有效的优化策略。
Databricks推出了查询分析功能,帮助用户更好地理解SQL和Python查询的执行计划。新界面直观,支持多云平台,用户可快速识别性能瓶颈并优化查询,通过可视化执行计划和关键指标,提升查询效率。
完成下面两步后,将自动完成登录并继续当前操作。