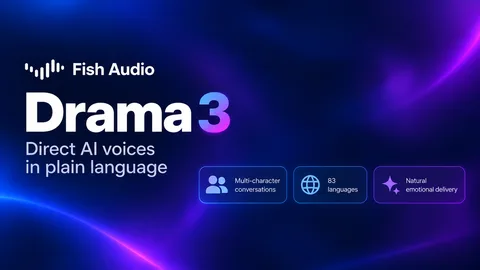
Fish Audio 发布文本转语音模型 Drama 3,采用 35B 混合专家架构,每 token 激活约 3B 参数,权重开放。支持 83 种语言、16 个说话人及自然语言表演指令。发音鲁棒性测试得分 93.2%,精确序列为 86.3%。自托管需 48GB 以上 NVIDIA 显存,API 定价每百万字符 50 美元,年营收 50 万美元以下可免费商用。
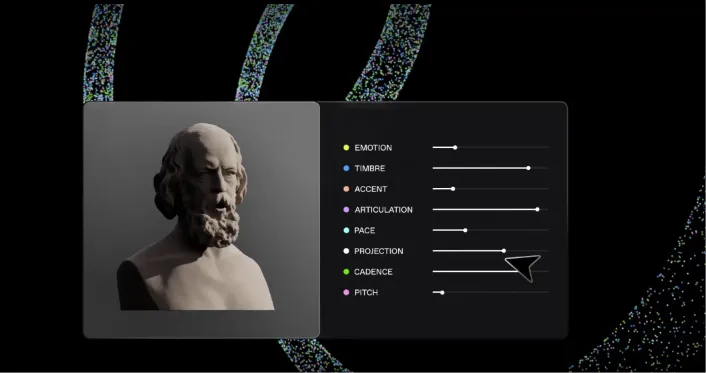
Fish Audio 的文本转语音模型 Drama 3 已在 AI Gateway 上线,30 天内享八折优惠。该模型支持用自然语言指令控制语音表演,可描述情绪与节奏、添加音效和停顿,或用标签调整特定词发音;指令语言可与朗读文本不同,并支持多角色对话。
谷歌发布Gemini 3.8 Flash TTS与Flash-Lite TTS两款文本转语音模型,通过Gemini API和AI Studio开放。Flash TTS面向创意配音,Flash-Lite面向高并发低成本场景。支持提示词设计音色,覆盖100多种语言,提供2000多个音色,支持声音复刻与SynthID水印。Flash TTS在Hume AI评测中排名第一。
谷歌发布两款Gemini文本转语音模型:3.8 Flash TTS面向创意设计,支持自然语言创建角色声音、100多种语言、逐行表演控制、双人对话及长音频生成;3.8 Flash-Lite TTS面向高性价比大规模配音。两款模型均支持30秒样本声音复刻,并配有同意验证、SynthID水印等安全措施,已在AI Studio等平台推出。
巴黎语音AI公司Gradium推出Voice Design功能,输入文字描述即可在数秒内生成全新语音,无需参考音频或真人说话人,也无需处理版权授权。该功能已上线API和Studio,所有套餐免费开放,支持五种语言。厂商自测盲听对比中,其在7627次比较里胜率72.6%,五种语言均排名第一,尤其擅长地域口音。生成的语音可作为常规voice_id用于流式TTS接口。
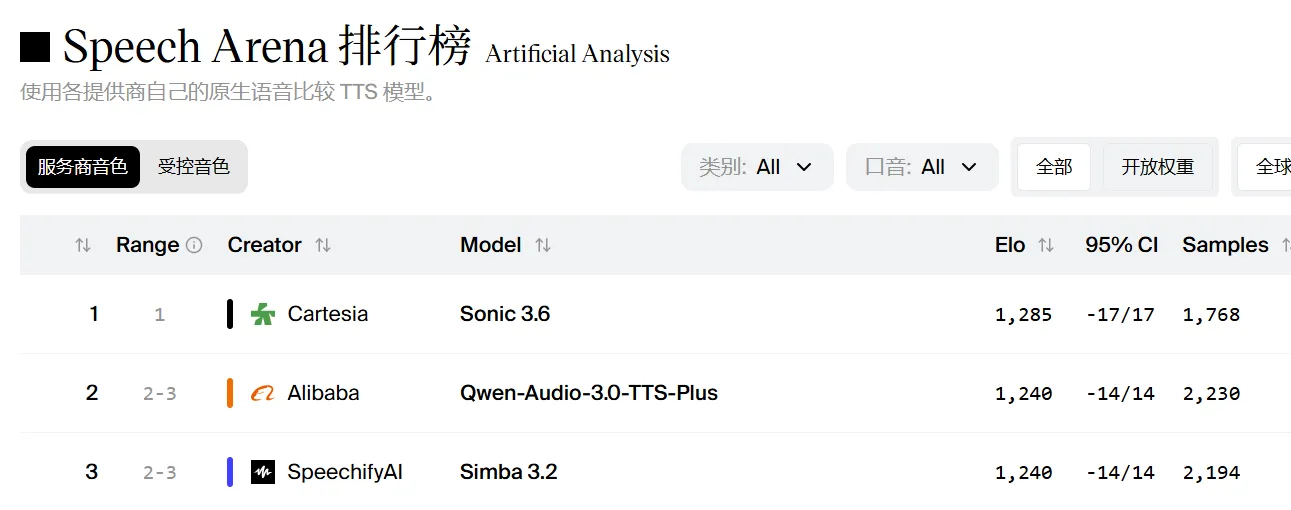
Cartesia发布Sonic-3.6文本转语音模型,在Artificial Analysis两个语音排行榜均居首,自然度提升显著。该模型基于状态空间模型,时延低于90毫秒,支持即时声音克隆、自定义发音等,以Beta版托管API提供,定价每百万字符49美元,不开放自托管权重。
Fish Audio的音频模型已上线AI Gateway,庆祝期间所有模型免费至9月18日。提供四个模型,包括文本转语音(支持低延迟、语音克隆、多语言及情感标记)和语音转文本(带时间戳)。用户可通过标准名称或加“-free”后缀使用,后者在优惠结束后自动停止服务。支持代码和浏览器试玩。
Claude Desktop 现已对接 Fish 语音 MCP,支持高保真文本转语音(TTS),用户可自定义音色和格式。通过 Claude.ai 或 Claude Desktop 远程连接,使用 fish_generate_audio 功能生成音频。首次注册可享免费额度,远程计费按调用次数计算。
Voicebox是一款开源的本地AI语音工具,具备语音克隆、文本转语音和语音识别功能。用户只需录制几秒钟的声音,即可生成多种语言的语音,且无需云端支持和费用。它支持多种语音引擎,适合制作有声书和播客,保护用户隐私,是传统付费服务的替代品。
AI Gateway现已支持音频和语音功能,包括实时语音、文本转语音和语音转文本。用户可以通过AI SDK 7使用这些功能,确保安全和便捷。
AI Gateway现已支持语音和音频模型,用户可以实时构建语音代理、将文本转换为语音以及进行音频转录。这些功能在测试阶段,提供与文本、图像和视频模型相同的可观察性和费用控制,用户可通过AI SDK 7实现低延迟的实时对话。
xAI的音频模型已在AI Gateway上线,提供实时语音、文本转语音和语音转文本功能。用户可通过AI SDK 7版本安全访问这些功能,开发者可使用示例代码快速集成,体验实时语音交互。
在微软Build开发者大会上,微软发布了MAI-Transcribe-1.5语音转文本模型和MAI-Voice-2文本转语音产品,提升了语音识别和合成语音的自然度。同时,微软推出了Project Solara,旨在通过持续在线的AI代理改善用户体验,尽管面临隐私和安全挑战,微软仍致力于将AI更深入地融入日常生活。
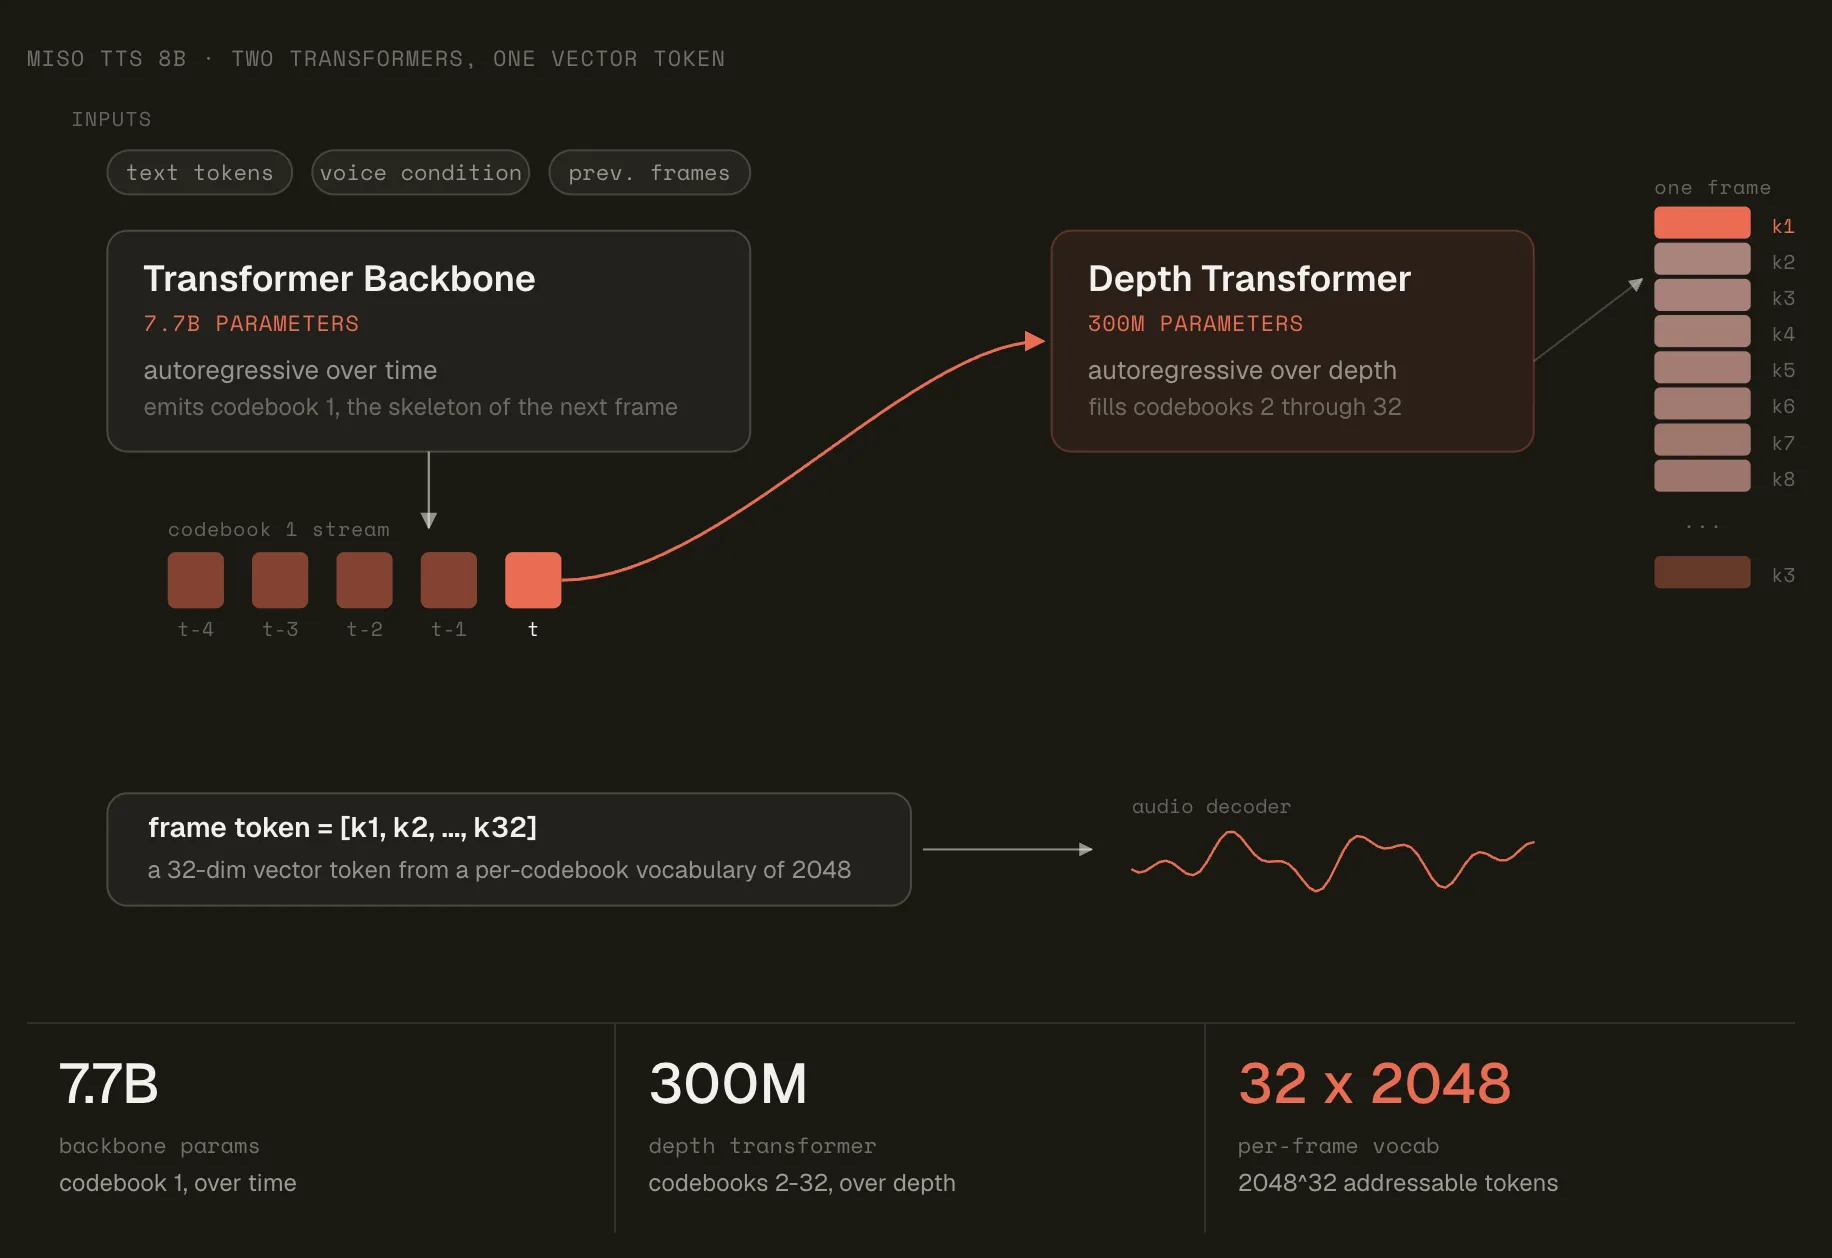
Miso Labs发布了MisoTTS,这是一款拥有80亿参数的文本转语音模型,采用残差矢量量化技术,能够根据文本和音频上下文生成富有表现力的语音。该模型的词汇量可扩展至约2048³²,支持半双工传输,API访问正在开发中。
Fish 语音 MCP 是一个高保真的文本转语音引擎,支持多种音色和格式。用户需获取 AceData Cloud API Token 进行配置,之后可生成音频。该服务适用于多种场景,调用时会从用户额度中扣费。
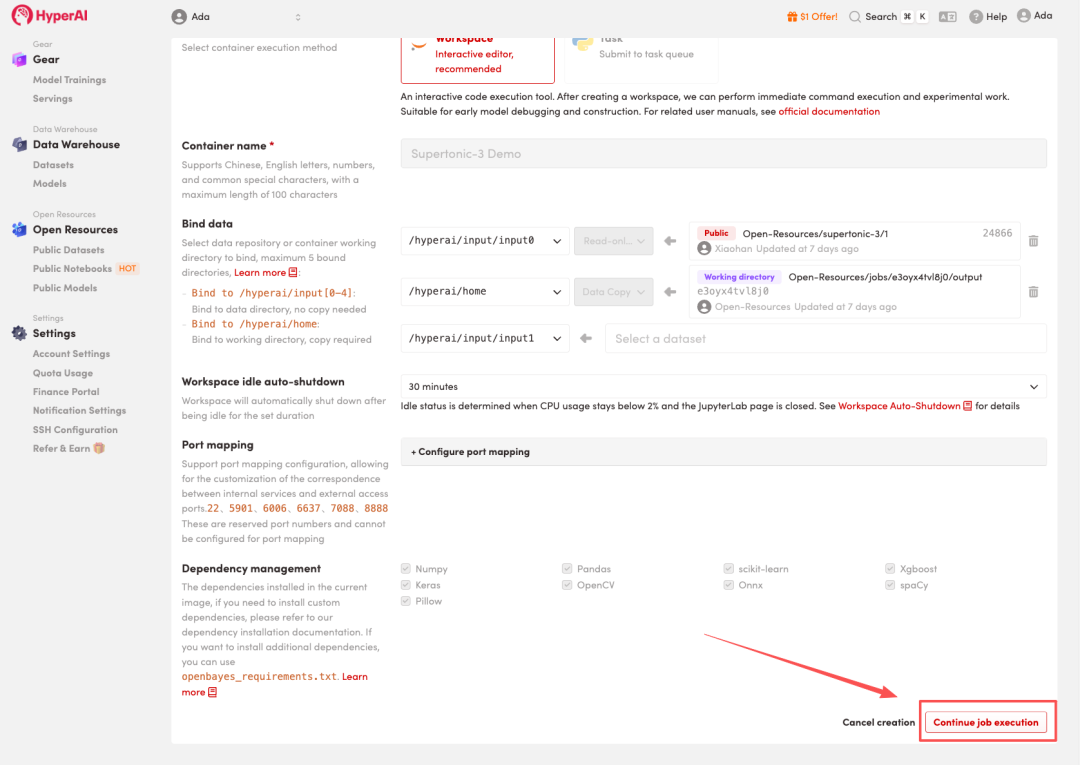
随着生成式AI向多模态发展,Supertone团队推出的Supertonic-3模型支持31种语言,具备实时语音合成能力,参数仅为9900万。该模型可在CPU环境中运行,无需云API,适合开发本地AI助手和语音播报系统。
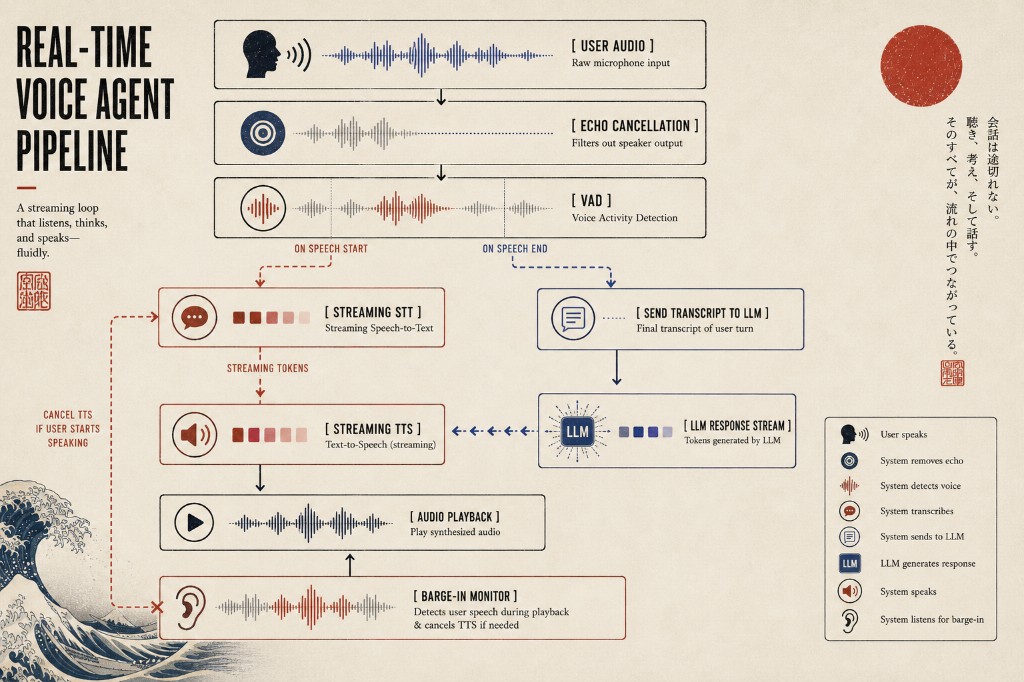
本文探讨了语音智能体的架构,包括语音转文本(STT)、大语言模型(LLM)和文本转语音(TTS)三个阶段。引入音频后,延迟和上下文处理变得复杂。级联模型适合大多数生产环境,而端到端模型在自然对话中更具竞争力。流式传输技术可减少延迟,提升对话自然性。设计中需考虑语音活动检测和话轮管理等技术挑战,以改善用户体验。
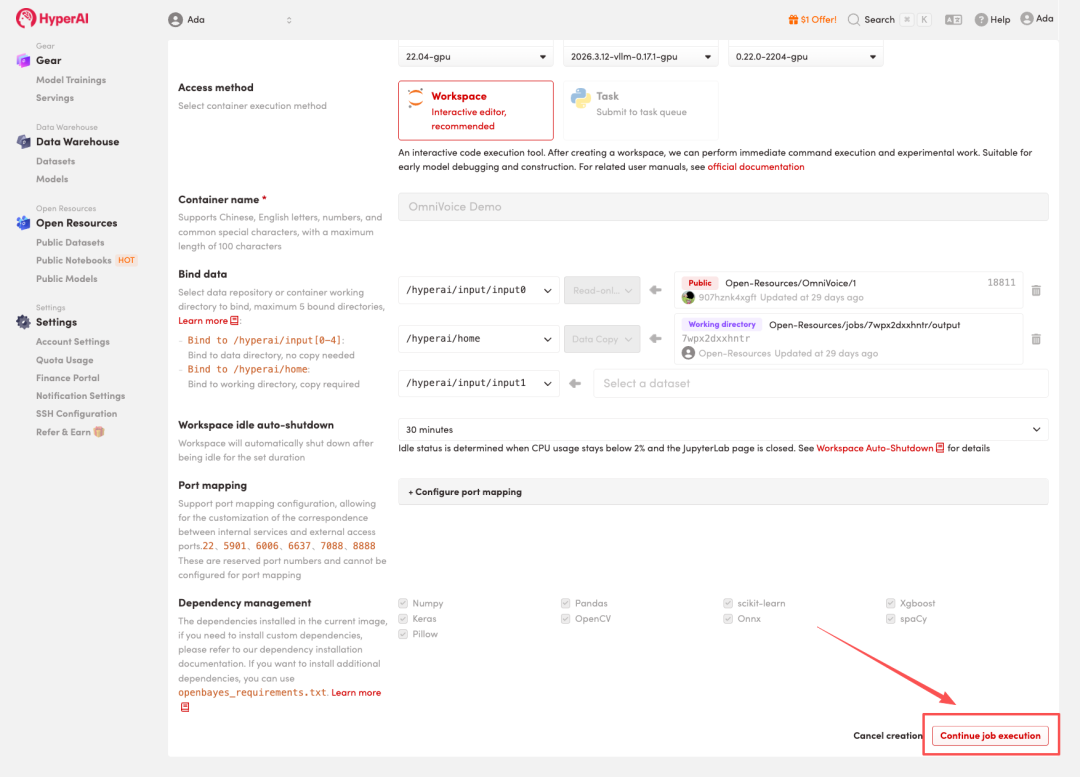
OmniVoice是一款新发布的多语言文本转语音(TTS)模型,支持超过600种语言,包括多种方言和口音。它采用非自回归架构,简化了语音生成流程,提高了自然度和可懂度。该模型具备零样本语音克隆能力,适用于AI配音和跨语言内容生成,展现出广泛的应用潜力。
Voxtral TTS是Mistral AI推出的开源文本转语音模型,支持九种语言,能够在三秒音频基础上克隆声音,具有70毫秒的低延迟和9.7倍的实时因子,适合实时对话应用。用户可通过Mistral API或自托管方式使用,提供灵活的商业和非商业使用选项。
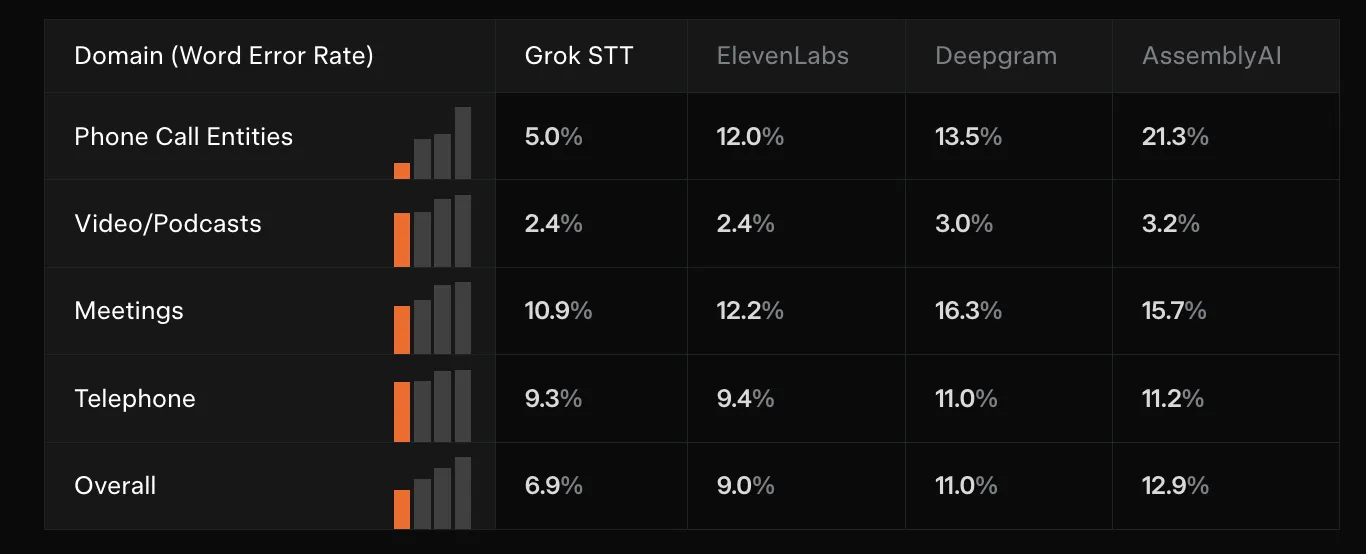
埃隆·马斯克的 AI 公司 xAI 发布了两款音频 API:语音转文本(STT)和文本转语音(TTS)。STT 支持 25 种语言,提供实时和批量转录,错误率为 5.0%。TTS 支持 20 种语言,提供多种声音选择,定价为每百万字符 4.20 美元。这标志着 xAI 进军语音 API 市场。
完成下面两步后,将自动完成登录并继续当前操作。