小红花·文摘
  • 首页
  • AI Tokens🪙
  • 排行榜🏆
  • 直播
  • FAQ
Dify.AI
沉浸式翻译 immersive translate
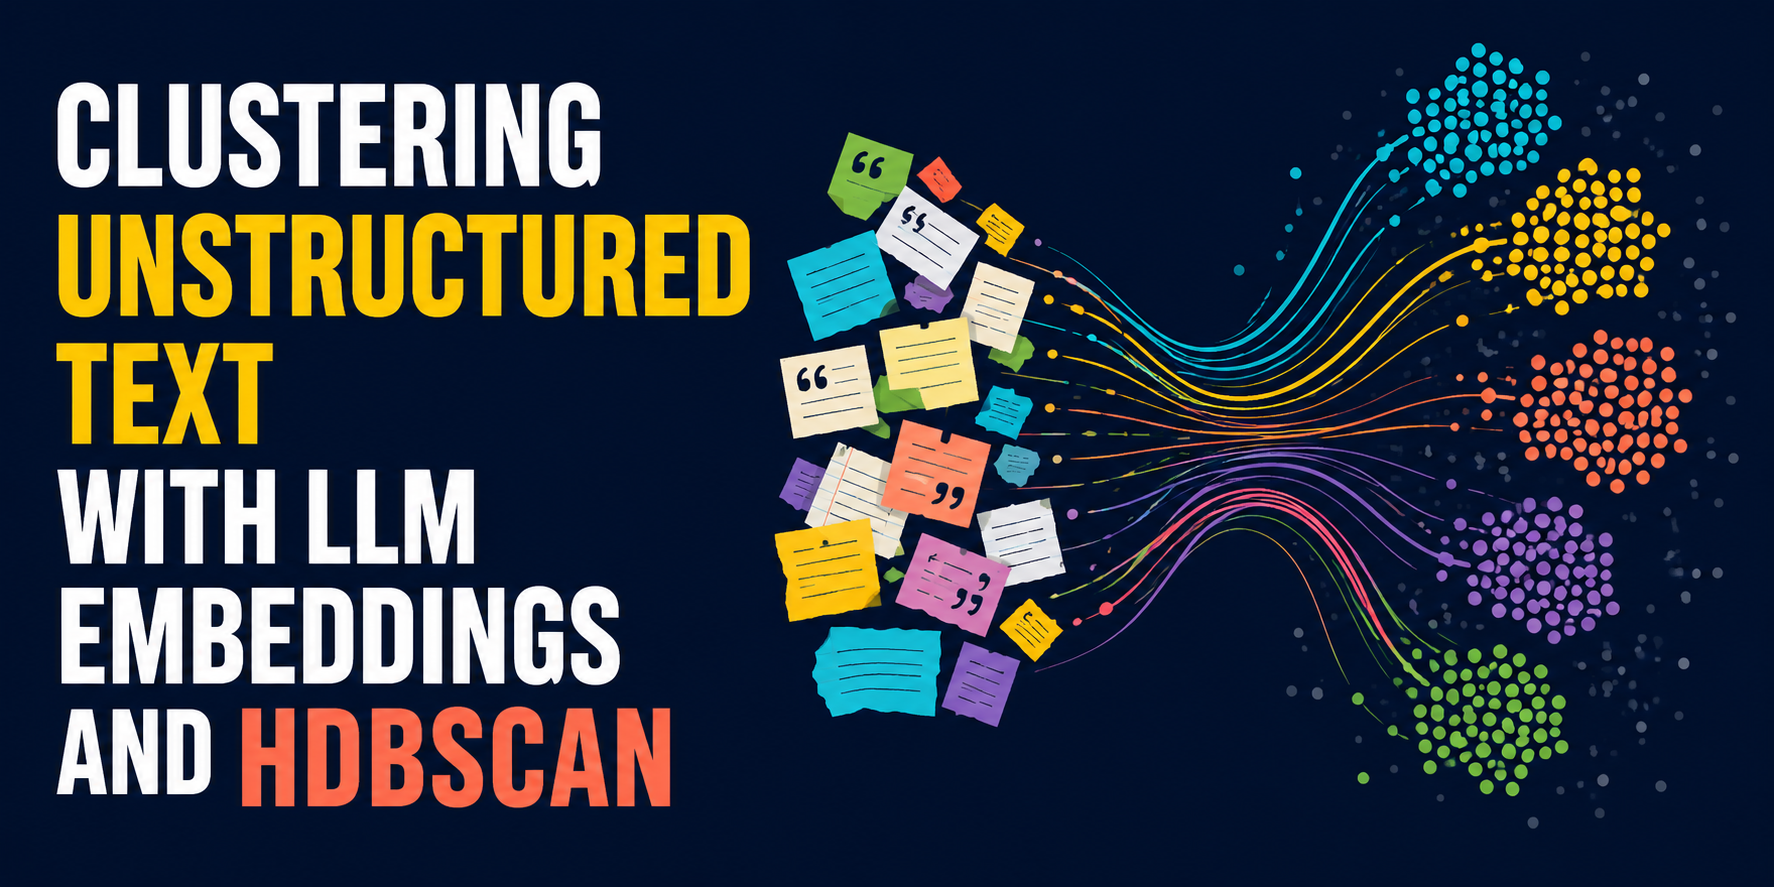
结合LLM嵌入和HDBSCAN的非结构化文本聚类

本文介绍了如何结合大型语言模型(LLM)嵌入和HDBSCAN算法构建文本聚类管道,以自动发现未标记文本数据中的主题。主要步骤包括生成文本嵌入、降低维度和应用聚类,最终成功识别出两个主题聚类,展示了该方法的有效性。

结合LLM嵌入和HDBSCAN的非结构化文本聚类

MachineLearningMastery.com MachineLearningMastery.com · 2026-06-23T12:00:57Z

浙大团队提出了一种自我监督的强化学习方法GUI-RCPO,能够在无标签数据上提升GUI定位能力。该方法通过区域一致性引导模型自我优化,减少对标注数据的依赖,展现出良好的泛化性和准确性。实验结果显示,GUI-RCPO在不同模型上均有显著提升,验证了其有效性。

告别海量标注!浙大团队提出GUI-RCPO,让GUI定位在无标签数据上自我进化

量子位 量子位 · 2025-09-05T04:43:45Z
Databricks Agent Bricks通过TAO和ALHF方法自动化企业AI开发

Databricks推出Agent Bricks,简化企业特定代理的开发。该平台通过自然语言反馈自动生成评估套件,优化代理质量。用户选择任务后,系统自动创建评估基准并进行优化,确保高效且具成本效益。新方法ALHF和TAO提升了模型质量,支持无标签数据的优化,适用于信息提取和知识助手等应用,促进领域专家参与系统改进。

Databricks Agent Bricks通过TAO和ALHF方法自动化企业AI开发

InfoQ InfoQ · 2025-07-28T10:53:00Z

Ubiquant团队提出了一种新方法——熵最小化(EM),仅需一条无标签数据和10步训练,显著提升大语言模型(LLM)性能,超越传统强化学习(RL)方法。EM通过优化模型预测的熵,增强模型自信,适用于数据稀缺场景,降低后训练成本。研究表明,EM在数学推理任务中表现优异,具有广泛应用前景。

挑战强化学习后训练霸权!全新无监督方法仅需1条数据+10步优化

量子位 量子位 · 2025-06-01T04:57:36Z

本研究提出了一种数据中心的创新范式,通过CoOpt框架优化无标签数据,显著提高深度学习的训练效率和模型性能,具有实际应用价值。

协作无标签数据优化

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-05-20T00:00:00Z

本研究提出了一种表格数据适配器(TDA)的方法,以改善无标签私有数据的异常检测。通过识别相似的公共数据集并转换私有数据格式,生成弱标签,从而提高了50个领域的数据集的注释准确性,并减少了计算时间。

Tabular Data Adapters: Improving Outlier Detection for Unlabeled Private Data

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-04-29T00:00:00Z
基于Gromov-Monge间隙的解耦表示学习

从无标签数据中学习解耦表示是机器学习中的一大挑战,解决此问题有助于推广、可解释性和公平性。尽管理论上难以实现,但实践中常通过先验匹配来解决。最新研究表明,结合几何特征可以增强先验匹配。我们提出了一种基于二次最优传输的新方法,利用Gromov-Monge映射以最小失真传输分布,同时尽量保留几何特征。我们提出的Gromov-Monge-Gap正则化器有效评估映射的几何失真,并在四个基准测试中表现优于其他方法。

基于Gromov-Monge间隙的解耦表示学习

Apple Machine Learning Research Apple Machine Learning Research · 2025-04-17T00:00:00Z

本研究探讨了自编码器与深度聚类结合的框架,旨在无标签数据中有效学习低维非线性表示。研究结果表明,该方法显著提升了聚类任务的表示学习质量,为未来的深度学习与聚类研究奠定了基础。

An Introductory Survey on Autoencoder-based Deep Clustering: Sandboxes for Integrating Clustering with Deep Learning

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-04-02T00:00:00Z
什么是基础模型?

基础模型是训练于大量无标签数据的人工智能神经网络,能够执行多种任务,如文本翻译和医学图像分析。2023年发布了149个基础模型,应用范围广泛。基础模型通过无监督学习节省标注时间,适应性强,具备处理文本、图像和视频等多种数据类型的多模态能力。随着技术进步,基础模型在商业和工业中的应用不断增加,但也面临偏见和知识产权等挑战。

什么是基础模型?

NVIDIA Blog NVIDIA Blog · 2025-02-11T23:51:46Z

本研究提出了一种自监督预训练框架FSFM,通过掩码图像建模和实例区分方法,利用大量无标签的真实面孔学习人脸表征。实验结果显示,该模型在多个数据集上的迁移性能显著优于传统方法,增强了人脸安全任务的泛化能力。

FSFM:通过自监督人脸表征学习实现通用的人脸安全基础模型

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2024-12-16T00:00:00Z

本研究提出了一种无需调优的方法,解决物体插入和主体驱动生成中的高数据收集成本问题。通过利用无标签数据的共现现象,构建强大的配对数据集,训练高效的文本到图像扩散架构,提升物体身份保持和图像合成效果。

ObjectMate:一种针对物体插入和主体驱动生成的循环先验

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2024-12-11T00:00:00Z

本文探讨了知识蒸馏(KD)在大型语言模型(LLM)中的应用,提出了多种新机制以提升小型模型的性能。研究表明,通过生成无标签数据和多任务训练,可以在减少参数的情况下实现与大型模型相当的效果。同时,文章评估了不同蒸馏方法的效果,强调了其在自然语言处理和文档分析中的重要性,为未来研究提供了方向。

利用蒸馏技术进行文档理解:以FLAN-T5为案例研究

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2024-09-17T00:00:00Z

该研究提出了一种新的联邦学习框架,利用无标签开放数据集和半监督学习算法,显著降低通信成本并提高模型性能。实验结果表明,该框架在分类准确性上优于传统方法,尤其在大规模系统中表现突出。此外,研究探讨了有效使用预训练模型和减少模型间不一致性的方法,提出了多种改进算法以提升联邦学习的效率和准确性。

DFDG:无数据双生成对抗蒸馏的一次性联邦学ä¹

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2024-09-12T00:00:00Z

该研究提出了一种新颖的开放词汇3D实例分割方法,利用视觉-语言模型和无标签数据,显著提高了分割精度和泛化能力。通过多视角融合和生成类无关的3D掩码,该方法在多个基准测试中表现优异,克服了传统方法的局限性,具有广泛的应用潜力。

开放式三维点云实例分割

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2024-08-21T00:00:00Z

本文综述了机器学习中异常检测和开放集识别的研究进展,提出多种方法提升模型对OOD样本的识别能力。研究表明,通过新算法和数据扩充技术,在长尾数据集上显著提高了异常检测性能,强调无标签数据在增强模型鲁棒性方面的重要性。

长尾分布下的异常检测:关注尾部的优先级

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2024-08-13T00:00:00Z

本文提出了一种基于无标签数据的结构裁剪框架,旨在提高大型语言模型的推理效率并降低计算成本。通过重建技术和优化算法,实现了在不牺牲准确度的情况下对模型的有效剪枝,适用于资源受限设备,并在多个基准测试中表现出优越性能。

无需重新训练重建剪枝模型

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2024-07-18T00:00:00Z

本文介绍了多种大型语言模型(LLMs)的结构剪枝方法,包括基于概率学习的剪枝掩码、无梯度裁剪技术和无标签数据框架。这些方法在保持模型性能的同时,显著提高了计算效率和准确率,展示了在资源受限设备上的应用潜力。

MINI-LLM: 大语言模型的内存高效的结构化剪枝

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2024-07-16T00:00:00Z

本文探讨了大型语言模型(LLMs)推理性能的提升方法,包括LASER技术和无标签数据的结构裁剪框架。研究表明,通过选择性删除高阶权重和改进数据创建流程,LLMs在处理长文本和上下文学习方面表现更佳,尤其在结构化知识落地任务中取得显著进展。

学习减少:关于提高大型语言模型在结构化数据上的性能

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2024-07-03T00:00:00Z

本文讨论了知识蒸馏技术在模型压缩和性能提升中的应用。通过生成无标签数据和使用大型模型作为教师模型等方法,研究实现了在多个任务中提高小型模型的性能,同时在计算效率和存储需求上表现优异。

通过语言引导知识蒸馏的轻量级模型预训练

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2024-06-17T00:00:00Z

本文探讨了利用无标签开放数据进行语言模型的预训练和微调,提出了一种基于影响子集选择(ISS)的方法,以降低领域特定数据需求并提高训练效率。研究表明,使用小规模数据集可获得与大型模型相媲美的性能,并通过自主数据选择和优化算法显著提升模型在数学推理等任务中的能力。

MATES: 基于模型的数据选择与数据影响模型的高效预训练

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2024-06-10T00:00:00Z
  • <<
  • <
  • 1 (current)
  • 2
  • >
  • >>
👤 个人中心
在公众号发送验证码完成验证
登录验证
在本设备完成一次验证即可继续使用

完成下面两步后,将自动完成登录并继续当前操作。

1 关注公众号
小红花技术领袖公众号二维码
小红花技术领袖
如果当前 App 无法识别二维码,请在微信搜索并关注该公众号
2 发送验证码
在公众号对话中发送下面 4 位验证码
友情链接: MOGE.AI 九胧科技 1tok 菜鸟教程 Remio.AI DeekSeek连连 53AI 神龙海外代理IP IPIPGO全球代理IP 东波哥的博客 匡优考试在线考试系统 开源服务指南 蓝莺IM Solo 独立开发者社区 AI酷站导航 极客Fun 我爱水煮鱼 周报生成器 He3.app 简单简历 白鲸出海 T沙龙 职友集 TechParty 蟒周刊 Best AI Music Generator 模力方舟 Gitee AI

小红花技术领袖俱乐部
小红花·文摘:汇聚分发优质内容
小红花技术领袖俱乐部
Copyright © 2021-
粤ICP备2022094092号-1
公众号 小红花技术领袖俱乐部公众号二维码
视频号 小红花技术领袖俱乐部视频号二维码