


Qwen发布Qwen-Drive-1.0,以Qwen3.5-4B为骨干,外接BEV感知头与规划专家,用流匹配生成未来5秒轨迹,训练数据283万条,驾驶问答均分69.43。其核心是让感知、解释与规划共享表示并保留可检查接口,但文本与轨迹一致性不足,距量产尚远,需独立复现与闭环验证。
本文探讨了流匹配与半离散耦合的研究。流模型通过时间依赖的速度场生成数据,流匹配方法通过优化噪声与目标点的配对来训练模型。尽管最优传输(OT)流匹配在理论上有潜力,但实际应用有限。研究提出半离散流匹配(SD-FM),通过简化计算复杂度,提升了训练效果,超越了传统流匹配和OT流匹配。
CAR-Flow是一种条件感知重参数化方法,旨在通过调整源和目标分布来优化流匹配,从而缩短模型学习的概率路径,加快训练速度。在低维合成数据和高维自然图像数据(如ImageNet-256)上,CAR-Flow显著提高了性能,减少了FID值,同时仅增加了不到0.6%的参数。
SimpleFold是首个基于流匹配的蛋白质折叠模型,使用通用变换器层,训练规模达到3B参数,超越现有基准,挑战复杂架构依赖,推动蛋白质结构预测进展。
该研究提出了TeLoGraF方法,结合图神经网络与流匹配技术,克服了现有时序逻辑规划的不足。实验结果显示,该方法在时序逻辑满足率和推断速度上优于传统算法。
本文介绍了机器学习中扩散模型和流匹配的基础数学知识,旨在以简单易懂的方式教授扩散。教程分为五部分,涵盖扩散基本概念、随机和确定性扩散采样器的构建、流匹配相关内容,以及与更广泛文献的联系,强调实际应用中的设计选择。
本研究提出了一种新颖的3D重组框架GARF,旨在解决现有方法在真实世界断裂中的通用性不足问题。通过预训练和流匹配技术,GARF在复杂断裂模式识别方面表现优异,实验结果显示其性能显著优于现有方法,具有强大的应用潜力。
本研究提出了一种新型视觉标记器V2Flow,旨在解决传统视觉标记技术的不足。V2Flow通过流匹配将视觉标记与大型语言模型词汇结合,实现高保真重构和自回归视觉生成。实验结果表明,V2Flow在生成质量和标记整合方面优于主流VQ标记器,具有重要应用潜力。
本研究提出了一种改进的四元数流匹配方法(ReQFlow),有效解决了蛋白质主链生成中的设计不足和效率低的问题,显著提升了生成速度和质量。实验结果表明,该方法优于现有主流技术。
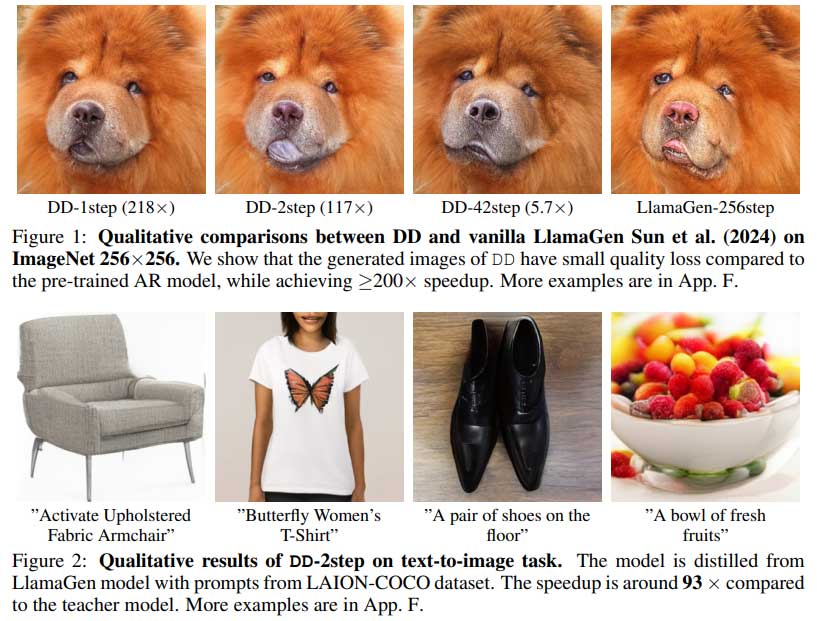
自回归(AR)模型在图像生成中取得了显著进展,但生成速度慢限制了应用。清华大学和微软研究院提出的Distilled Decoding(DD)方法,通过流匹配技术,将生成步骤从数百步减少到一两步,显著提升了速度,同时保持图像质量。这一创新为AR模型的实时应用开辟了新领域。
扩散模型与流匹配本质上等价,尽管实现方式不同。扩散模型通过去噪声逐步恢复数据,而流匹配通过可逆变换映射分布。研究表明,两者可灵活结合,利用不同采样策略提升生成效果。
该研究全面回顾了流匹配框架及其数学基础,填补了学习资源的不足。文章整合了设计选择和扩展,并提供了PyTorch包,方便研究者应用。结果表明,流匹配在生成建模中具有强大潜力,适用于图像、视频和音频等领域。
该研究探讨了流匹配如何加速AI图像生成并提升质量。通过将流匹配与潜在扩散模型结合,减少训练时间并保持高质量输出,引入新高斯假设以提高计算效率,实现更快收敛,并在图像生成基准上展现更佳样本质量。
本研究探讨流匹配(FM)与扩散概率模型(DPMs)在无训练条件生成中的关系,提出两种后验采样方法,实验结果优于现有技术。
本研究提出了一种新方法,通过流匹配框架在嵌入空间中直接回归动态函数,解决了神经常微分方程在成对数据学习中的训练难题,显著提升了回归和分类任务的性能。
本研究提出了EnzymeFlow模型,结合流匹配和共进化原理,克服了传统酶功能预测的局限性。该模型能够动态生成特定底物和反应的酶催化口袋,实验证明其在酶工程和合成生物学中的有效性。
本文探讨了一种基于连续归一化流的生成模型,结合流匹配方法与扩散路径,提升了训练的鲁棒性和稳定性。通过多种算法优化生成过程,实现高质量样本生成和高效图像合成,尤其在单细胞轨迹预测任务中表现优异。研究显示,该方法在多个数据集上显著提升了性能。
本文提出了一种在预训练自编码器的潜在空间中应用流匹配的方法,以提高高分辨率图像合成的计算效率和可扩展性,并实现各种条件下的图像生成、修复和语义到图像的生成。经实验证明,该方法在各种数据集上均有效,并提供了理论控制。
完成下面两步后,将自动完成登录并继续当前操作。