本研究提出了一种新方法Depth-μP,旨在解决预测编码网络(PCN)在训练超过100层深度网络时的困难。尽管存在不稳定性,μPC在简单分类任务中表现出竞争性能,能够稳定训练高达128层的残差网络,并实现零-shot迁移学习。
本研究提出在深度非负矩阵分解(NMF)网络中引入局部特征交互,以提升性能。通过在局部NMF模块后增加混合NMF正向活动模块,显著提高了基于NMF的深度网络在基准数据上的表现,超越了传统深度卷积网络。这为深度网络的生物学可行性提供了新视角。
本研究提出了一种分数连接方法,解决了深度网络训练中超连接的高内存访问成本问题。通过将隐藏状态划分为多个部分,分数连接在大规模语言任务上显著优于传统的残差连接。
本研究提出了PTEENet,通过引入“捷径”优化深度网络的推理计算成本。该方法扩展了BranchyNet和EEnet架构,允许在预训练模型上附加分支,从而提高推理效率,实验结果表明显著降低了计算成本。
本文探讨了合成数据在计算机视觉中的应用,强调其在训练深度网络时的优势。研究表明,合成数据能显著减少对真实图像的需求,并通过与真实数据结合提高模型性能,尤其在物体检测和图像分割等任务中表现出色,未来有望在人工智能领域得到更广泛应用。
本文介绍了多种细粒度图像识别的新方法,包括基于属性的多任务适应损失、端到端深度网络、数据增强和新任务UFG-NCD等。这些方法在多个数据集上显著提高了识别准确性和泛化性能,为细粒度图像分析提供了有效工具和指导。
本研究提出了InfoDisent模型,旨在提高图像分类网络的决策可解释性。该模型结合了后置和内在方法的优点,有效解耦深度网络的决策信息,提供清晰的分类解释,并在多个基准数据集上验证了其有效性。
本文介绍了一种PSF感知的深度网络,用于校正光学像差。研究提出了多种方法,包括卷积神经网络和神经镜头模型,以优化镜头设计和提升成像质量。实验结果表明,这些方法有效减少了图像退化,降低了计算开销,并提高了深度神经网络的鲁棒性,为计算摄影提供了新见解。
本文介绍了一种名为DOC的深度网络架构,能够在单幅图像中检测物体边界并估计遮挡关系。研究利用深度卷积神经网络定位语义部件,展示了在现实图像中的优越性能,并提出了多种基于学习的方法,改进了遮挡区域和深度估计的精度,推动了点云处理和面部数据集的研究进展。
深度网络的末期化训练导致神经坍塌现象,简化了分类器的决策规则。研究表明,采用无限制特征模型和Simplex编码标签插值可以改善分类性能,尤其在类别不平衡的情况下。提出的框架在少样本类增量学习中表现优越,且神经崩溃与批归一化和权重衰减相关。研究扩展了神经崩塌理论,验证了其在不平衡类别下的存在及影响。
本文提出了可编程梯度信息(PGI)这一新概念,以解决深度网络中的信息损失问题。通过设计广义高效层聚合网络(GELAN),研究表明该架构在目标检测任务中表现优越,能够更有效地利用参数,并提升从头训练模型的性能。
本文探讨神经网络损失地形中的线性模式连接(LMC),分析架构、训练策略和数据集对其影响。提出新的线性连接概念LLFC,并通过实验验证其在深度网络优化中的重要性。研究表明,特定架构的不变性对实现LMC至关重要,同时探讨了对抗鲁棒性与模态连通性的关系,揭示了优化过程中的内在规律。
该研究提出了多种知识蒸馏方法,如UNIX、KA、DTD、CrossKD和AKD,旨在提升深度网络的不确定性估计和性能。在CIFAR100和ImageNet等数据集上取得了显著成果,特别是在轻量级模型和目标检测任务中表现优异。
RAFT是一种新型深度网络结构,专注于光流估计,具有高效的推断和训练速度。通过引入注意力机制和架构改进,RAFT在多个数据集上实现了显著的性能提升。相关方法如RAFT-Stereo和SMURF进一步优化了光流学习和立体匹配,展现出在准确性和效率上的优势。
本文探讨了深度网络对抗扰动攻击的多种方法,包括生成无关对抗扰动(UAPs)和新型攻击策略。研究表明,通过优化损失函数和利用模态交互,可以显著提高对抗攻击的成功率,并在多个数据集上验证了这些方法的有效性。
本文研究了Centered Kernel Alignment(CKA)算法在机器学习中的敏感性及其弱点,指出CKA值易被操控而不需实质性改变模型。提出了一种基于规范相关分析的相似度指数,以增强表示比较的可靠性。同时,探讨了深度网络中激活模式的相似性度量及其对模型性能的影响,强调了评估指标的缺陷,为未来研究提供了基础数据。
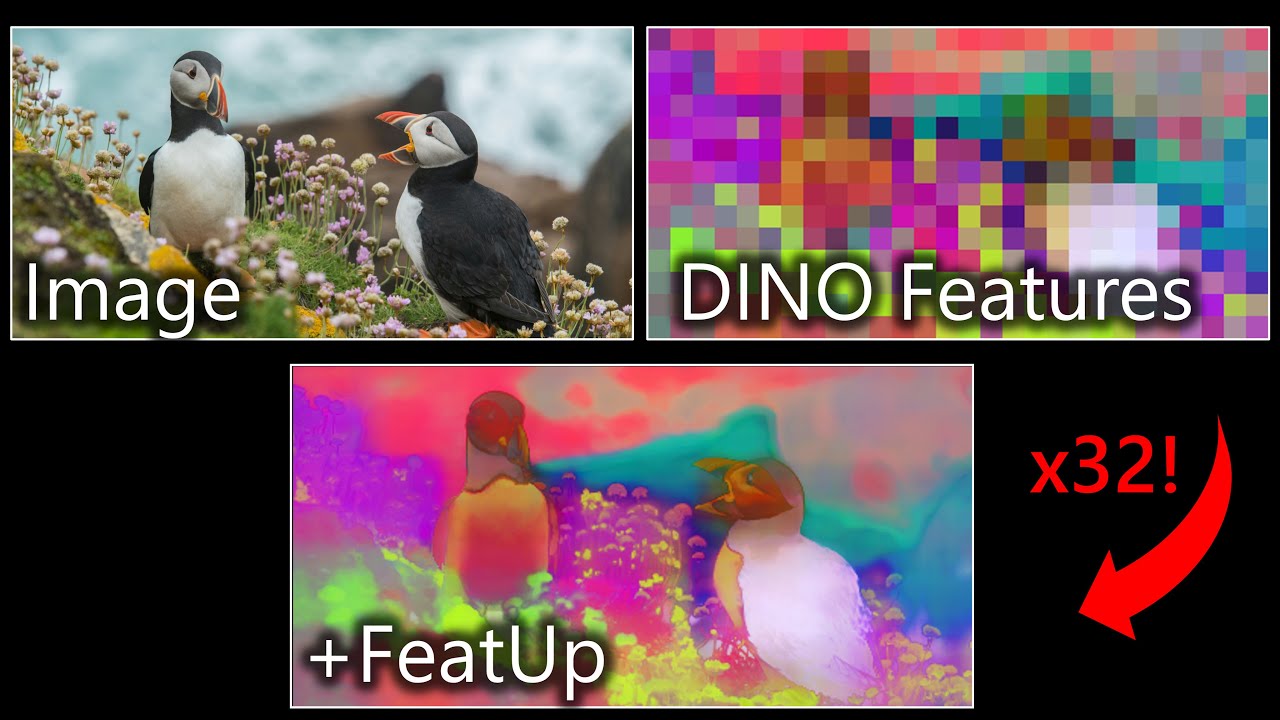
MIT CSAIL研究人员开发的FeatUp算法能够提升深度网络的分辨率,改善物体识别和深度测量等计算机视觉任务的表现。该算法通过微调图像生成高分辨率特征,帮助捕捉场景的高低级细节,显著提高性能。FeatUp在自动驾驶和医疗成像等领域具有广泛应用潜力,未来有望成为深度学习的基础工具。
该文综述神经视频编码进展:利用深度网络、多尺度运动补偿、自适应熵编码与注意力机制提升压缩性能;分层B帧、上下文多样性和条件编码显著节省码率;AlphaVC超越VVC;并实现移动端1080p实时解码及面向机器视觉的多尺度特征压缩。
本文综述相机校准领域新进展,涵盖基于高斯过程的去畸变方法(单幅方格图即可校准)、基于基础矩阵的迭代自标定(提升焦距估计精度)、CaLiCa深度网络(相机与激光雷达自动校准)、自监督框架(实时学习内外参)、深度分类优化自动对焦、通用相机模型全自动标定流程、街景重建校准全球交通摄像头、互信息法在线更新相机-激光雷达外参、深度视频合成可重对焦,以及后投影回归法提升绝对姿态估计精度。
本文综述盲图像质量评估(BIQA)研究进展,重点包括:利用多畸变数据库训练深度网络以提升实验室与野外评估精度;提出dipIQ、dilIQ、PQR等方法及KonIQ-10k、PIQ23、BIQ2021等数据集;针对合成与真实失真分布偏移,构建统一模型和跨数据集强健模型,显著提高泛化性能。
完成下面两步后,将自动完成登录并继续当前操作。