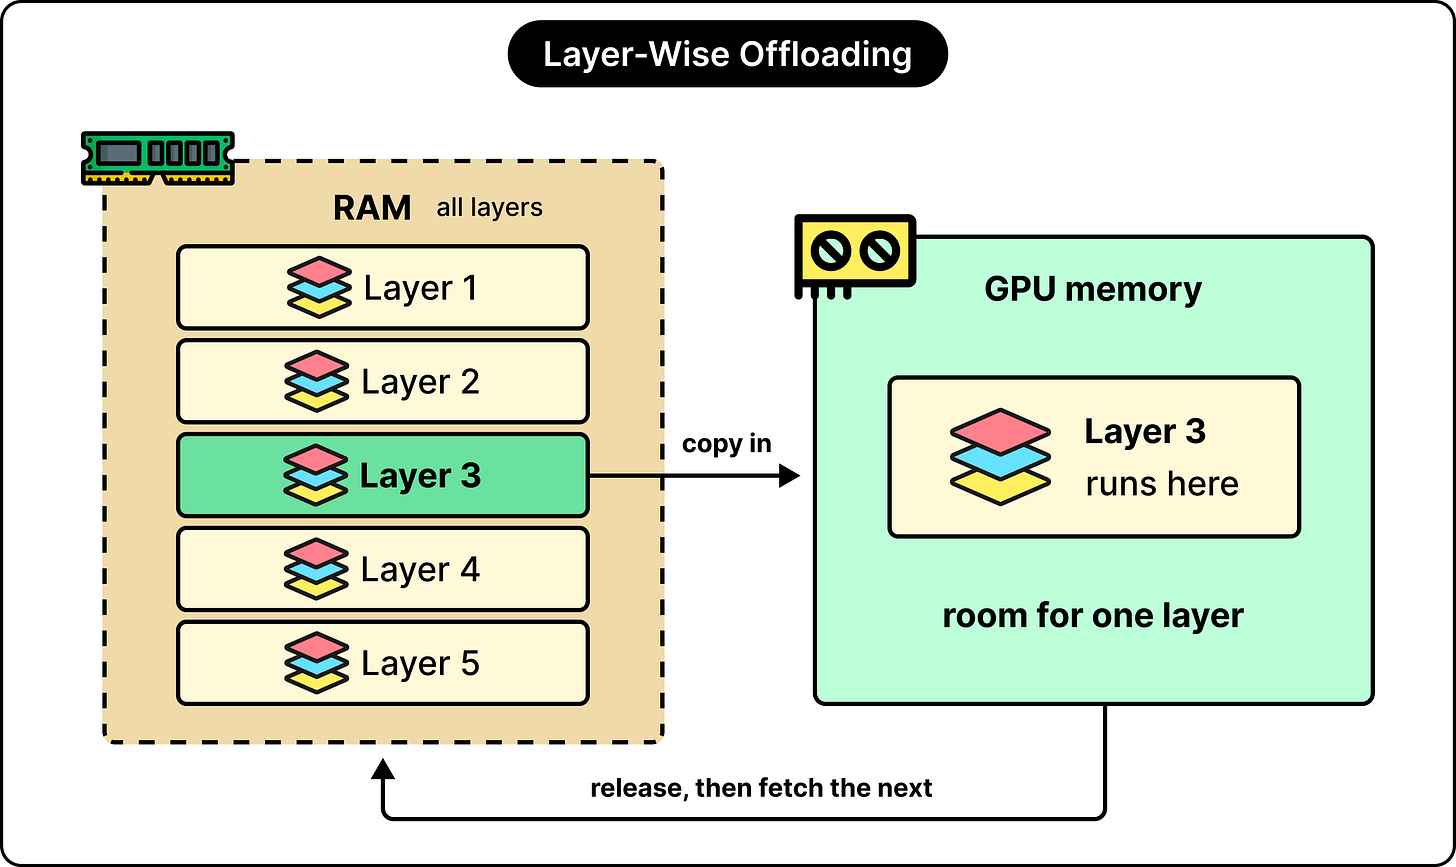
大模型在普通硬件上运行需降低内存占用与计算量。主要技术包括:量化压缩权重精度(如8B模型从16GB降至4GB)、分层卸载按需将权重移入GPU、混合专家仅激活部分参数、蒸馏用小模型学习大模型、剪枝去除低贡献权重、推测解码用小模型预生成再验证。KV缓存和FlashAttention等软件优化也能提升效率。目标是在硬件预算内平衡质量与响应速度。
Thinking Machines发布开源模型Inkling,采用混合专家架构,总参数9750亿,但每次推理仅激活约410亿参数。该模型结合滑动窗口与全局注意力层,支持百万级token上下文,并使用相对位置编码以避免外推问题。Inkling支持图像和音频输入,并引入可调推理努力参数,旨在便于用户定制和微调。
开放权重模型在人工智能领域带来了变革。不同团队通过共享技术报告和模型参数,促进了合作与创新。主要架构为混合专家(MoE),各团队在注意力策略、专家数量和训练方法上有所不同。这种开放生态系统推动了技术进步,尽管闭源团队也在进行创新。
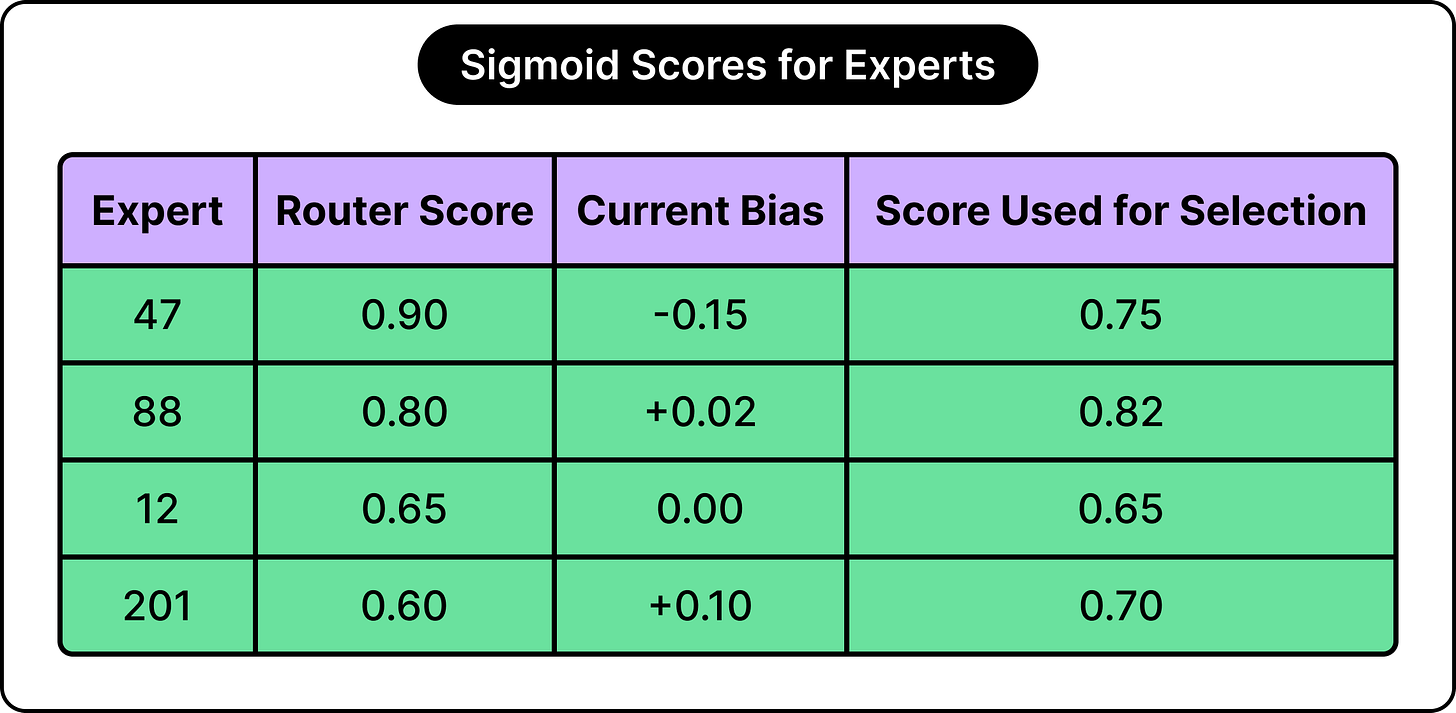
本文介绍了SpecMD,一个用于评估混合专家(MoE)模型缓存策略的标准化框架。研究表明,MoE专家的访问模式与传统的时间局部性假设不符,因此提出了一种新的Least-Stale驱逐策略,显著减少了缓存冲突,提高了命中率。实验结果验证了该策略在不同硬件配置下的有效性。
2024年,混合专家(MoE)架构成为大模型的主流,开源项目如Mixtral和DeepSeek推动了其发展。MoE通过减少激活参数显著降低计算成本,同时提升模型表达能力,适合算力充裕的场景。关键技术包括细粒度专家、共享专家和改进的负载均衡策略。未来,MoE将向更大规模和动态专家数发展。
混合专家(MoE)架构通过将AI模型划分为多个专门子网络来优化性能,仅激活相关专家以减少计算需求。Mixtral模型展示了MoE在实际应用中的高效性,尽管存在负载均衡挑战,但通过“噪声top-k”技术可实现更均衡的专家激活。MoE架构在提升AI系统效率方面具有重要潜力。
本文介绍了Voyage AI在嵌入模型扩展方面的研究,特别是通过混合专家(MoE)架构提高效率。Voyage-4-large模型实现了75%的参数减少,同时保持检索准确率,显著降低计算成本和延迟。MoE模型通过优化设计有效解耦知识容量与计算成本。
Voyage 4系列推出四种文本嵌入模型,具共享嵌入空间,支持不同模型间的互用。voyage-4-large采用混合专家架构,提升检索准确率并降低40%成本,适合高效检索需求的客户和开发者,支持多维度嵌入,优化查询与文档嵌入的独立调优。
DeepSeek发布论文《条件记忆》,提出将“条件记忆”作为大语言模型的新稀疏维度,以解决知识检索的低效问题。研究表明,结合条件记忆与混合专家(MoE)可显著提升模型性能,特别是在知识推理和代码生成方面。预计新模型DeepSeek V4将应用此技术,进一步增强AI竞争力。
本文介绍了大语言模型的优化方法,包括蒸馏、量化、超长上下文和混合专家。蒸馏通过大模型指导小模型以减小体积并保留能力;量化通过降低精度节省内存;超长上下文利用局部窗口和环形注意力优化计算;混合专家则选择性激活部分专家以减少计算量。这些方法有效提升了模型的效率和性能。
本文探讨了AI的核心技术,包括Transformer与混合专家(MoE)的比较、微调大模型的五种方法、RAG系统的改进及智能体设计模式,强调智能体在任务中的主动性和自我评估能力,从而提升AI的输出质量和效率。
本文介绍了AI中的核心技术,包括混合专家(MoE)与Transformer的比较、微调大模型的五种方法(如LoRA、VeRA等),以及改进RAG系统的智能体设计模式。智能体通过自我评估和规划提高输出质量,MCP协议优化了工具的访问和使用。
OpenAI推出了gpt-oss-120b开源模型,拥有1200亿参数和混合专家架构,适用于文本生成和理解。开发者可根据Apache 2.0许可证进行调整,支持实时任务执行。该模型性能与OpenAI的o4-mini相当,并可在Heroku平台上简化AI基础设施,提供透明定价。
智谱于7月28日发布了新一代旗舰模型GLM-4.5,包括GLM-4.5和轻量级GLM-4.5-Air,参数量分别为3550亿和1060亿。该模型采用混合专家架构,具备强大的推理和编程能力,API调用价格低,性能优于同类产品,成为开发者的高性价比选择。
混合专家(MoE)架构在变换器模型中引入稀疏性,允许模型高效扩展而不增加计算成本。MoE通过多个专家模型处理输入,使用路由器选择合适的专家。每个变换器层都有独立的专家集,激活部分参数以提升性能。MoE的实现包括专家网络、路由机制和输出组合,能够在保持低计算资源的同时提升模型表现。
Qwen3系列模型在开源大模型领域取得突破,具备动态思维、优化的混合专家架构和强大的多语言能力。其训练策略包括三阶段预训练和后训练优化,表现优异于数学推理、代码生成和多语言任务。未来将进一步优化超长上下文和多模态融合,推动AI民主化。
本研究探讨了混合专家(MoE)层在深度学习中的表达能力,提出增加活跃专家数量能够显著提升模型性能,实验结果验证了这一理论。
Meta推出的Llama 4模型(Scout 17B和Maverick 17B)现已在Amazon Bedrock上上线,具备多模态功能和混合专家架构,支持多语言和图像理解,适用于企业智能代理和内容创作等多种场景。
斯坦福大学CS336课程介绍了混合专家模型的最新进展,强调其在高性能系统中的重要性。该模型通过稀疏激活多个子组件,提高了计算效率和性能。研究表明,在相同计算量下,混合专家模型的训练效果优于密集模型。开源系统DeepSeek展示了这一架构在大规模训练中的优势。
研究表明,原生多模态模型(NMM)在早融合和后融合架构中性能相当,早融合在低参数下表现更佳且训练效率高。结合混合专家(MoE)可显著提升性能。随着计算预算增加,两者性能趋近,稀疏性有利于早融合。建议在统一架构内进行多模态特化,以更好地处理异构数据。
完成下面两步后,将自动完成登录并继续当前操作。