本文介绍湖仓表的删除与更新机制。由于Parquet文件不可变,系统采用位置删除文件记录被逻辑删除的行位置,扫描时跳过这些行。删除策略分为写时复制与读时合并,DuckLake采用后者。DELETE操作先扫描匹配行位置,再写入删除文件并登记元数据;UPDATE在同一事务中拆分为DELETE加INSERT以保证原子性。扫描时加载删除位置并过滤。该方案避免重写大文件,代价是读取开销增加,可通过压缩定期合并缓解。
惠普在Databricks上构建营销数据基础,借助CustomerLake和Genie,将受众创建时间从2-3个月缩短至2小时,CDP成本最多降低40%,可用营销数据扩大90%。公司将数百个数据孤岛整合为少量湖仓,实现治理下的数据共享,数据请求从三个月缩短至48小时。通过语义层和AI代理,营销人员可自助使用数据,并计划将身份解析纳入自有环境,打通B2C与B2B数据。
开放数据目录的核心在于数据可移植性。Unity Catalog将托管表存储在用户自有云存储中,由目录负责优化维护,并支持Iceberg REST规范的REGISTER与UNREGISTER,使表可在目录间迁移而无需复制数据。相比之下,许多平台将表锁定在自有存储和专有格式中,迁移需导出重写。Unity Catalog托管表保留完整功能且无锁定,未来还将支持原地转换外部表。
Databricks 宣布 Delta Lake 和 Apache Iceberg 多语句事务正式可用,成为首个在湖仓架构原生支持该功能的平台。该功能支持跨多表原子操作、行级并发、Unity Catalog 治理及仓库开发工具集成,可减少数据重复与运维复杂度,适用于 ETL、仓库迁移和 Write-Audit-Publish 等场景。
Atlassian每天处理440亿起安全事件,因日志格式不统一,采用OCSF标准并在Databricks上构建自助式安全湖仓。通过ETL、表优化和Go结构体嵌入模式,查询速度提升95%,成本降低约三分之二,支持500多种威胁检测信号,实现跨源关联与AI辅助分析。
湖仓快照与时间旅行机制:每次增删改生成递增快照ID,记录表、列和数据文件状态,元数据行以可见区间标记生效与失效。查询时传入历史快照ID可回溯任意版本,实现一致性读取。快照表记录变更历史,支持审计与调试。
湖仓查询阶段中,SELECT 查询先解析表与快照,获取该快照的数据文件,再利用列统计信息裁剪文件,跳过不可能匹配的文件。存活文件随后过滤删除行、读取 Parquet、按谓词筛选并投影列。统计裁剪、删除过滤、列投影和缺失列补 nil 共同实现高效扫描与模式演进。
湖仓系统第三阶段写入管道中,INSERT 先将数据写入 Parquet 文件并收集列统计,再原子注册到元数据目录。核心原则是先写文件后更新元数据,确保崩溃时仅产生孤儿文件,避免元数据指向缺失文件。事务提交时创建新快照,记录写入文件、列统计与审计日志。
湖仓项目第二阶段使用Go语言的parquet-go库读写Parquet文件。Parquet为列式存储,记录每列min、max、null_count统计信息,支持文件裁剪以减少I/O。写入时通过StatsCollector实时收集统计;读取时按列投影,仅读所需列。每列带field ID,重命名后仍能正确匹配,为模式演进奠定基础。文件以UUID命名避免冲突。
Databricks 正式发布原生 IP 函数,使 IP 地址分析成为湖仓上的高性能 SQL 工作负载。此前处理 IP 和 CIDR 需依赖正则、位运算或 UDF,性能差且难维护。新函数原生支持 IPv4/IPv6、CIDR 包含判断和范围连接,可加速威胁检测与网络可观测性,成本比传统仓库低 2 至 6.4 倍。
本文介绍用Go构建小型湖仓引擎,模仿DuckLake架构:元数据存于Postgres,数据用Parquet。核心是八张元数据表,涵盖快照、表、列、数据文件、列统计、删除文件等。通过begin_snapshot和end_snapshot实现快照可见性与时间旅行。相比Iceberg的清单文件树,数据库方案让文件裁剪变成SQL查询,原子提交只需事务,但依赖运行中的数据库。
Databricks营销团队将营销数据统一到受治理的湖仓,并基于Genie Agents构建对话式分析助手Marge,让营销人员用自然语言快速获取可信答案。团队通过完善数据模型与元数据、提供可信逻辑和示例、明确业务术语、持续收集反馈来建立信任,并从邮件营销单一场景起步逐步扩展。Marge已服务超85%营销人员,回答逾5000个问题,使数据使用频率提升三倍。
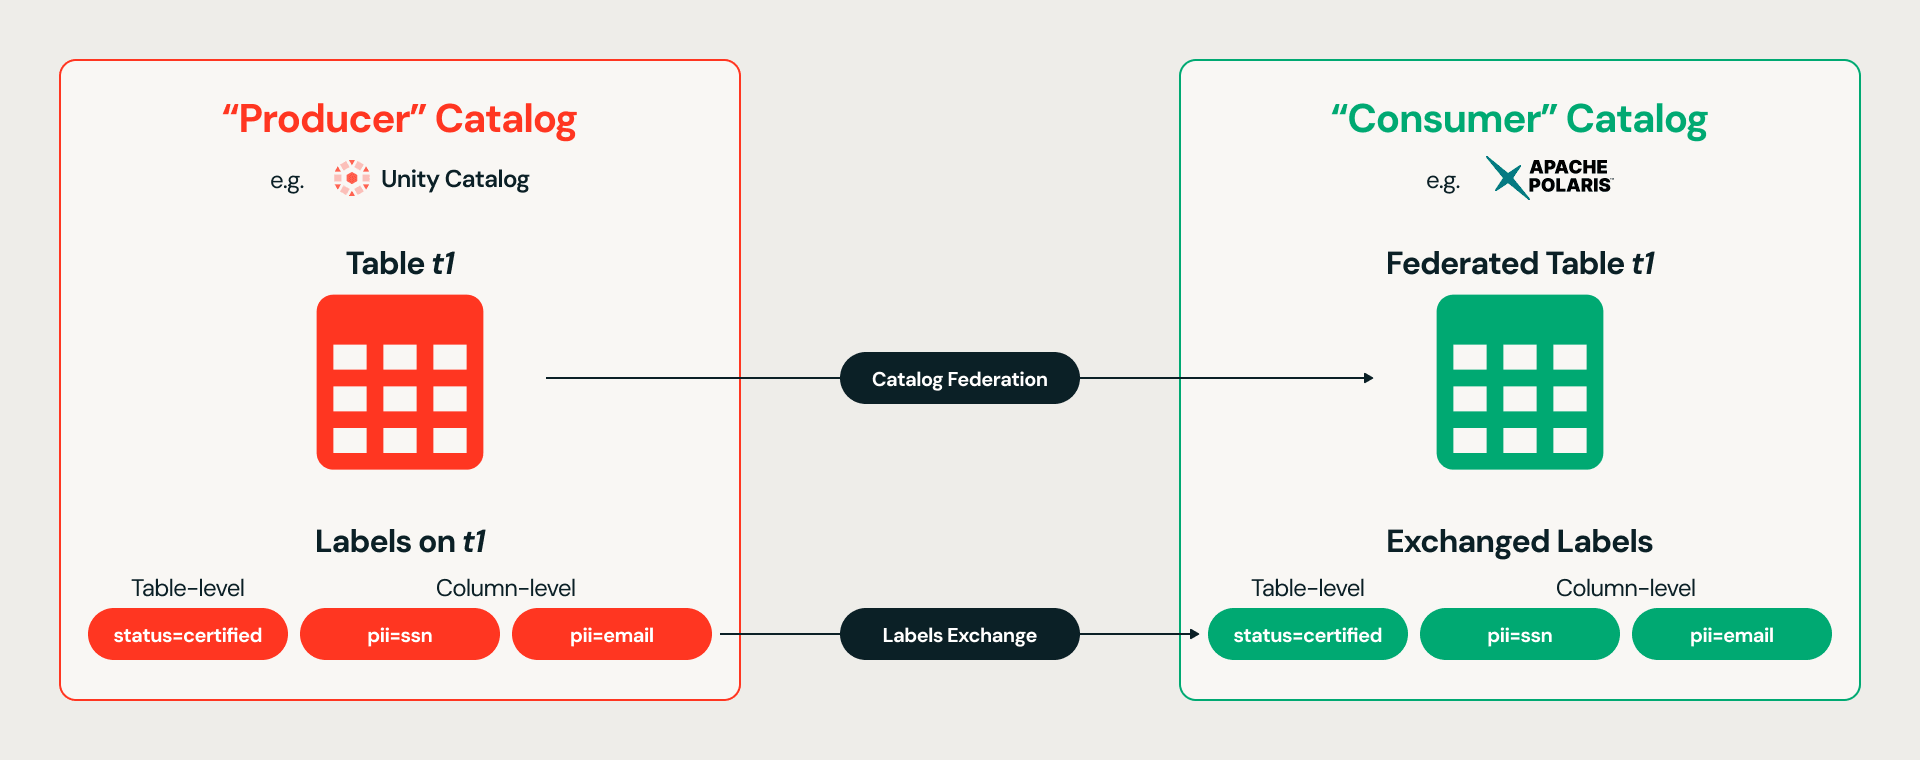
Apache Iceberg 社区新增两项 REST Catalog 规范:读限制和目录标签。读限制允许目录将行、列过滤策略委托给受信引擎执行,适用于引擎直连目录场景;目录标签通过键值元数据在联邦目录间传递治理上下文(如 PII 标记),由消费方目录本地执行策略。两者分别解决委托执行与跨目录治理可移植性问题,是开放湖仓统一治理的重要进展。
Databricks将在VLDB 2026展示多项创新,包括Reynold Xin的主题演讲,介绍AI代理时代数据库工程的“第三黄金时代”,提出Lakebase和LTAP新范式。四篇论文涵盖Lakebase架构、Spark Structured Streaming演进、AutoLiquid自动数据布局优化及Ultron历史查询优化,另有Enzyme演示,旨在提升湖仓性能与实时分析能力。
DuckLake是一种基于DuckDB扩展的湖仓格式,将元数据与数据分离:目录(本地文件或PostgreSQL)存储表结构、快照和文件指针,Parquet文件存储实际数据。支持本地运行及PostgreSQL+MinIO生产部署,通过分区将文件组织在S3中。查询时利用目录中的列统计进行分区剪枝和谓词下推,可跳过无关文件,显著提升查询效率。
本文介绍将传统数据仓库中的存储过程迁移至Databricks湖仓的方法。通过示例展示游标、临时表、事务等SQL脚本的翻译过程,保留原业务逻辑,无需重写为Python或Spark。迁移后由Unity Catalog管理,支持访问控制和血缘追踪,并发处理更高效,迁移时间可减少50-75%。
Unity Catalog现已进入公共预览阶段,支持外部引擎访问管理的Delta表。企业可以在统一治理下灵活使用多种引擎,享受性能优化和成本节约。通过开放API,外部引擎如Starburst和DuckDB可直接与Unity Catalog集成,实现数据的创建、读取和写入。这提升了数据治理和跨引擎的互操作性,确保了数据访问的安全性和一致性。
本文总结了RocksDB的内核机制,探讨了存储引擎的选择决策树,包括OLTP、OLAP和湖仓等场景。RocksDB适合写密集型负载,适用于Flink、TiKV等嵌入式应用。文章对比了RocksDB与InnoDB、列存和湖仓的特点,指出各自的适用场景和优化方向,并提供了存储栈和数据平台的阅读地图,以帮助读者理解不同存储引擎的关系与应用。
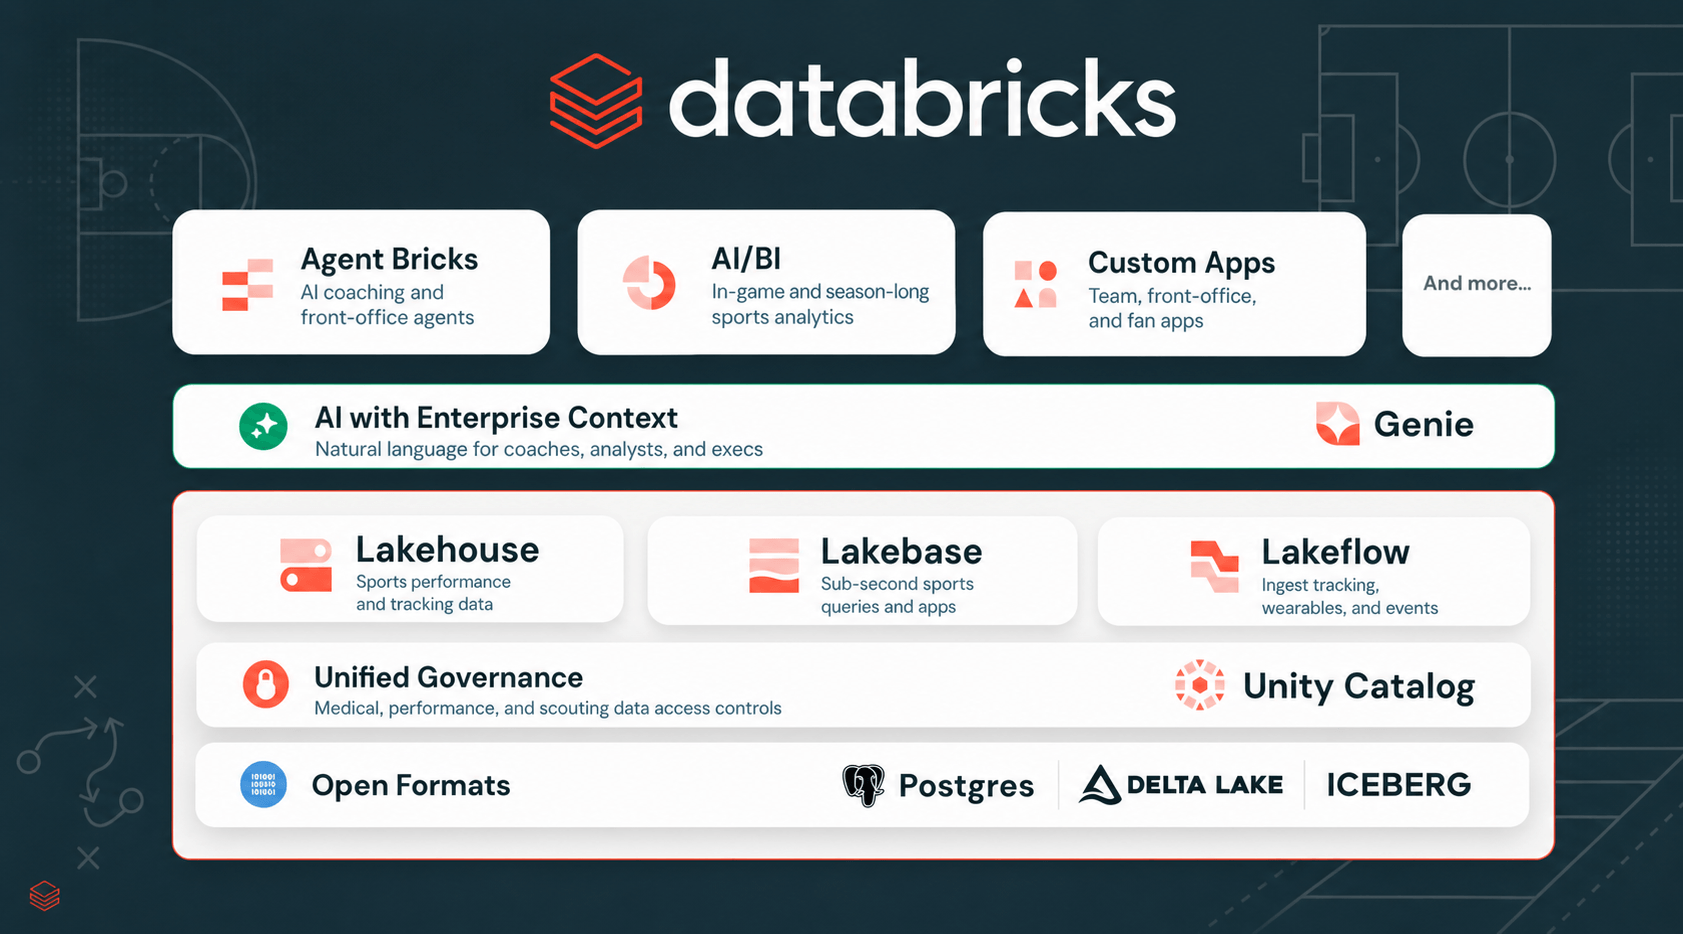
在专业篮球比赛中,Hawk-Eye摄像头每秒生成大量数据,帮助球队分析运动员表现和预防伤病。Databricks数据智能平台整合多种数据源,提升决策效率,支持教练和管理层实时获取关键分析,推动运动员健康和比赛胜利。
Databricks推出了针对Google Sheets的连接器,使用户能够直接在Sheets中访问实时的Databricks数据,从而提升决策效率并减少数据孤岛。Nubank利用该连接器增强数据文化,支持非技术用户进行数据探索,推动数据驱动决策。
完成下面两步后,将自动完成登录并继续当前操作。