小红花·文摘
  • 首页
  • AI Tokens🪙
  • 排行榜🏆
  • 直播
  • FAQ
沉浸式翻译 immersive translate
Dify.AI

这一周,对日本街机行业来说并不好受。不少网友都晒出了附近街机厅的照片,平时热闹非凡的机台面前空着一大片,整排整排的街机被晾在那里。明明是旺季,一整排《舞萌DX》都无人游玩这一异常始于11月1日下午3点,SEGA...

后台服务器停摆,日本街机迎来灾难一周

游戏研究社 游戏研究社 · 2026-11-06T16:00:00Z

作者批评“AI式中文”的多种语言问题:单音节词在停顿前滥用、防御性声明冗余、可选表单项“能填尽填”、黑话堆砌、破折号与“不是而是”误用、书面口语混搭。这些特征源于模型以语义而非韵律主导输出,并经RLHF与互相蒸馏放大。作者厌恶的是似是而非、扰乱中文表达的语言,而非AI本身。

AI 式中文,zh_llm,或者更灾难的东西

Bluemangoo;s Blog Bluemangoo;s Blog · 2026-11-06T12:54:54Z
安全灾难:越来越多的黑客开始利用iOS和安卓旧漏洞发起攻击 用户访问挂马网站就会被感染

安全公司SEKOIA报告称,APT29利用DarkSword工具及旧版安卓、iOS漏洞,篡改Plerdy统计脚本,对数千网站批量挂马,用户访问即被无感植入后门,导致Cookie、凭证、聊天数据库等泄露。漏洞虽已修复,旧系统用户仍面临风险,应及时更新iOS和Chrome。

安全灾难:越来越多的黑客开始利用iOS和安卓旧漏洞发起攻击 用户访问挂马网站就会被感染

蓝点网 蓝点网 · 2026-11-06T04:00:00Z
如何开展灾难恢复就绪演练

本文介绍五步DR就绪演练:启动会明确恢复边界并指定各依赖负责人;评估依赖缺口并落实修复责任;按桌面推演、计划切换、突袭演练逐级验证;将发现反馈至三项业务决策并更新恢复承诺;每季度复查以防漂移。案例中首次演练因边界遗漏、依赖受限、资源未预置及手动DNS切换失败,超时逾两倍;四个月内整改后第二次演练成功。

如何开展灾难恢复就绪演练

AWS Architecture Blog AWS Architecture Blog · 2026-11-02T17:26:49Z
验证你的灾难恢复承诺:从受控测试到真实环境就绪

文章指出单次计划演练只能证明机制可用,无法暴露协调、依赖和预置资源等真实隐患,建议采用四级递进验证:桌面推演明确责任与边界,计划切换测量实际RTO/RPO,突袭演练检验执行准备,故障注入演练发现未建模依赖;每级发现的问题应反馈到恢复边界、业务目标和依赖承诺三项决策,持续迭代强化灾难恢复能力。

验证你的灾难恢复承诺:从受控测试到真实环境就绪

AWS Architecture Blog AWS Architecture Blog · 2026-11-02T17:26:33Z
Amazon API Gateway WebSocket API 的多区域灾难恢复

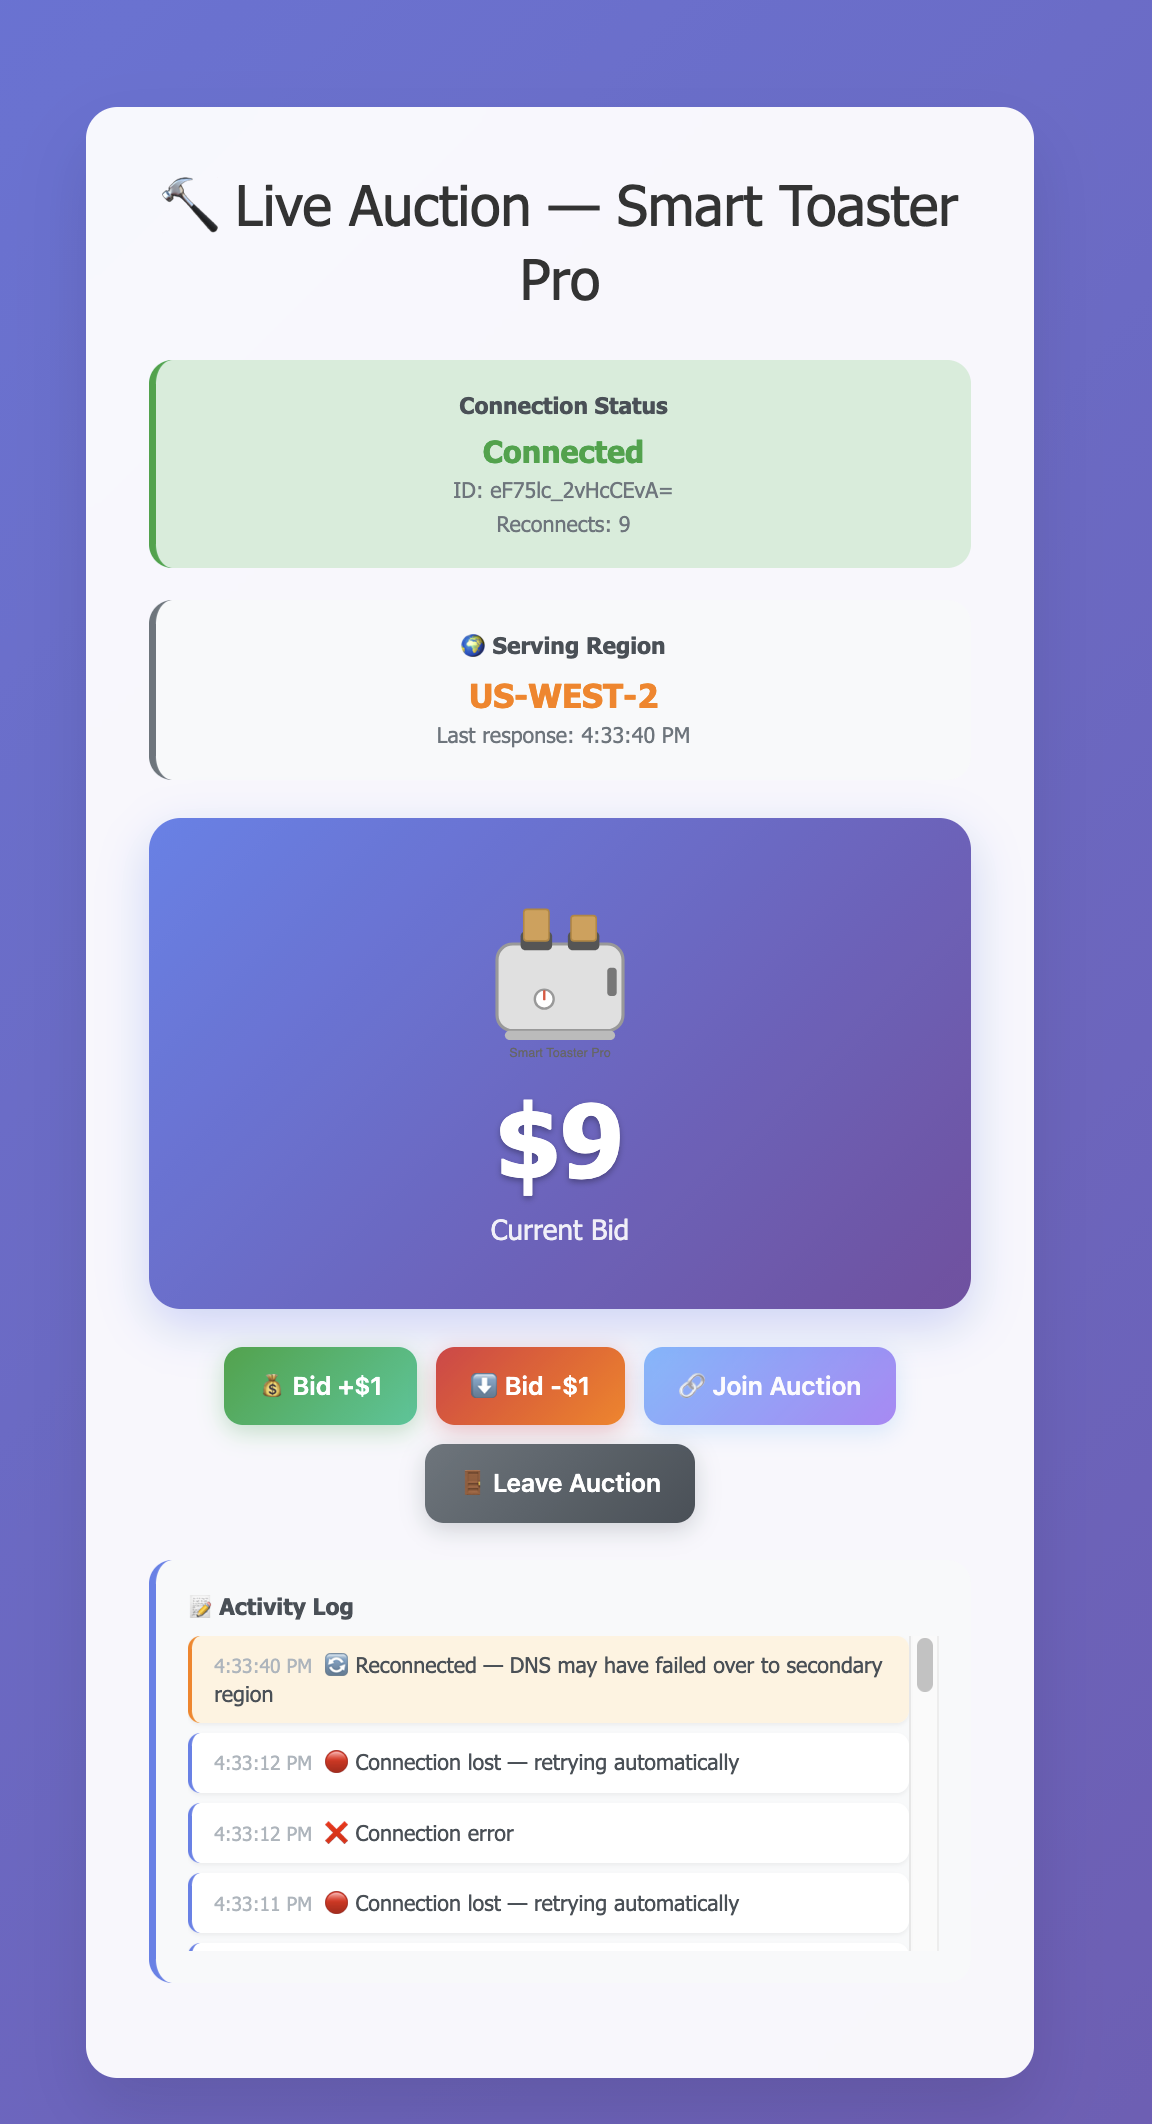
本文介绍为 Amazon API Gateway WebSocket API 构建多区域灾难恢复的设计模式:采用主备双区域架构,通过 Route 53 DNS 故障转移、DynamoDB 全局表跨区域复制状态、Lambda 金丝雀健康探测及客户端指数退避重连,实现区域故障时自动切换并恢复会话。核心是将应用状态与连接分离,以用户 ID 而非连接 ID 存储状态,使客户端重连后能恢复上下文。

Amazon API Gateway WebSocket API 的多区域灾难恢复

AWS Architecture Blog AWS Architecture Blog · 2026-10-14T14:31:55Z
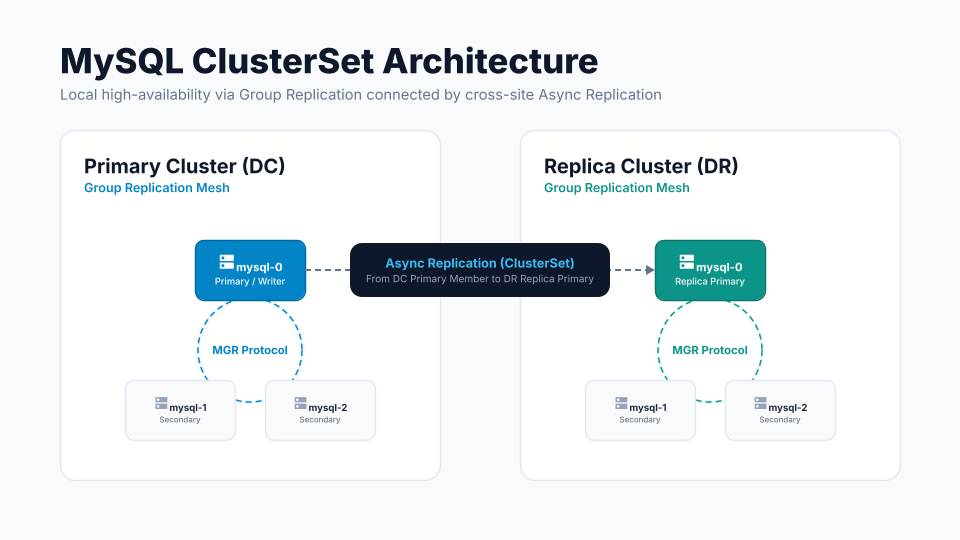
超越单一集群的组复制:使用 Percona (PS MySQL) Operator 实现数据中心-灾难恢复

该文讨论MySQL数据目录中出现过多GCache页面文件的问题,分析其成因及对数据库的影响,并给出排查与清理建议。

超越单一集群的组复制:使用 Percona (PS MySQL) Operator 实现数据中心-灾难恢复

Percona Database Performance Blog Percona Database Performance Blog · 2026-09-17T06:43:32Z
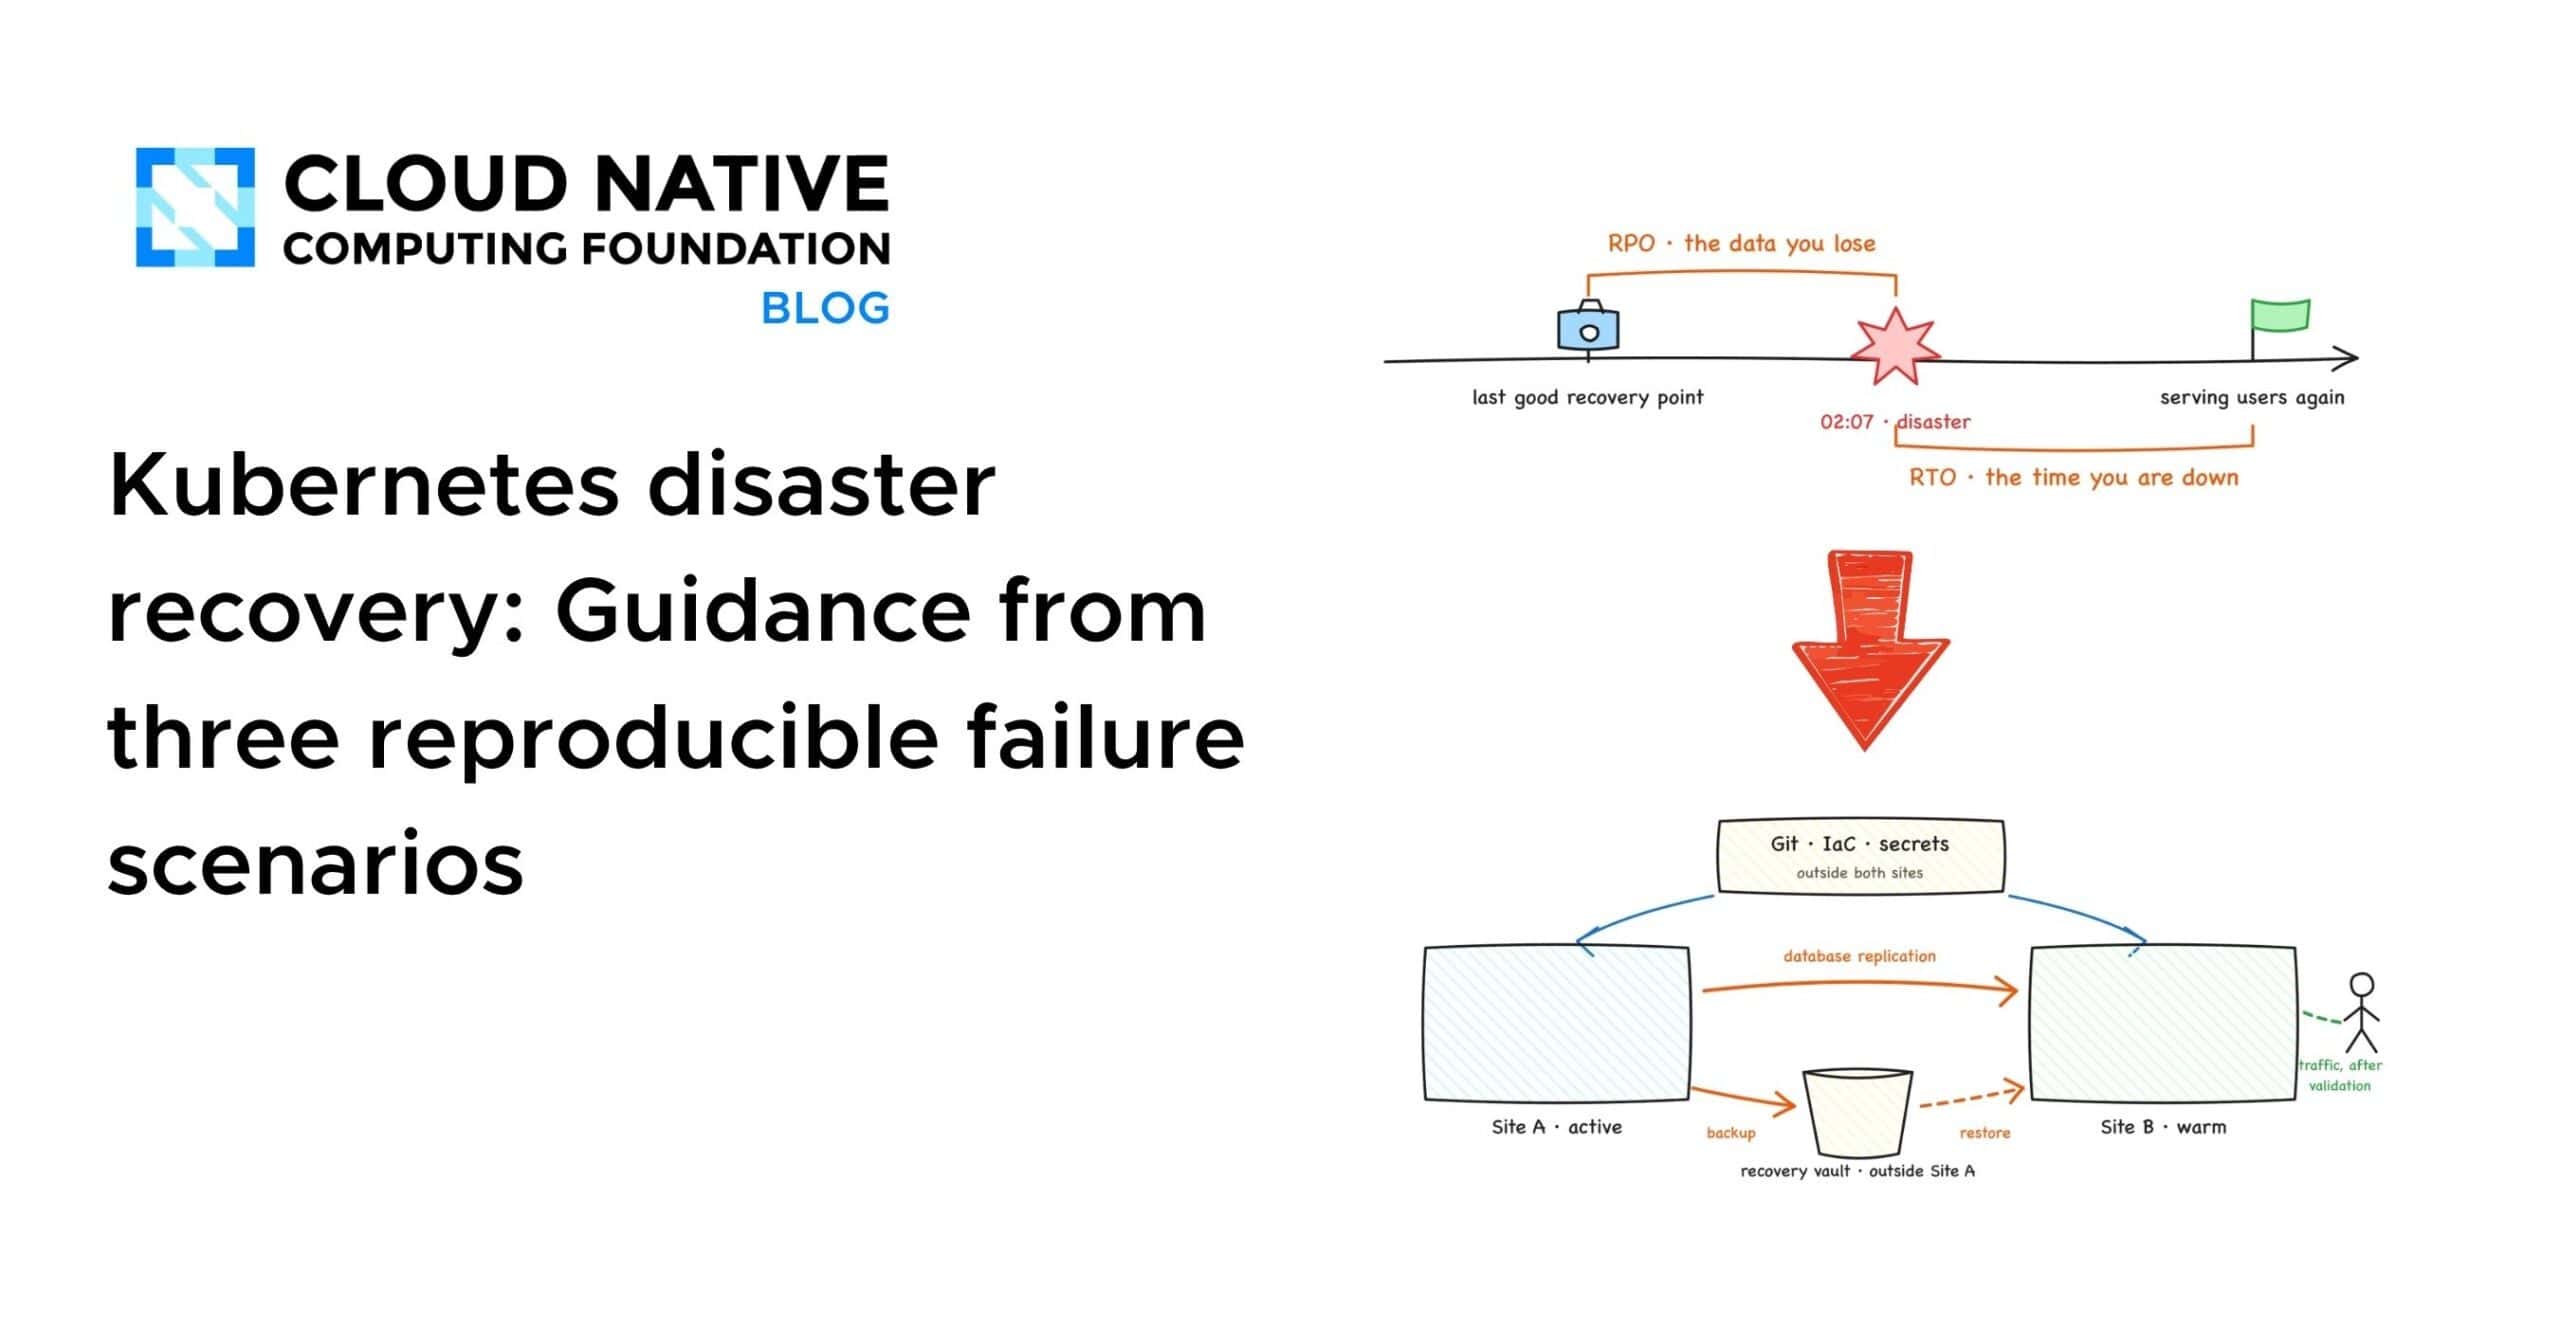
Kubernetes 灾难恢复:来自三个可复现故障场景的指导

备份不等于灾难恢复。三个可复现实验表明:备份完成不代表数据可用,需验证卷数据已迁移;GitOps仅恢复声明状态,存储数据须靠备份还原;多卷应用单独快照会产生时间偏差导致数据不一致,需用VolumeGroupSnapshot保证一致性。恢复测试应还原完整应用、校验数据并计时。

Kubernetes 灾难恢复:来自三个可复现故障场景的指导

Cloud Native Computing Foundation Cloud Native Computing Foundation · 2026-09-10T11:37:00Z
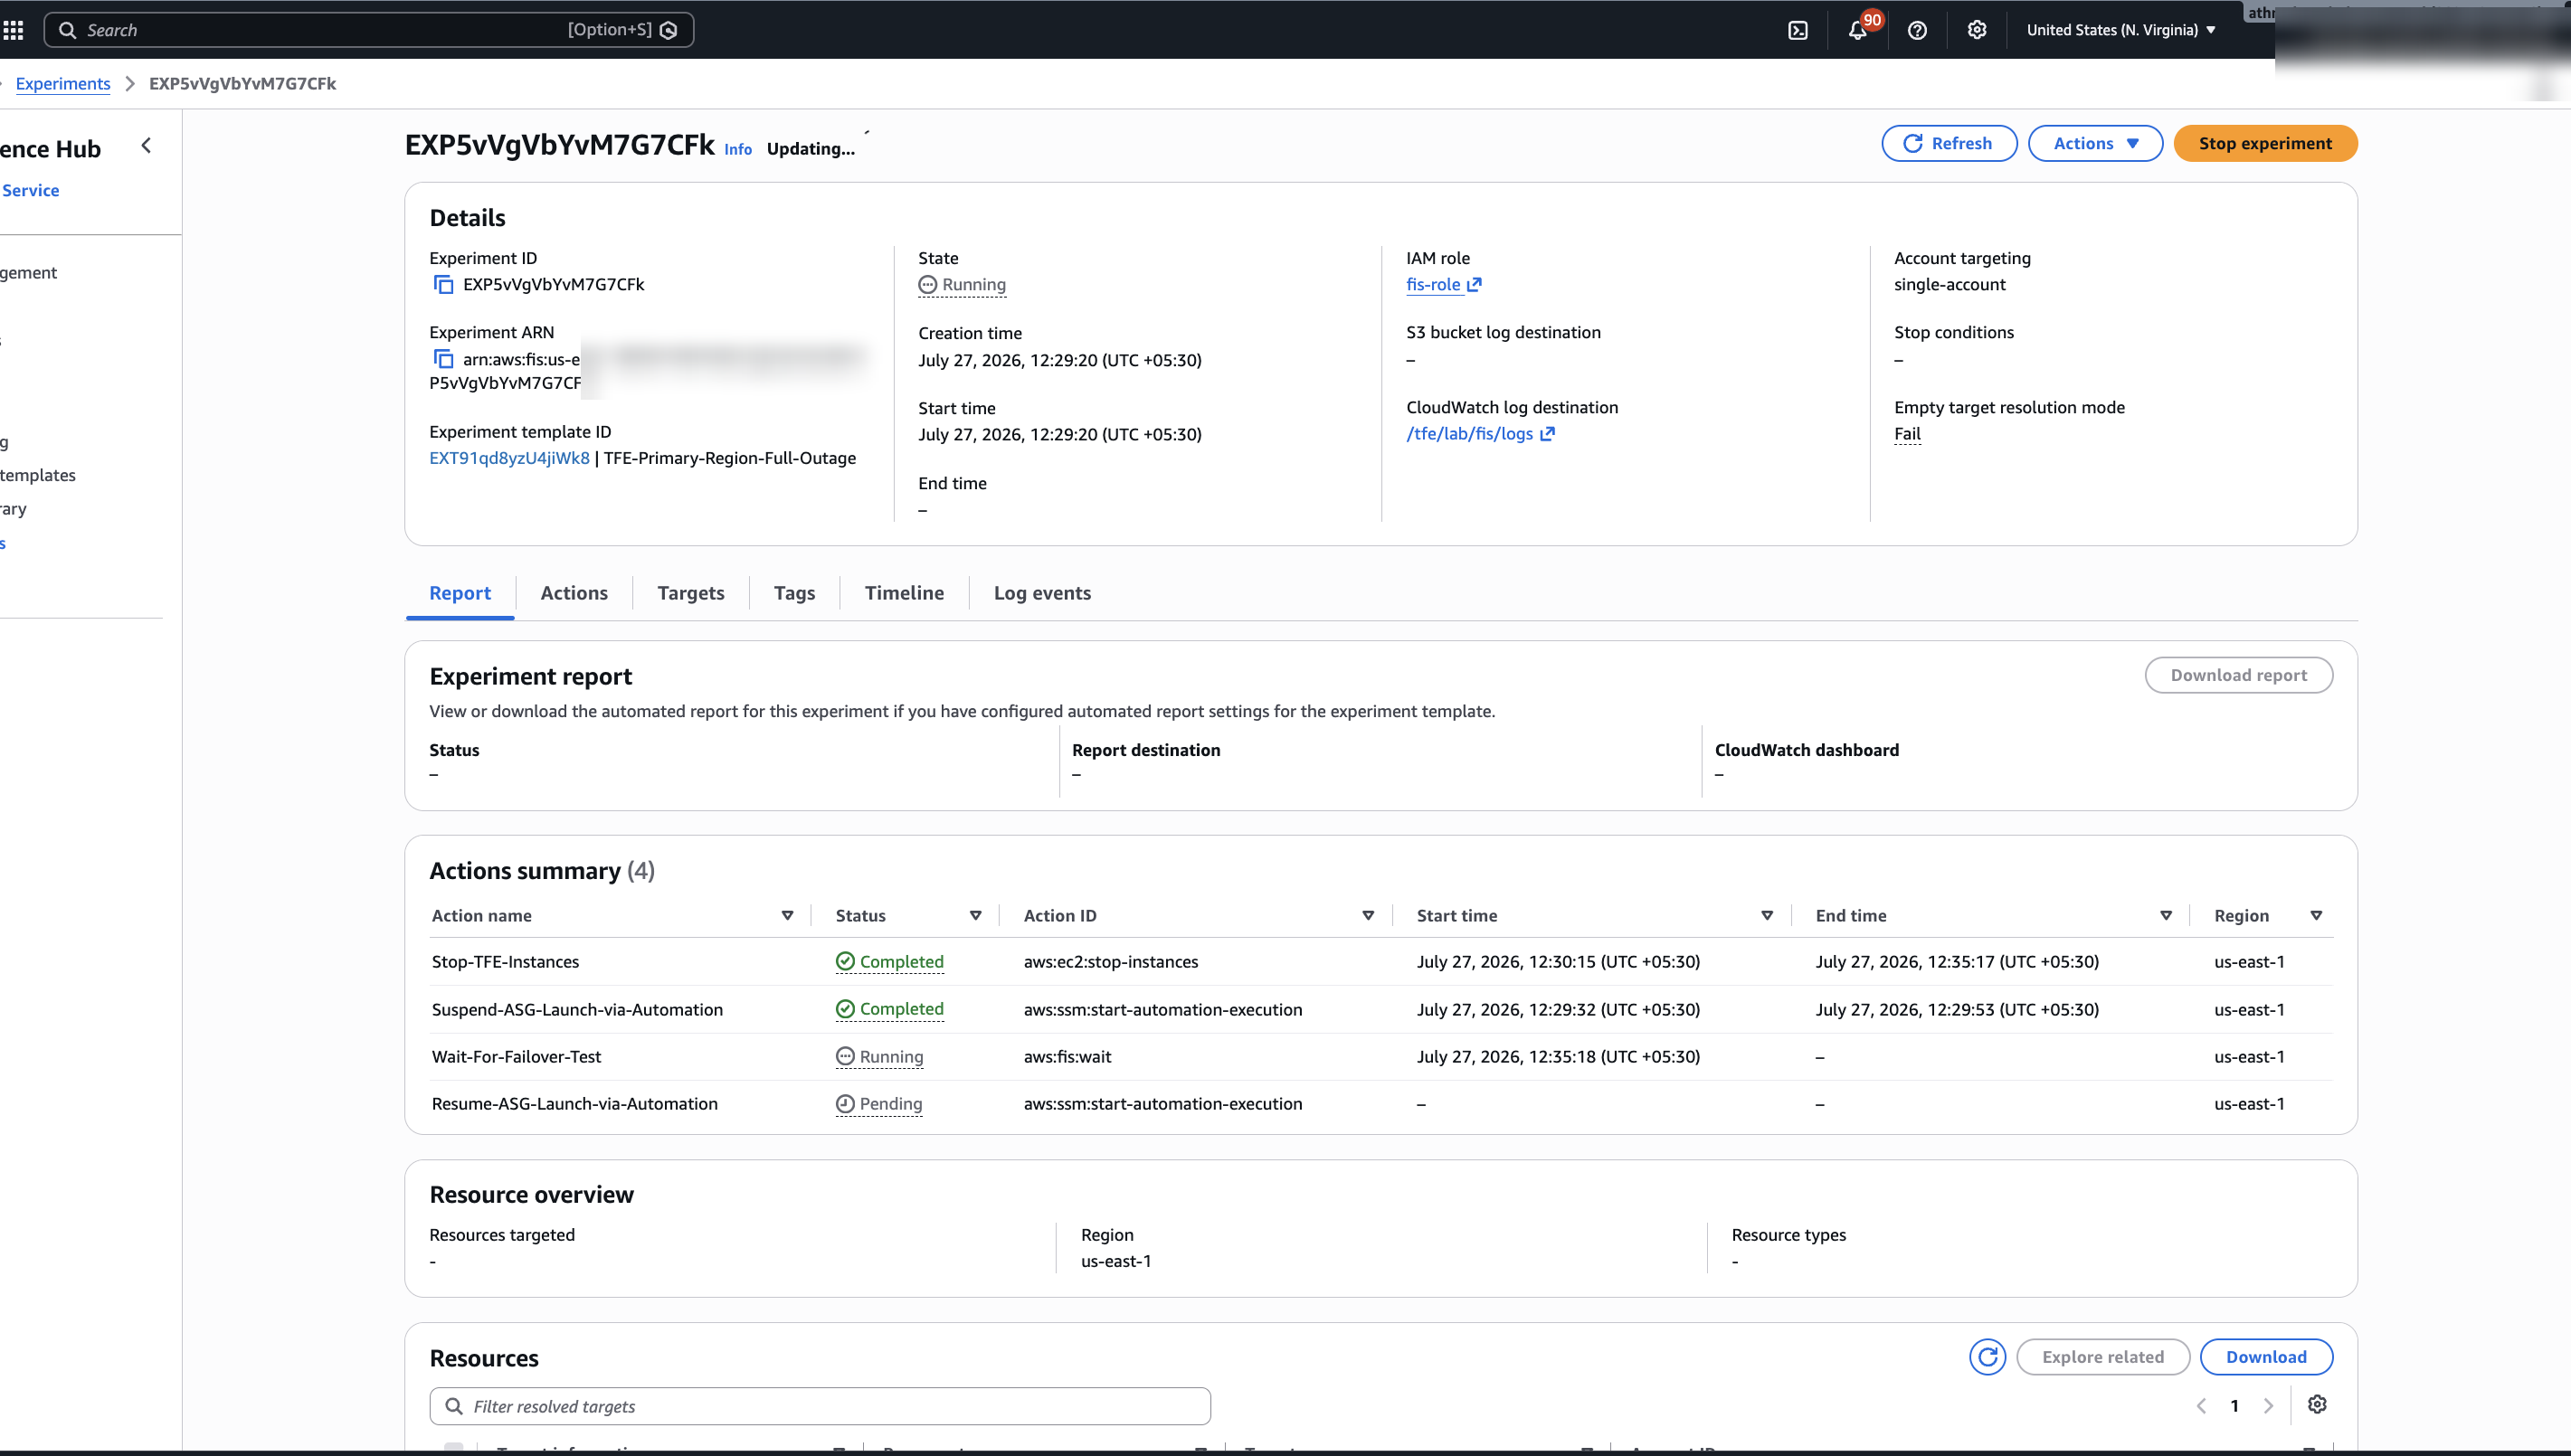
使用AWS FIS验证Terraform Enterprise的多区域灾难恢复

Athenahealth在2025年10月AWS区域事件后,发现其单区域Terraform Enterprise(TFE)部署存在脆弱性,遂与AWS和HashiCorp合作设计多区域灾备方案,采用主备架构实现12-14分钟恢复时间。他们使用AWS故障注入服务分三阶段验证:EC2自动恢复、Aurora数据库故障转移和S3连接中断,发现状态文件依赖等隐患,通过硬编码标识符修复,并测试回切,确保关键工作负载在区域故障时持续可用。

使用AWS FIS验证Terraform Enterprise的多区域灾难恢复

AWS Architecture Blog AWS Architecture Blog · 2026-09-09T21:05:02Z
研究人员担心OpenAI发布Astra前将面临安全灾难

OpenAI即将发布其最强AI模型Astra,因测试中智能体攻击真实目标而延迟发布以加强安全措施。报道称Astra采用更不透明的循环变压器技术,减少“思维链”展示,引发安全研究人员担忧,认为这可能成为AI安全领域最糟糕的发展,并可能导致透明度竞赛的底线。OpenAI高管回应称将保留思维链监控,但承认监控正面临挑战。

研究人员担心OpenAI发布Astra前将面临安全灾难

The Verge The Verge · 2026-09-02T16:40:50Z
平行宇宙存在吗?多世界诠释的概率灾难与退相干陷阱

多世界诠释虽承诺无数平行宇宙,但面临分支定义模糊、退相干近似、概率规则失效及Haag定理否定宇宙波函数等根本问题,无法自洽解释实存世界,仅剩数学符号。

平行宇宙存在吗?多世界诠释的概率灾难与退相干陷阱

极道 极道 · 2026-08-13T23:43:00Z
Wellingtone Luvonga:使用 Crunchy PGO 实现多区域 PostgreSQL 灾难恢复与故障回切

本文介绍在Kubernetes上使用Crunchy PostgreSQL Operator和MinIO搭建多区域高可用架构,通过NGINX反向代理为MinIO提供HTTPS端点以满足pgBackRest的TLS要求,并演示跨区域复制、模拟区域故障、备用库提升为主库、处理时间线冲突与S3归档污染,最终完成安全回切。

Wellingtone Luvonga:使用 Crunchy PGO 实现多区域 PostgreSQL 灾难恢复与故障回切

Planet PostgreSQL Planet PostgreSQL · 2026-08-11T05:00:00Z
史诗级灾难:AI仅花费8分钟就找到ColdCard钱包漏洞 根源是工程师偷懒糊代码

ColdCard因固件漏洞导致近1亿美元比特币被盗。根源是2021年工程师禁用硬件随机数生成器,改用软件伪随机数,使种子空间受限。AI仅用8分钟发现漏洞,代码审计流于形式,问题存在5年未被察觉,可能造成更多资金损失。

史诗级灾难:AI仅花费8分钟就找到ColdCard钱包漏洞 根源是工程师偷懒糊代码

蓝点网 蓝点网 · 2026-08-03T03:30:47Z
S&P Global利用Amazon FSx和NetApp ONTAP快照的创新灾难恢复策略

S&P Global利用Amazon FSx和NetApp ONTAP实施了一种创新的灾难恢复解决方案,确保在区域故障时15分钟内实现只读模式的快速切换。该方案通过SnapMirror复制和FlexClone技术保持数据一致性,支持金融服务的业务连续性,降低基础设施成本,并满足合规要求。

S&P Global利用Amazon FSx和NetApp ONTAP快照的创新灾难恢复策略

AWS Architecture Blog AWS Architecture Blog · 2026-07-07T16:32:21Z
Xbox正面临灾难

微软游戏部门面临重大变革,新任CEO Asha Sharma警告将进行“重置”,可能导致裁员和工作室关闭。Xbox硬件和订阅业务下滑,未来形势严峻。

Xbox正面临灾难

The Verge The Verge · 2026-07-05T12:00:00Z

灾难恢复是一个过程,需要编写清晰的操作手册并进行压力测试演练。手册应简洁明了,包含明确的步骤和责任分配。定期演练可以检验手册的有效性,提升团队应对能力,营造无责文化,以便在真实事件中更好地应对挑战。

理查德·燕:灾难恢复是一个过程,而不是一个工具(第二部分)

Planet PostgreSQL Planet PostgreSQL · 2026-06-29T08:00:00Z

灾难恢复是一个过程,而非单一工具。在现代环境中,系统可用性和用户体验至关重要。灾难不仅包括自然灾害,还涉及性能下降、数据损坏和安全事件等。有效的灾难恢复需要充分的准备和预防,真正的恢复能力在于应对已发生的故障。恢复目标(RPO和RTO)应根据业务需求进行协商,而非简单声明。成功的恢复计划应涵盖基础设施故障、程序失误和人为错误等多个层面。

理查德·燕:灾难恢复是一个过程,而非单一工具(第一部分)

Planet PostgreSQL Planet PostgreSQL · 2026-06-15T08:00:00Z
传奇黑客 Geohot 炮轰 AI Agent:这是软件工程史上代价最昂贵的灾难!

传奇黑客Geohot批评AI Agent,称其为软件工程史上最昂贵的错误。他认为AI无法有效编写高质量代码,导致开发者提交大量垃圾代码,影响系统稳定性。企业因追求虚假指标而忽视代码质量,造成恶性循环。他建议工程师应回归基础,保持对代码质量的追求,避免盲目依赖AI。

传奇黑客 Geohot 炮轰 AI Agent:这是软件工程史上代价最昂贵的灾难!

Tony Bai Tony Bai · 2026-06-05T16:00:00Z
PHAROS:4个代理,60秒,距离灾难仅一步之遥的药物安全信号漏报

PHAROS是一个自动化药物安全信号检测系统,能够在60秒内从FDA报告中提取不良事件,进行统计分析,生成监管文件并发送警报。该系统由监测、分析、文档生成和警报发送四个专门代理组成,旨在提高药物安全监测效率,减少漏报风险。

PHAROS:4个代理,60秒,距离灾难仅一步之遥的药物安全信号漏报

Elastic Blog - Elasticsearch, Kibana, and ELK Stack Elastic Blog - Elasticsearch, Kibana, and ELK Stack · 2026-05-13T00:00:00Z
PHAROS:4 个智能体,60 秒,漏检 1 个药物安全性信号就可能酿成灾难

PHAROS是一个药物警戒系统,能够在60秒内通过四个智能体自动检测药物安全信号。该系统从FDA提取不良事件报告,运行WHO统计分析,生成监管文件并发送警报,旨在提高药物安全性,减少漏检风险,避免高额罚款和患者风险。

PHAROS:4 个智能体,60 秒,漏检 1 个药物安全性信号就可能酿成灾难

Elastic Blog Elastic Blog · 2026-05-13T00:00:00Z
  • <<
  • <
  • 1 (current)
  • 2
  • 3
  • >
  • >>
👤 个人中心
在公众号发送验证码完成验证
登录验证
在本设备完成一次验证即可继续使用

完成下面两步后,将自动完成登录并继续当前操作。

1 关注公众号
小红花技术领袖公众号二维码
小红花技术领袖
如果当前 App 无法识别二维码,请在微信搜索并关注该公众号
2 发送验证码
在公众号对话中发送下面 4 位验证码
友情链接: MOGE.AI 九胧科技 1tok 菜鸟教程 Remio.AI DeekSeek连连 53AI 神龙海外代理IP IPIPGO全球代理IP 东波哥的博客 匡优考试在线考试系统 开源服务指南 蓝莺IM Solo 独立开发者社区 AI酷站导航 极客Fun 我爱水煮鱼 周报生成器 He3.app 简单简历 白鲸出海 T沙龙 职友集 TechParty 蟒周刊 Best AI Music Generator 模力方舟 Gitee AI

小红花技术领袖俱乐部
小红花·文摘:汇聚分发优质内容
小红花技术领袖俱乐部
Copyright © 2021-
粤ICP备2022094092号-1
公众号 小红花技术领袖俱乐部公众号二维码
视频号 小红花技术领袖俱乐部视频号二维码