知识库正在把企业的知识管理变成一场昂贵的文件搬家! 企业从几个人扩张到几十人,沟通开始变慢,经验开始丢失,管理者便会想到知识库、企业维基和人工智能(AI),但文件越来越齐全,员工却未必越来越懂业务,真正决定企业能否传承经验的,往往是评
WorkSwarm推出个人知识空间,可自动采集本地文件夹、知乎、飞书、GitHub等来源资料,整理为有目录、有出处的知识库,供智能体渐进式读取,实现一次采集、反复使用,减少重复查找和token消耗,提升任务准确率。测试显示,启用后任务耗时与token消耗均明显下降。
本文介绍在 Amazon Quick 桌面端落地 Karpathy 的 LLM Wiki 范式:先编译后查询,让知识沉淀。方案分三层——原始资料、LLM 拥有的 wiki、人机共写的 schema,并实现 Ingest、Query、Lint 三个操作。借助 Quick 内置索引、知识图谱与 wiki-inspect MCP,无需自建向量库,即可自动检索、抽取实体并定时体检。
NocoBase 更新支持 AI 员工引用知识库文档,并明确 main、next、develop 分支定位。无代码平台进入团队系统后,难点在权限、版本、数据、回滚与维护。AI 回答需能定位引用来源才可信,应关注索引刷新、权限变更和日志留痕。生产用 main,测试用 next,慎用 develop。建议先从非核心流程试用,固定版本、开启日志备份,再逐步扩大范围。
该文本仅为付费阅读和登录提示,无实质文章内容,无法总结。
该文本仅为付费阅读提示和登录支付界面,无实质文章内容,无法总结。
京东海博团队构建AI Native三层知识库,解决AI理解复杂系统、影响面分析依赖人工、测试预期难查询等问题。知识库包括底层项目×领域知识矩阵、中层角色化知识、上层Skill能力,并采用OKF规范将知识编译前移。通过Harness引擎实现知识消费与沉淀闭环。AB实验表明,带知识库方案提速约44%,覆盖更全面,测试用例采纳率达90%~100%。
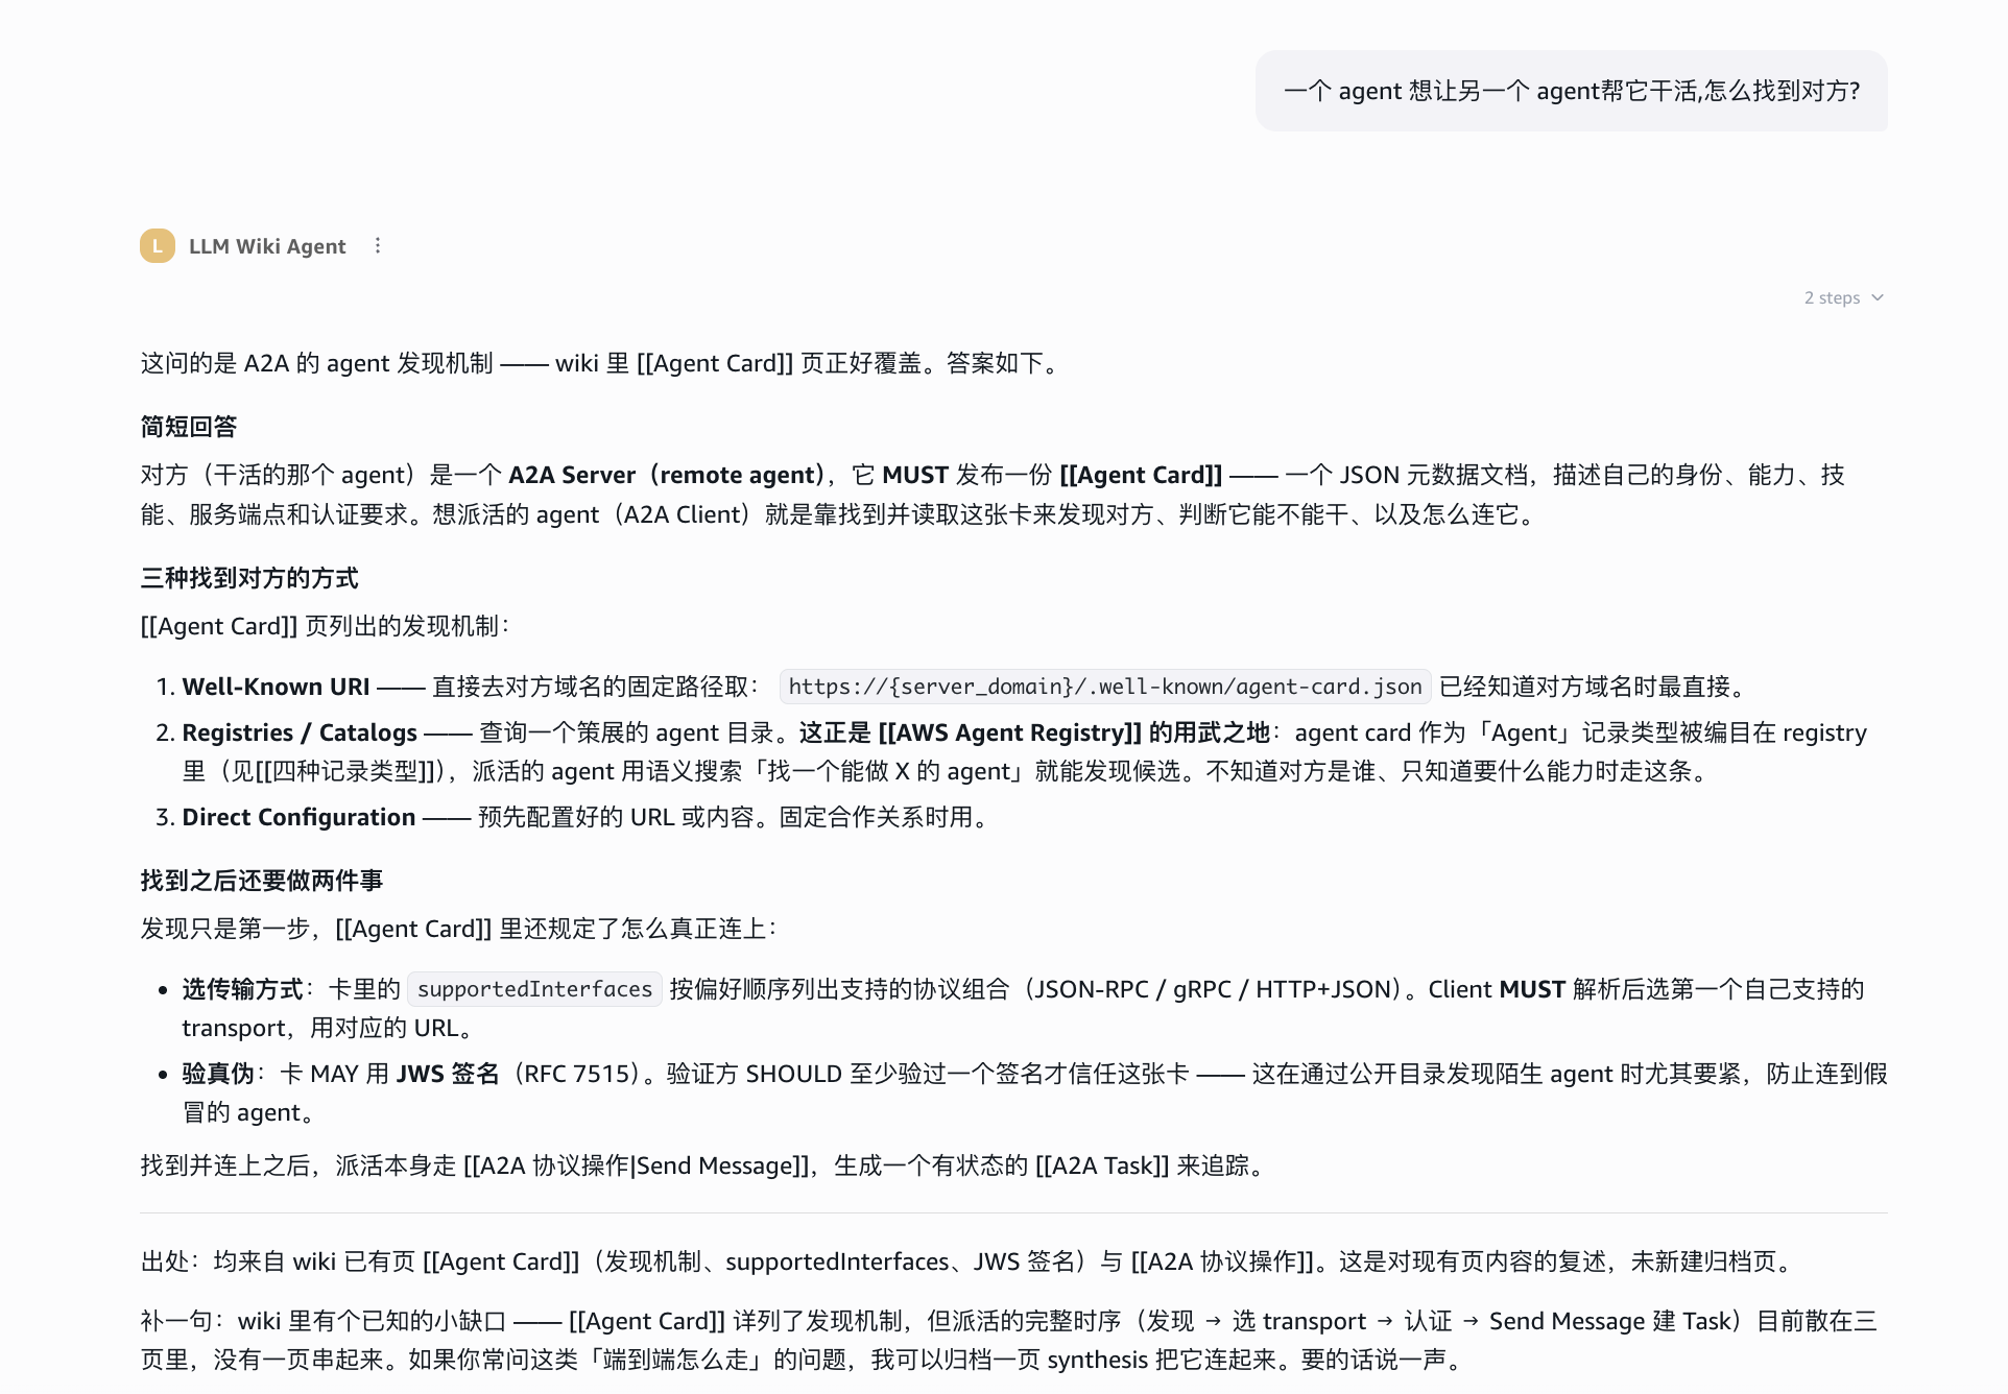
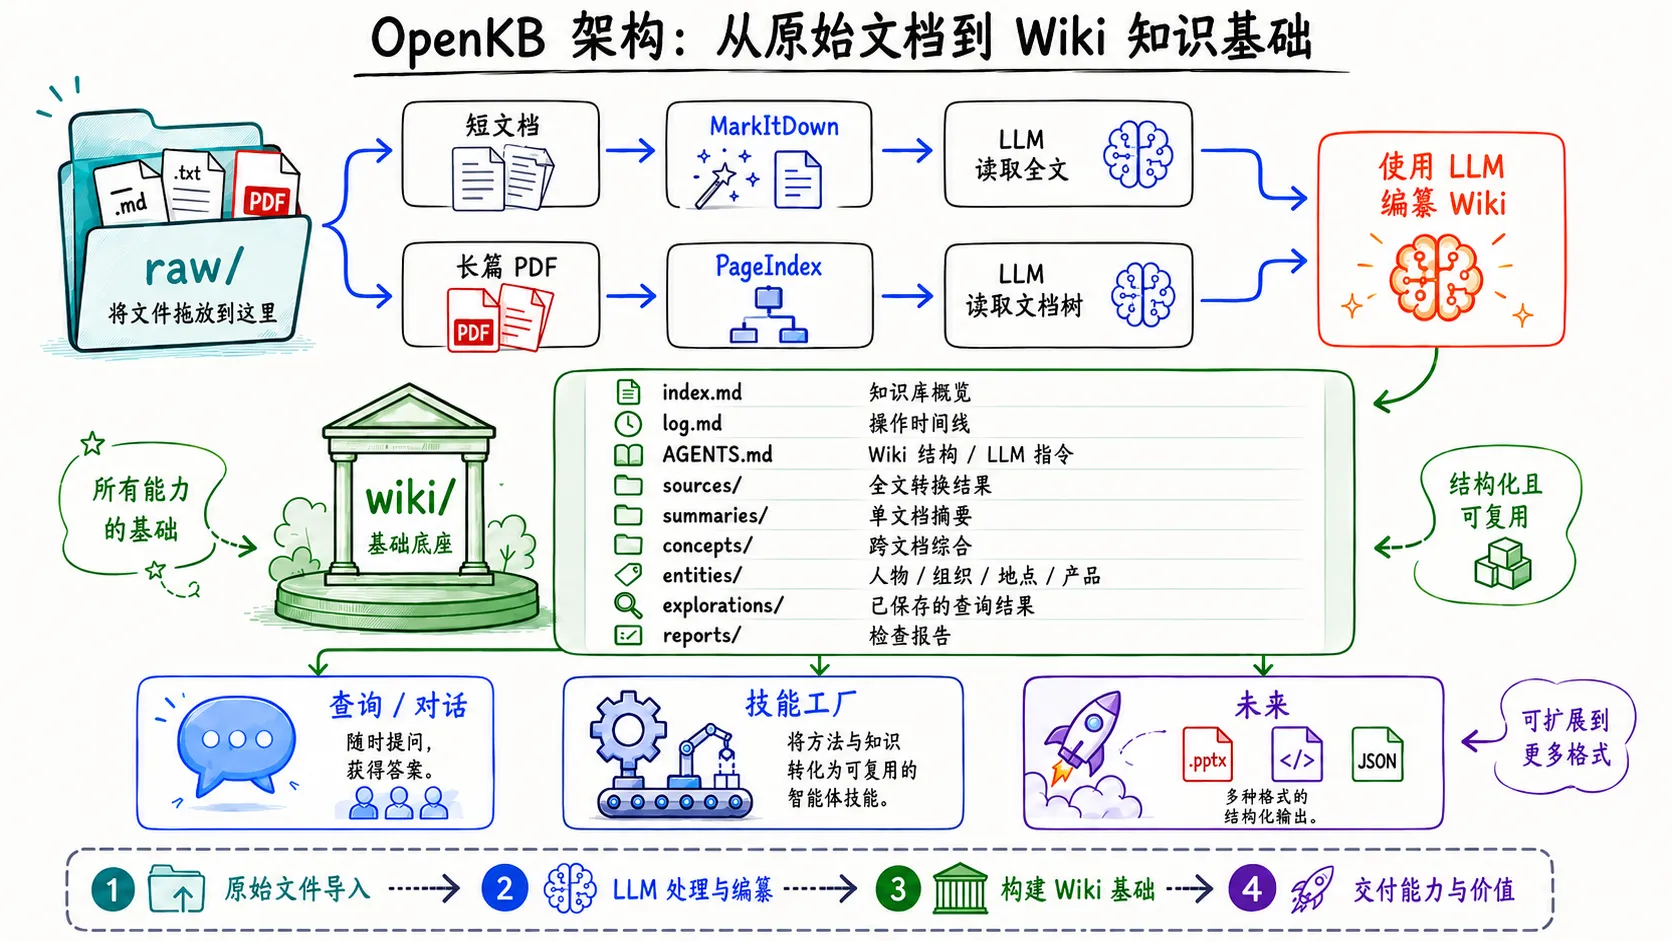
LLM-WIKI 是 Karpathy 提出的理念:让大模型将阅读、理解、问答持续沉淀为持久、互链、带引用的 Markdown 知识库,实现知识复利。OpenKB 是其开源实现。结合 scys-mcp 采集生财有术精华帖等数据,用 AI Agent 驱动 OpenKB 编译入库,可构建知识图谱与问答系统,并定期 lint 维护。
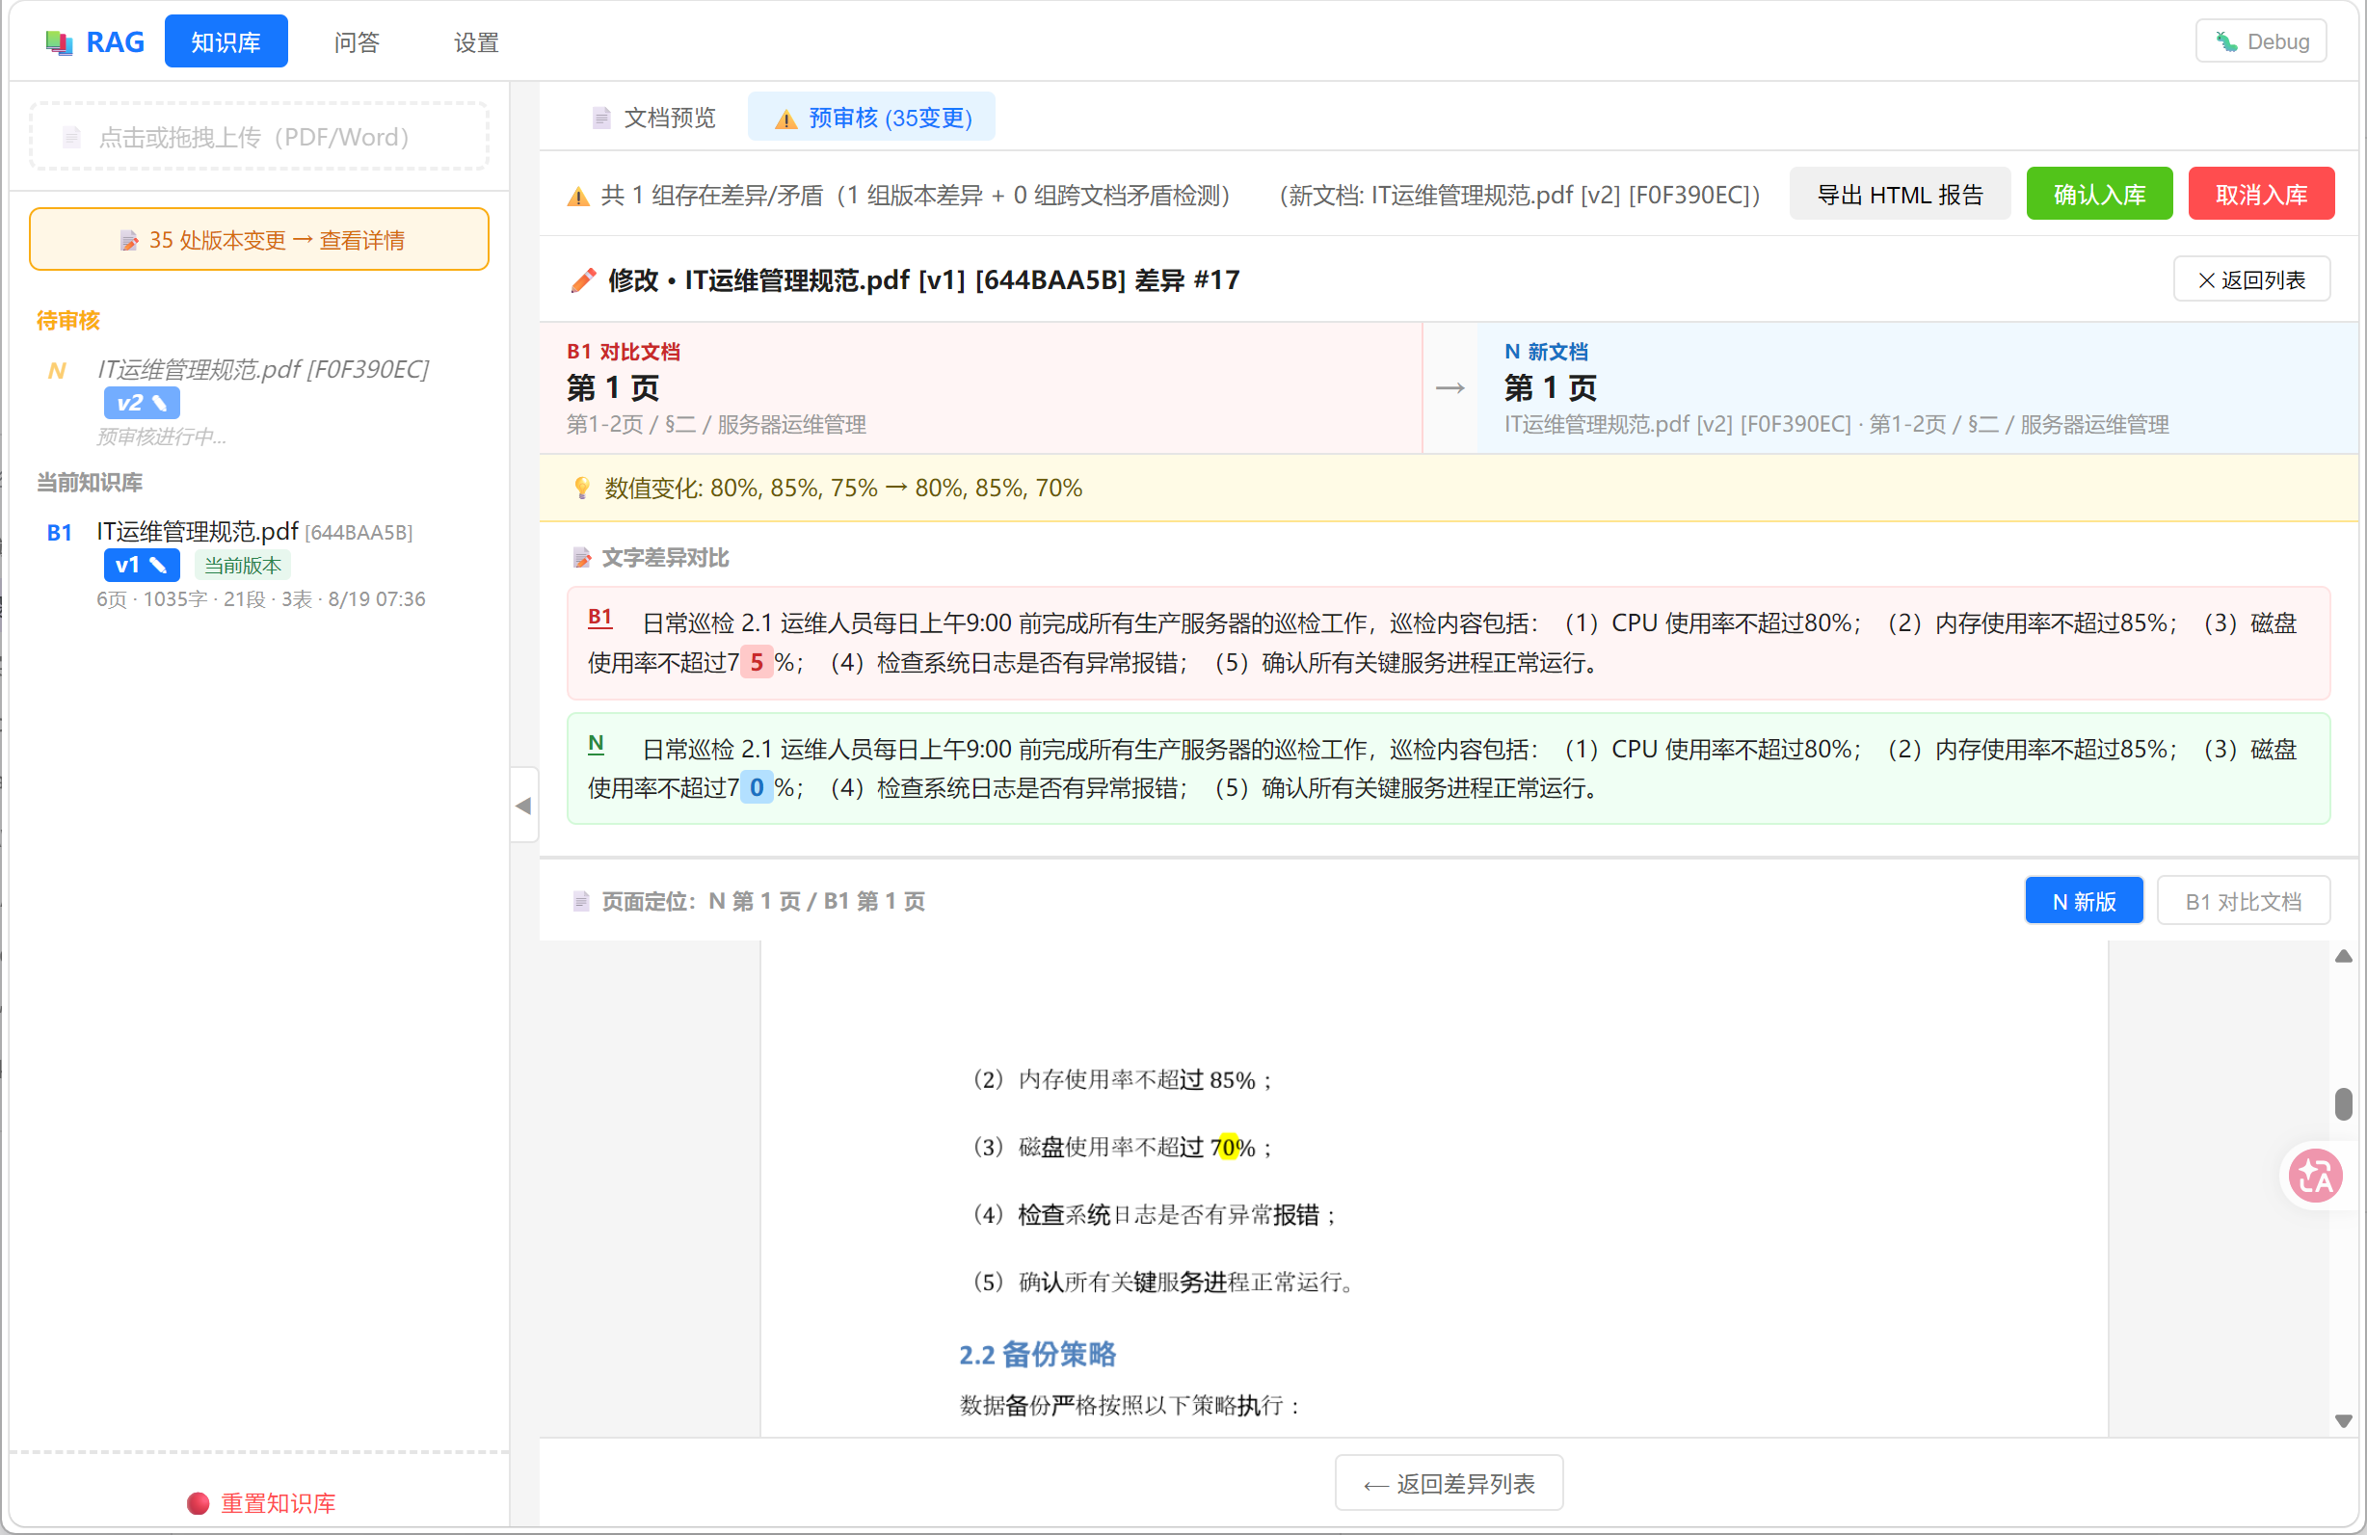
为民航企业构建带入库质量门禁的RAG知识库系统,针对规章手册多版本混淆、跨文档矛盾等问题,在入库环节设置质量门禁:按向量相似度分流,高相似度进行版本对比,低相似度进行跨文档一致性检测,生成预审核报告供人工确认;问答环节加入实时冲突标注。系统模块化,支持整体部署或单模块接入。
2026年4至6月,Salesforce、SAP、通用汽车公开三项RAG质量评测专利,分别涉及合成不可回答题集、企业评测框架和回答置信分数,表明RAG验收标准正从检索命中率转向回答可信度。这为个人开发者带来机会:开发RAG拒答质检工具,合成六类不可答题并回放客户API,按“该拒不拒、该答不答”打分,生成质检报告。一人四周可完成MVP,并可延伸出交付前质检与回归巡检订阅服务。
Meta构建了一个AI代理系统,作为组织的“第二大脑”,通过结构化知识库与推理层分离知识,并利用自我改进循环将专家反馈编译为验证更新,无需重训模型。该系统在合规领域显著节省专家时间,减少评估耗时,实现零回归,并适用于金融、安全等专业领域。
本文介绍从零实现GeekAgent第14天,构建轻量RAG知识库。通过`rag_add`采集网页或文件,按800字切块存入JSON;`rag_search`用BM25检索相关段落,最多返回四块。复用Day13的切块与搜索函数,实现“先查资料再回答”,支持`/rag`命令管理,适合少量文档场景。
Kiso是开源静态网站发布引擎,由法国投资公司Oak Invest开发,将OKF格式知识库转为人类和AI代理可读的网站。它遵循结构化Markdown、显式元数据和AI友好输出原则,提供check和build命令,支持GitHub Action和MCP Server,确保同一知识源可同时供人浏览和AI消费,无需转换或同步。
Stigmergy是一个团队知识管理系统,基于Karpathy的“单人wiki”理念,利用AI图书管理员自动归档团队捕获的内容(如Slack反应、Agent输出)为Wiki页面。系统通过不可变证据链、矛盾标记和可见性策略确保可信度,支持多人多AI并发写入,无需审批。部署简单,测试覆盖1100多个,但存在扩展性和生产环境适应性的未解问题。
作者从Notion转向Obsidian,核心是让AI(Claude Code)持续维护知识库,而非仅存储。通过CLAUDE.md设定规则,用收录、查问、体检三流程,结合graphify和wiki-relate工具,实现笔记自动更新、矛盾检测和关联发现。强调避免过度收录、逐步构建结构,并设定AI操作边界,以养成长期维护习惯,让知识库成为可复利的基础设施。
AI知识库并非人人适用,其价值取决于信息结构而非岗位或勤奋。核心判断标准是:工作中是否存在大量分散、需长期复用且遗漏代价高的信息。高信息汇聚者、高上下文决策者、长期学习者及高复用内容生产者受益最大;而信息量少、短期有效或已有权威源者则无需搭建。搭建前需权衡收益与录入、维护、校验等隐性成本,确保长期收益大于成本。
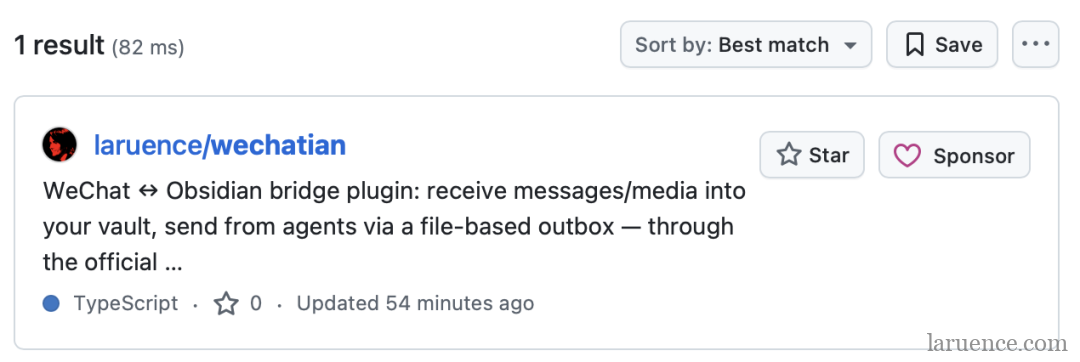
本文介绍Obsidian插件Wechatian,它通过腾讯官方网关将微信变为AI Agent与知识库的双向通道,无需第三方中转。支持接收微信消息、文章剪藏,并让Agent通过文件发件箱主动发送通知。扫码绑定确保安全,适合长任务提醒和远程指挥,安装简便。
Cerebras知识库通过混合检索系统解决企业知识管理难题,结合向量搜索、全文匹配、时间衰减和RRF融合,直接索引Slack、代码仓库等原始数据,无需员工改变习惯。按项目范围过滤噪音,支持增量更新和MCP轻量工具,日均处理15000次提问,强调精准而非全面,实用至上。
本文介绍如何将Obsidian笔记库部署到NAS(铁威马F4-425 Pro)上,通过Ignis项目让Obsidian在浏览器中运行,并接入AI(OpenClaw)实现知识库的自动整理和查询。用户可通过微信或飞书等平台远程操作,但需注意Ignis无内置登录功能,不建议直接暴露公网。
海博研发RoadMap提出AI原生研发框架,解决传统对话式AI编程的随机性、难复用和管控难问题。通过双层架构、文件驱动机制、技能/Agent/规则三位一体体系,实现流程标准化、知识沉淀和自动化执行。案例显示效率提升1680倍,成本降低99.25%,推动AI从辅助工具升级为标准化工程交付。
完成下面两步后,将自动完成登录并继续当前操作。