
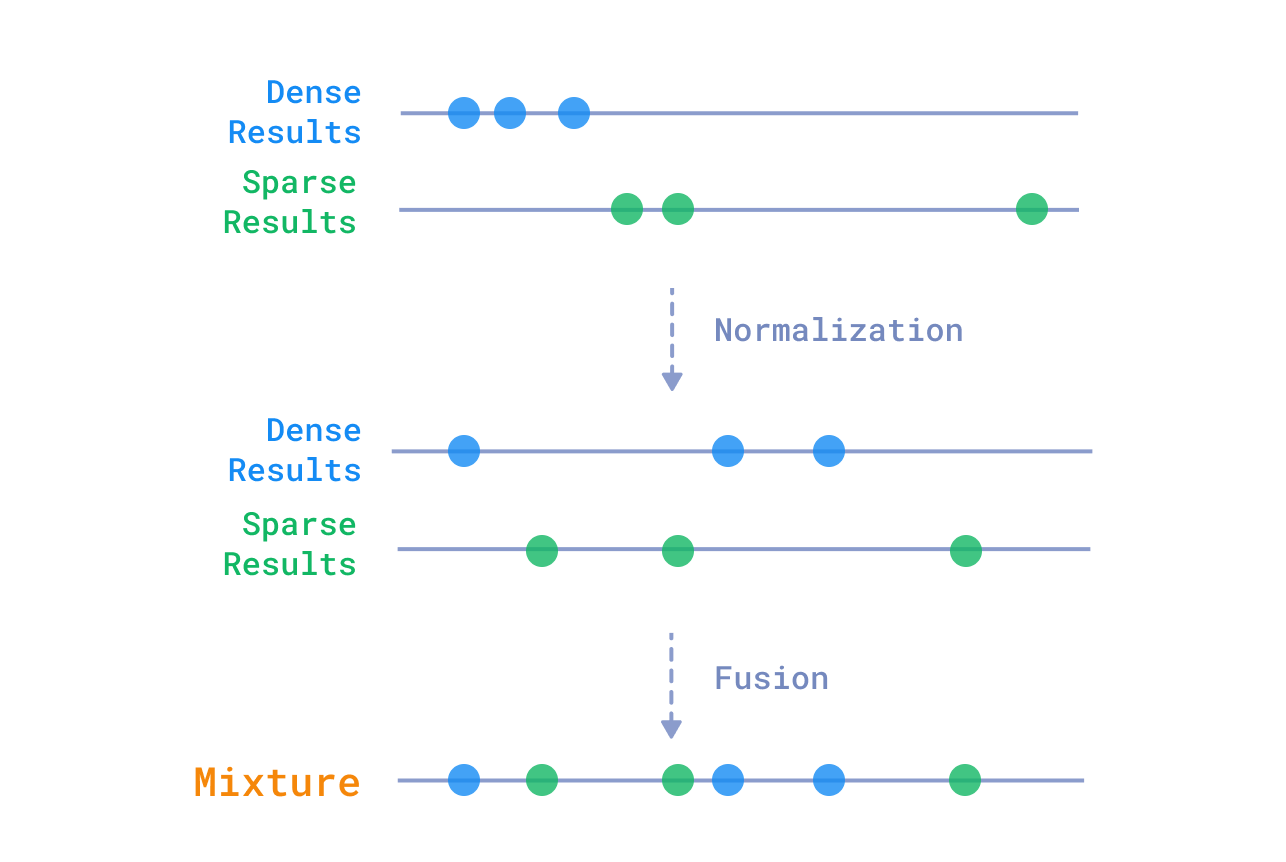
混合检索结合稀疏向量和密集向量,以提高检索准确性。稀疏向量基于词频,具有良好的可解释性,但缺乏语义理解;密集向量通过深度学习理解同义词,具备更强的泛化能力。查询构建利用大语言模型将自然语言转为结构化查询,支持多种数据类型。检索技术的进阶包括重排序、压缩和校正,以提升检索精度和答案质量。
本研究通过引入统一的神经符号系统和稀疏向量表示,解决了神经网络在组合推广中的不足,显著提升了模型效率和应用范围,同时保留了推广能力,避免了其他技术的缺陷。
在AWS re:Invent大会上,Pinecone推出了AI检索平台的重要升级,包括新的重排序模型和稀疏向量索引。该平台的级联搜索方法结合稀疏与密集向量搜索,提升搜索结果准确性。同时,增强了安全性,提供基于角色的访问控制和客户管理的加密密钥。这些改进使用户通过单一API调用实现高效的文本嵌入和重排序。
Qdrant 1.10版本推出了统一查询API、内置逆文档频率(IDF)支持和多向量搜索等重要功能。统一查询API简化了搜索请求,IDF机制提升了文档检索效率,多向量支持增强了语义理解能力。此外,优化了稀疏向量的存储方式,降低了内存占用。
pgvector 0.7.0版本引入了float16向量、稀疏向量和位向量,显著减少内存占用并提升性能。使用float16向量可将内存需求减半,HNSW索引构建速度提高30%。稀疏向量和位向量进一步节省存储空间,支持新的距离函数。整体性能较去年提升超过100倍。
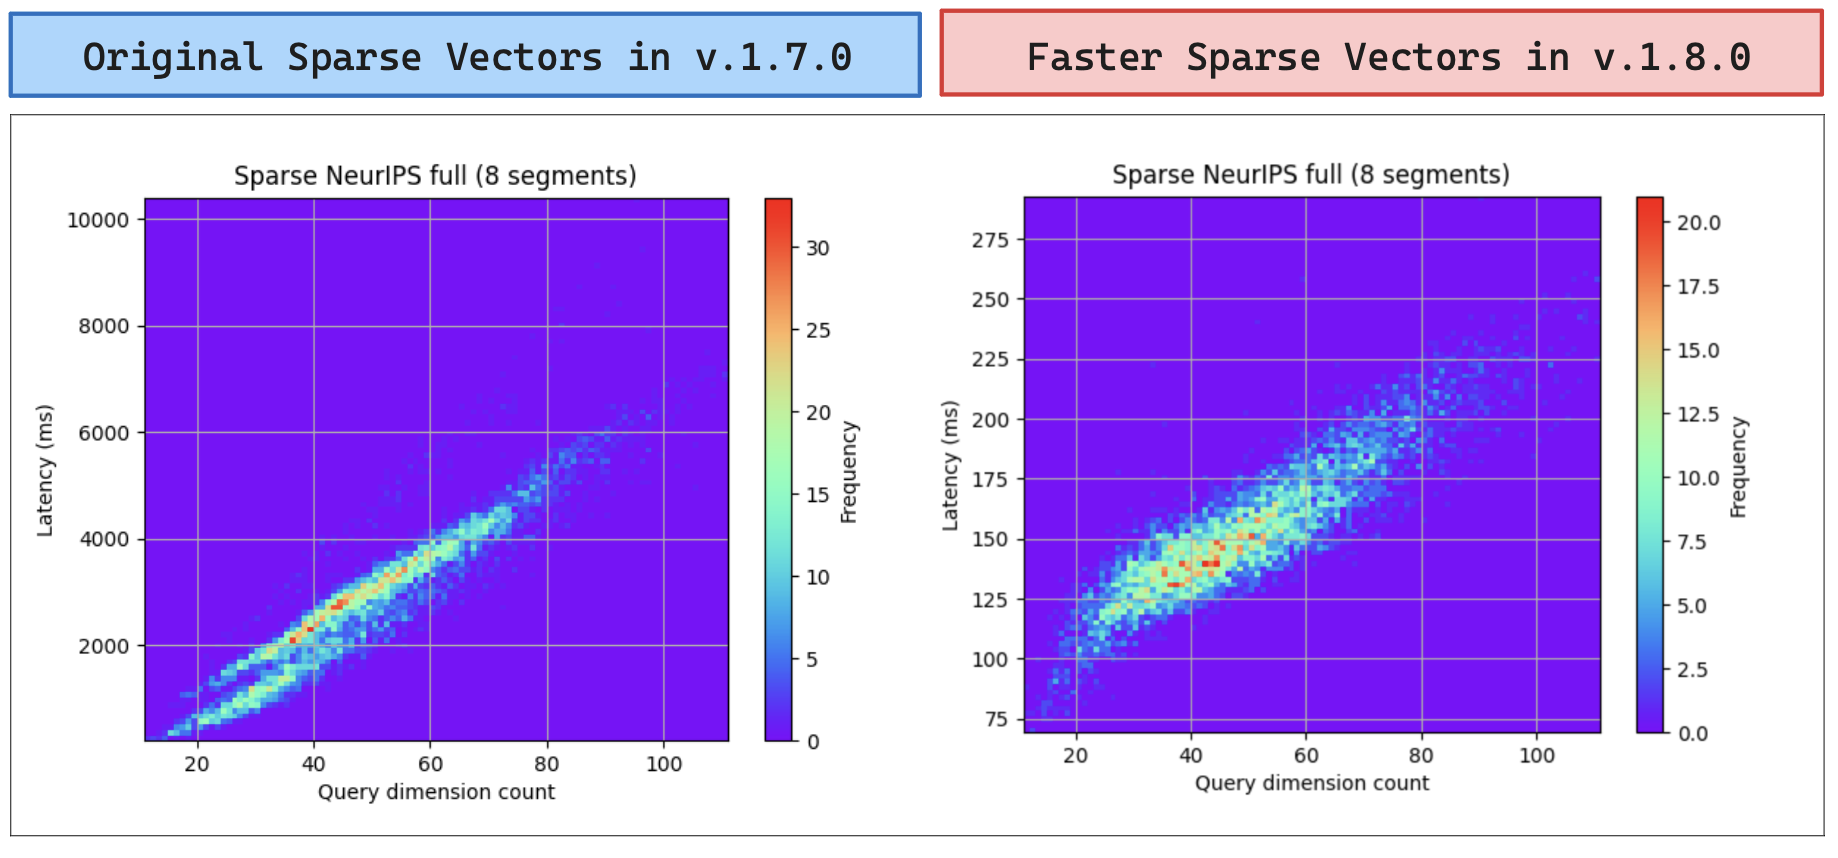
Qdrant 1.8.0版本发布,优化了搜索性能,稀疏向量搜索速度提升至16倍,支持CPU资源管理以加快索引速度。新版本改进了文本数据索引,减少内存使用,并新增按负载排序和日期时间支持等功能,提升用户体验以满足快速增长的查询需求。
Qdrant 1.7.0版本发布,新增稀疏向量支持、Discovery API和用户自定义分片功能。稀疏向量支持基于关键词的搜索,Discovery API提升搜索精度。用户可定义数据存储分片,优化管理。引入快照式分片转移,提升数据迁移效率。同时,性能改进包括搜索延迟降低和地理数据索引增强。
稀疏向量是一种高效的数据表示方式,主要用于信息检索和搜索系统。与密集向量相比,稀疏向量仅保留少量重要特征,从而提高计算效率。SPLADE模型通过扩展查询和文档的相关术语,进一步提升了稀疏向量的性能。结合稀疏和密集向量的混合搜索方法,可以提高检索的准确性和效率。
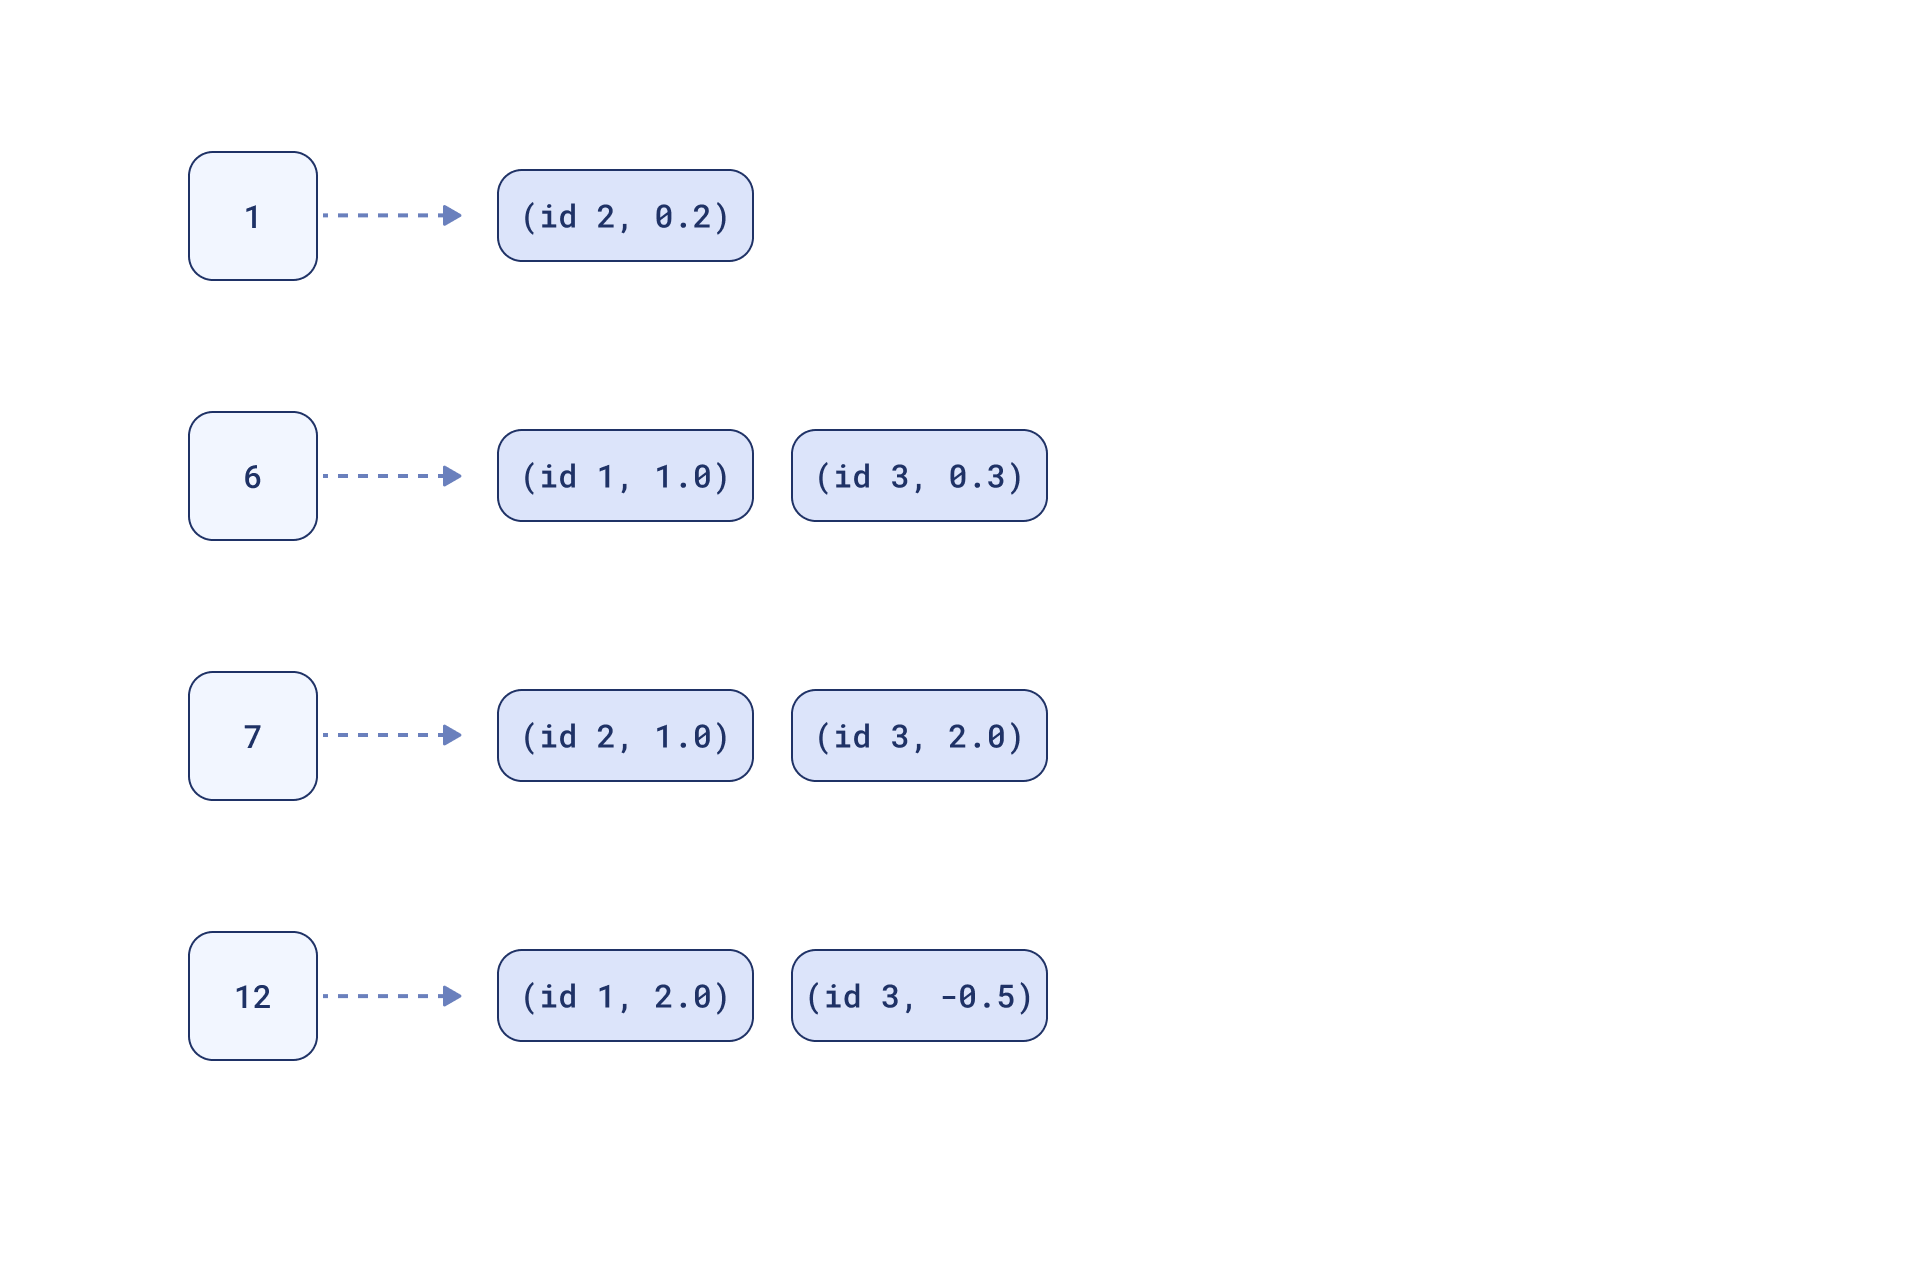
稀疏向量是高维向量,主要用于关键词搜索和推荐系统。它们在少数维度上有值,其他维度为零。通过倒排索引,可以高效存储和检索稀疏向量,快速找到相似向量。Qdrant支持稀疏向量的配置和存储,使用点积计算相似度。
本文介绍了稀疏向量在关键词搜索中的应用,重点讨论了BM25和SPLADE++模型在文本检索中的使用。稀疏向量通过词汇索引表示文本,利用词频和逆文档频率(IDF)计算相似度。BM25模型考虑文档长度对关键词重要性的影响,而SPLADE++通过上下文扩展关键词,提高检索的语义理解能力。Qdrant平台支持这些模型的实现,提供高效的文本检索解决方案。
混合搜索结合了稠密和稀疏向量搜索,以满足不同用户需求。稠密向量适合语义理解,稀疏向量用于精确匹配。通过Qdrant的通用查询API,可以构建复杂的混合搜索管道,利用互惠排名融合(RRF)整合多种搜索结果,提升搜索质量和用户满意度。
本文介绍了混合搜索系统的实现,包括稠密与稀疏向量搜索的比较及其融合算法。内容涵盖环境设置、数据集上传、稠密与稀疏搜索的比较,以及倒数排名融合(RRF)和基于分布的得分融合(DBSF)的应用。混合搜索结合了两种方法的优点,提升了搜索结果质量,并强调了评估的重要性及未来实验方向。
本文介绍了构建混合搜索引擎的项目,结合稠密和稀疏向量,通过互惠排名融合(RRF)实现更优搜索结果。项目包括设置混合集合、实现稠密和稀疏编码、执行混合搜索及比较不同搜索方法的性能。成功标准是能够有效执行混合搜索并展示其优于单一向量方法的案例。
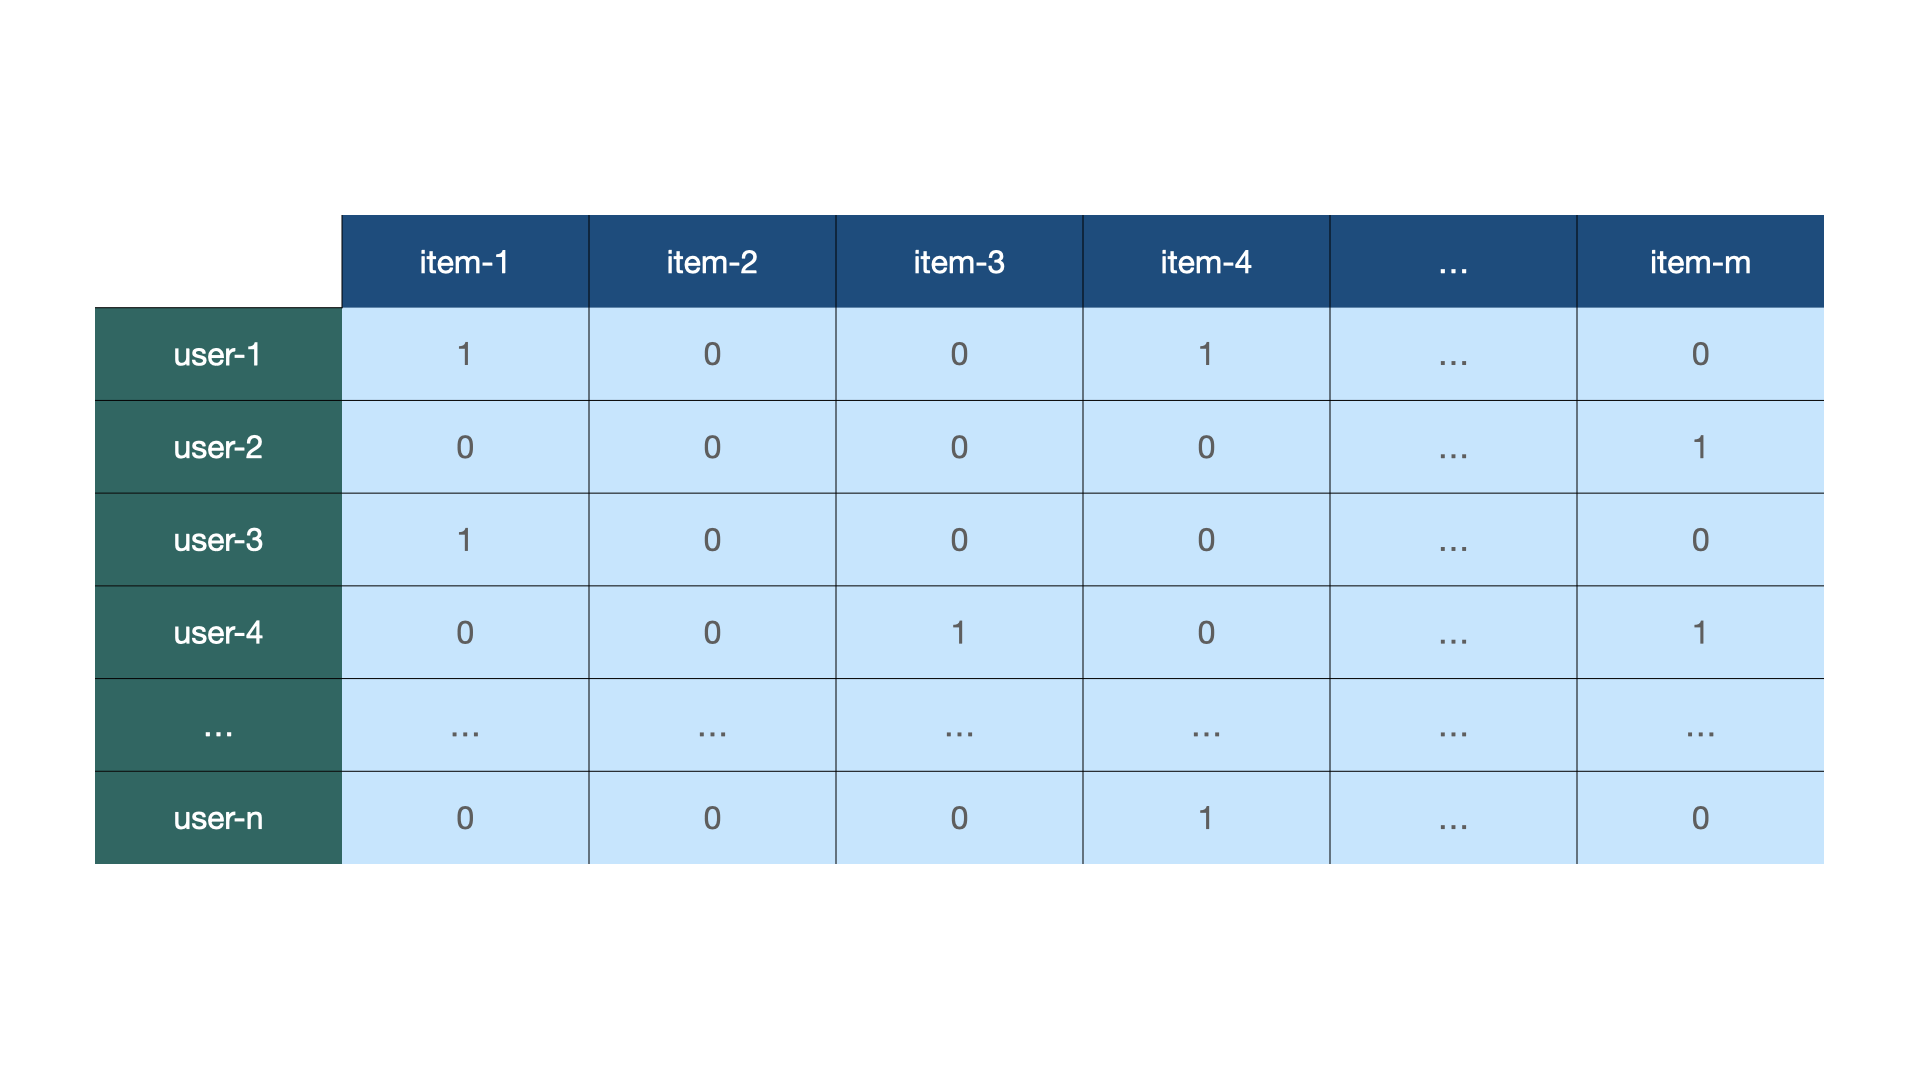
本文介绍了如何使用Qdrant和稀疏向量构建基于协同过滤的电影推荐系统。该方法通过相似性搜索实现推荐,简化了过程并提高了可扩展性。文章详细描述了数据准备、稀疏矩阵转换、用户评分上传及查询推荐的步骤,并展示了推荐结果。此方法可结合用户特征和时间过滤,进一步提升推荐效果。
完成下面两步后,将自动完成登录并继续当前操作。