


什么是稀疏向量?如何实现基于向量的混合搜索
内容提要
稀疏向量是一种高效的数据表示方式,主要用于信息检索和搜索系统。与密集向量相比,稀疏向量仅保留少量重要特征,从而提高计算效率。SPLADE模型通过扩展查询和文档的相关术语,进一步提升了稀疏向量的性能。结合稀疏和密集向量的混合搜索方法,可以提高检索的准确性和效率。
延伸解读
稀疏向量与密集向量的本质差异
稀疏向量仅保留少量非零特征,每个维度对应一个词或子词,权重反映其重要性;而密集向量所有维度均非零,能捕捉语义关系但可解释性差。稀疏向量在文本搜索中计算效率更高,且能精确匹配关键词,但难以捕捉词语间的细微关系,如“国王”与“女王”的类比。密集向量则擅长语义相似度,但内存占用大。两者互补,混合搜索可兼顾精确与语义。
SPLADE如何通过术语扩展提升检索
SPLADE利用BERT生成稀疏表示,通过术语扩展为查询和文档添加相关术语。例如查询“太阳能优势”可能扩展出“可再生”“可持续”等词,从而召回更多相关文档。这种扩展能力使SPLADE在稀有关键词或专业术语领域(如医学)表现优异。同时,SPLADE的稀疏性可通过正则化调节,平衡扩展程度与计算开销,适应不同检索需求。
混合搜索的实践与融合策略
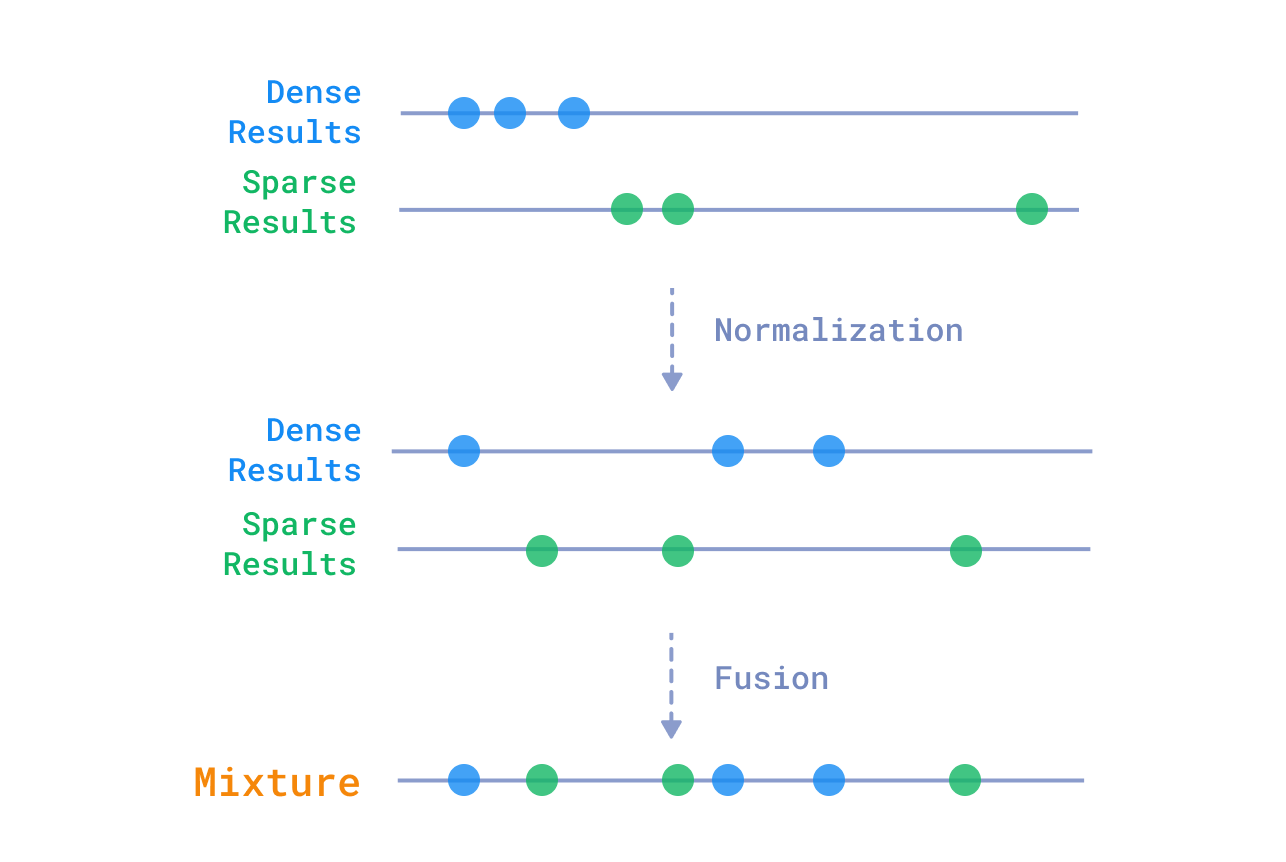
在Qdrant中,可为同一集合同时建立稀疏和密集向量索引,实现混合搜索。稀疏向量确保包含必需关键词的结果被返回,密集向量补充语义相似结果。结果融合可采用RRF、RSF等方法,或作为两阶段检索的第一阶段,再用交叉编码器重排。这种组合提高了检索的准确性和效率,尤其适合需要兼顾关键词匹配和语义理解的场景。
SPLADE的局限与注意事项
SPLADE的性能对池化策略敏感,最大池化虽提升效果,但也暗示基线方法的不足。此外,仅使用文档编码器而不使用查询编码器的SPLADE变体也能达到相近性能,这可能影响模型效率。稀疏向量本身在捕捉词语细微关系上不如密集向量,因此混合搜索时需权衡两者贡献。实际部署时,还需考虑索引内存和计算开销。
Q&A
稀疏向量的定义是什么?
稀疏向量是一种高效的数据表示方式,仅保留少量重要特征,从而提高计算效率。
稀疏向量在信息检索中有什么优势?
稀疏向量能够处理大规模文本数据,超越传统方法如BM25,特别在处理稀有关键词或专业术语时表现优异。
SPLADE模型如何提升稀疏向量的性能?
SPLADE模型通过扩展查询和文档的相关术语,提升了稀疏向量的性能,支持更好的检索效果。
稀疏向量和密集向量有什么区别?
稀疏向量大多数元素为零,专注于关键特征,而密集向量所有元素均为非零,捕捉更细致的关系。
如何在Qdrant中实现稀疏向量的混合搜索?
在Qdrant中,可以创建一个支持稀疏和密集向量的集合,并通过查询同时检索两种向量的结果。
稀疏向量在医学领域的应用表现如何?
稀疏向量在医学领域表现优异,能够处理许多稀有关键词或专业术语,这些术语在一般词汇中较少出现。
