


本文探讨AI基础设施的经济价值,强调智能的“丰裕”在于降低成本、提升能力,形成良性循环。通过降价(如GPT-5.6 Luna降80%)、优化计算效率(节省20%成本)和全栈协同,实现更高效智能。投资基于证据和需求,目标不是建最大设施,而是让智能更普及、更有用,惠及更多用户。
Furiosa提出了一种新型AI芯片设计,采用Tensor Contraction Processor(TCP),放弃传统的矩阵乘法,直接执行张量收缩。这一设计旨在简化计算过程,减少数据转换和内存管理的开销,提高AI计算效率,标志着AI芯片设计的范式转变。
六家AI芯片公司放弃传统硬件缓存和线程模型,采用软件管理的SRAM和数据流架构,以优化计算效率和降低能耗。这种设计强调显式数据放置和顺序执行,推动了AI专用芯片的发展。
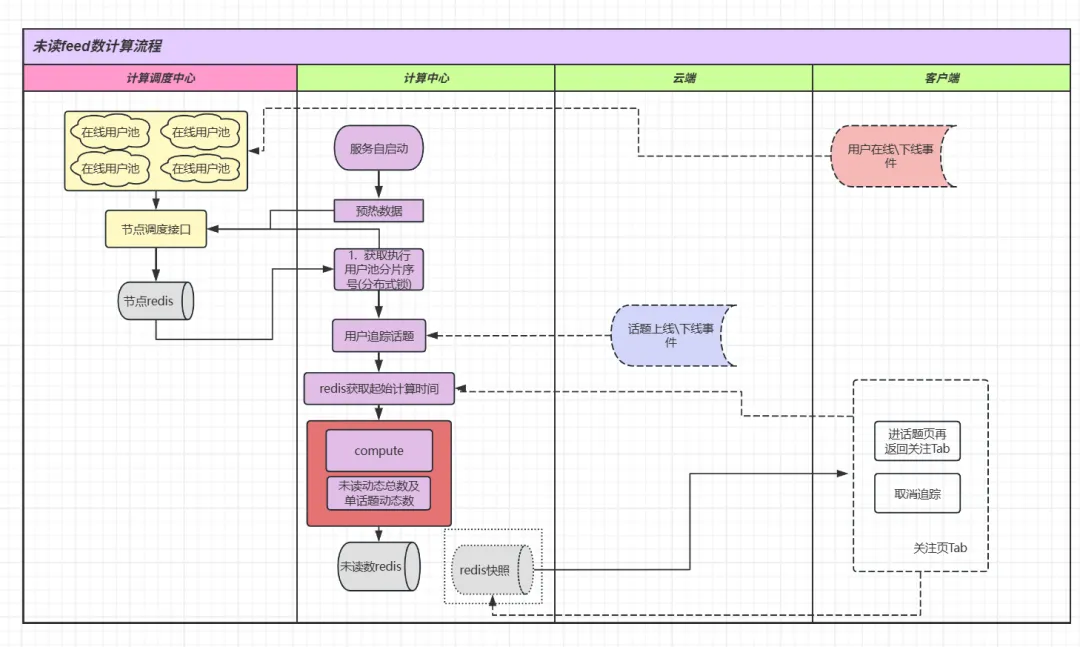
在互联网信息快速传播的背景下,未读消息的计算与提醒成为关键问题。本文提出一种新系统,采用分治思想和用户状态差异化处理,提升计算效率,降低存储成本,确保实时性和准确性。系统通过哈希算法管理在线用户,优化缓存策略,适应大数据量和高频更新场景,显著改善用户体验。该方案为互联网平台的未读消息处理提供了新思路,未来可结合AI和边缘计算进一步优化。
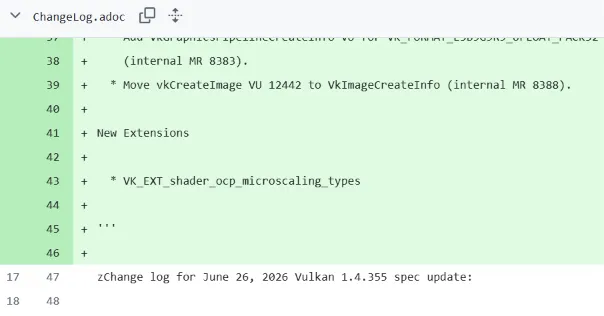
2026年7月3日,Vulkan 1.4.356 发布,新增扩展 VK_EXT_shader_ocp_microscaling_types,支持微缩放数据类型,旨在提升机器学习效率。该扩展由NVIDIA、三星等公司共同开发,重点在于提高计算吞吐量和降低内存带宽需求。
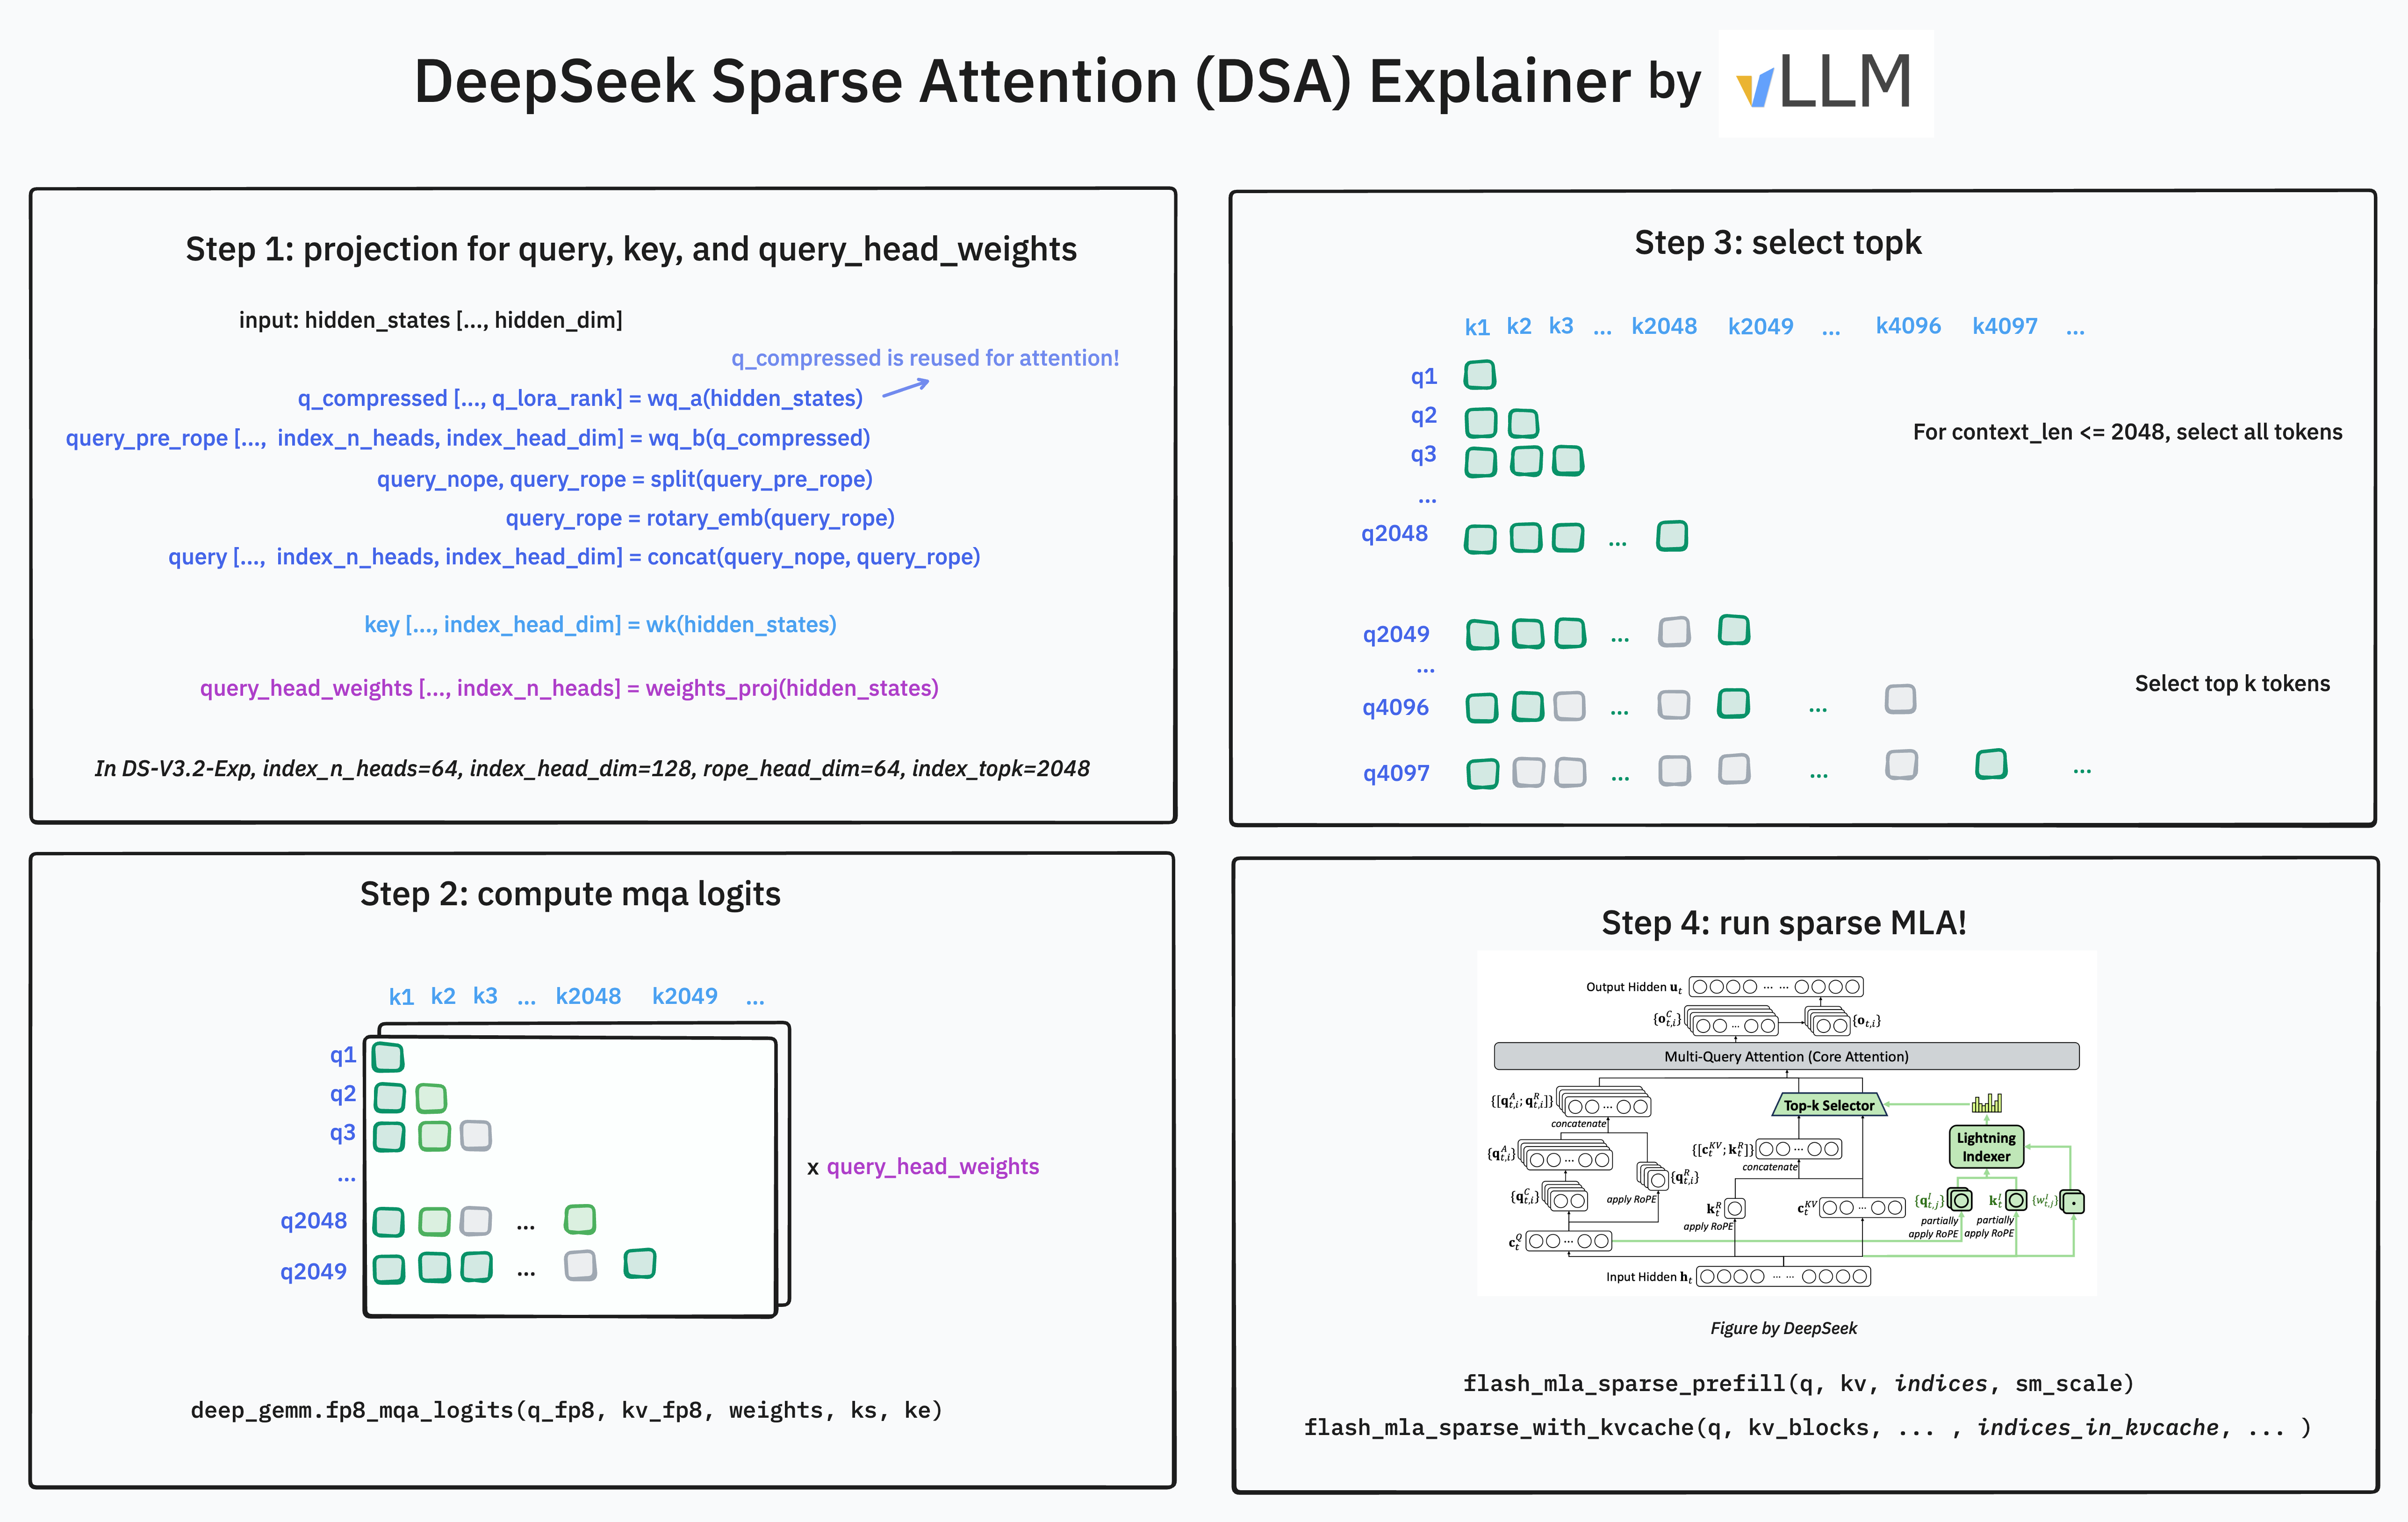
Subquadratic推出了小型模型SubQ 1.1,采用稀疏注意机制,能够处理长达1200万标记的上下文,显著提高计算效率。该模型在长上下文检索方面表现优异,适合企业数据处理需求。公司计划逐步向公众开放模型,并探索更高效的架构。
本文讨论了在多卡训练中通过重叠通信与计算提高效率的方法。重叠分为三个层次:第一层使用cp.async在内核内实现异步加载,第二层通过CUDA流实现内核间的并发,第三层利用NCCL在分布式环境中实现通信与计算的重叠。重叠可以隐藏等待时间,但也会导致资源争抢和同步开销。
MiniMax M3是最新的开源模型,优化了编码和多模态任务。其稀疏注意力机制显著提高了计算效率,减少了每个令牌的计算需求,提升了速度。该模型在Modular平台上可供企业客户使用,支持实时患者对话的灵活推理。
安纳智芯专注于模拟计算,解决了传统模拟计算的精度问题,开发出高精度的模拟芯片。这些芯片能够直接求解矩阵方程,显著提高计算效率。模拟计算具有更高的并行度和更低的功耗,未来可能改变AI基础设施,推动智能系统的发展。
本文介绍了为长时间运行的人工智能代理构建上下文修剪管道,以高效管理对话记忆。讨论了无界对话历史对大型语言模型的影响,并利用句子嵌入模型计算当前提示与历史对话的语义相似性。通过选择最近的对话和最相关的历史记录,构建精简的上下文窗口,从而节省计算资源和内存,提高效率。
SilverTorch是一种新型推荐系统,结合用户生成内容的检索组件,提升了吞吐量和计算效率。通过“索引即模型”方法,SilverTorch显著提高了推荐质量和响应速度,支持复杂模型和多任务评分,能够在低延迟下处理更多候选项,降低计算成本并加快工程迭代速度。
Elastic Cloud推出了基于Google Axion的CPU优化Arm硬件配置,性能提升达25%。该配置适用于搜索、监控和安全工作负载,用户可轻松创建或迁移部署,享受更高的计算效率和成本效益。
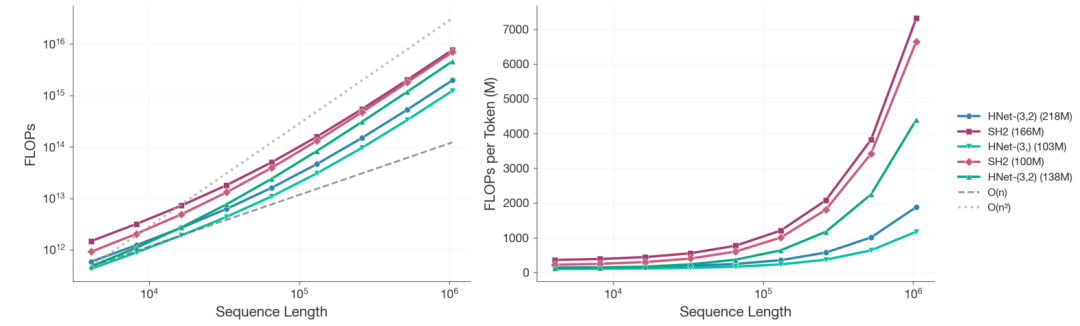
dnaHNet模型是一种新型基因组学习模型,通过动态分块机制自我学习序列结构,显著提升了计算效率和表达能力。在变异效应预测和基因必需性分类等任务中表现优异,计算成本降低3.89倍,为基因组解析提供了新思路。
普林斯顿团队发现英伟达B200 GPU因软硬件不匹配导致60%算力浪费,利用率仅为20%-30%。经过FlashAttention-4算法优化后,利用率提升至71%。该算法通过改进指数运算和内存管理,显著提高计算效率,并将编译速度提升至30倍。
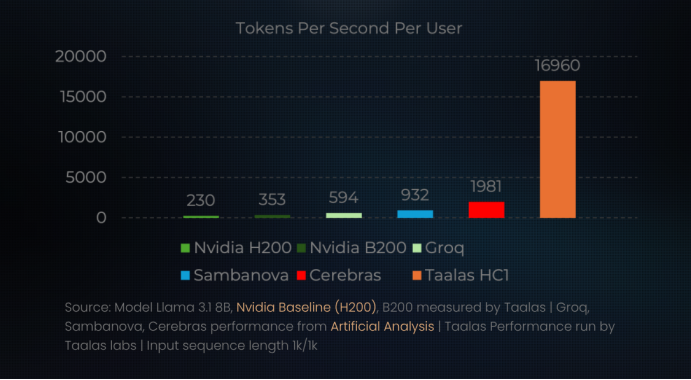
Taalas公司推出了一种新型AI硬件,将Llama 3.1模型直接固化在芯片中,显著降低输出延迟并提升计算效率。这种“模型即硬件”的设计克服了传统GPU的内存瓶颈,适用于复杂决策和实时推理,展现出优越的能效和成本优势。
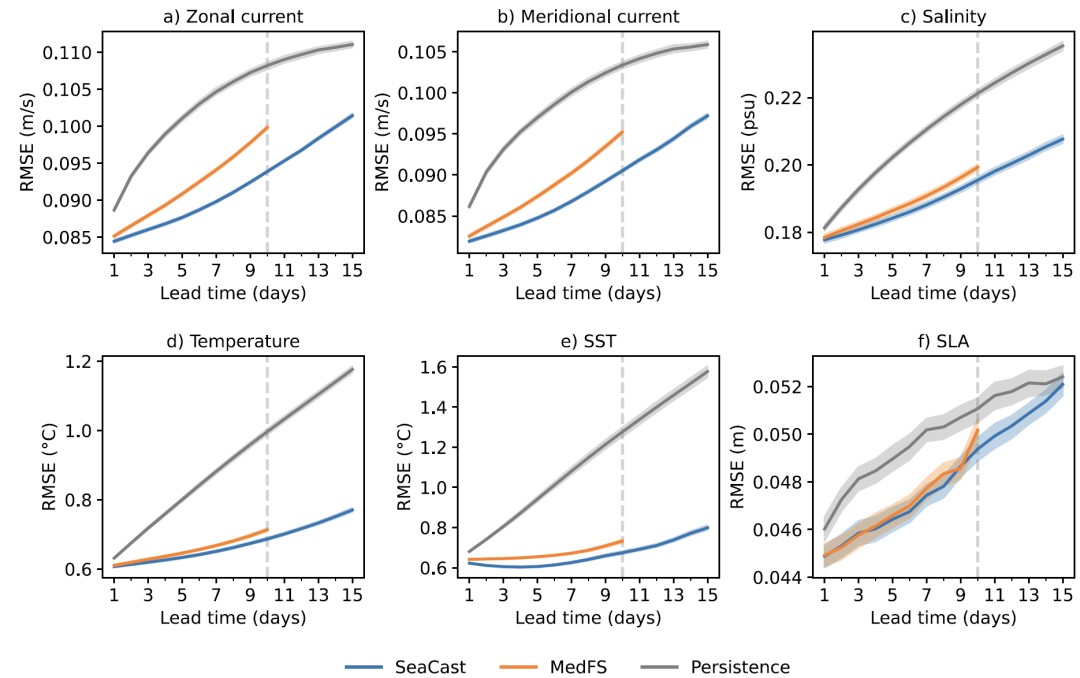
芬兰和意大利的研究团队开发了基于图神经网络的SeaCast模型,能够快速进行高分辨率海洋预报,显著提高计算效率和预报准确性,优于传统的MedFS模型。该模型通过历史数据训练,满足区域海洋预报需求,推动了人工智能在海洋预报中的应用。
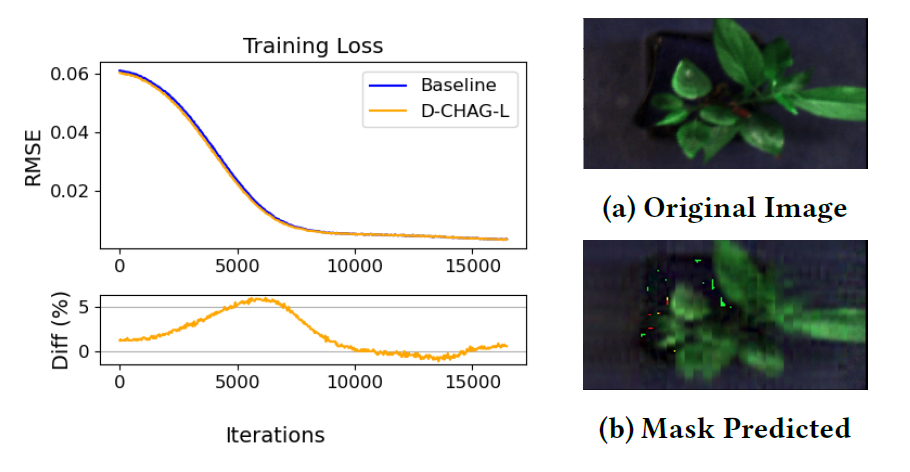
研究人员提出了一种分布式跨通道分层聚合方法(D-CHAG),有效解决了多通道数据集的内存瓶颈和计算效率问题。该方法在高光谱成像和天气预测任务中表现优异,内存占用降低75%,吞吐量提升超过2倍。
vLLM团队在NVIDIA GB200平台上优化性能,实现26.2K预填TPGS和10.1K解码TPGS,较H200提升3-5倍。通过低精度操作、内核融合和权重卸载等技术,显著提升计算效率和带宽利用率。
本文介绍了一种名为RoE的超并行推理框架,旨在提升大语言模型(LLM)在标记级别的预测质量。RoE通过动态组合多个专家模型,利用受控随机性为每个标记采样多个专家,从而实现更准确的预测。此外,该方法在计算效率上进行了优化,使得7B MoE模型的性能可与10.5B MoE模型相媲美,同时减少了30%的计算需求。
TPU(张量处理单元)是谷歌为深度学习设计的专用芯片,采用脉动阵列结构,显著提升计算效率。通过减少数据移动和优化矩阵运算,TPU解决了计算瓶颈,支持大规模语言模型的训练与推理。
完成下面两步后,将自动完成登录并继续当前操作。