GigaBrain-0.7 是具身基础模型,采用三系统架构:系统1基于 VLM 主干与动作专家生成连续动作;系统2负责理解与长程任务规划;系统3用世界模型预测未来视觉状态并评估进展。模型在超 3.7 万小时、16 种机器人形态的轨迹及约 2.7 亿视觉语言样本上单阶段联合预训练,并通过软知识隔离保持视觉语言能力,实现理解、预测、行动与经验改进的统一。
作者以联想Yoga 9n二合一笔记本为例,谈及对传闻中触屏MacBook的期待。Yoga 9n为16英寸可翻转设计,配手写笔,笔可在屏幕和触控板上使用,便于修图。作者希望苹果触屏MacBook支持Apple Pencil并支持吸附充电,同时期待苹果推出比简单翻转屏更有新意的设计,优化macOS触控体验,让高价产品物有所值。
招聘中的“AI经验”无统一标准,通常指四类:熟悉AI工具、了解机器学习概念、实际建模经验或特定领域AI知识,多数岗位只要求前两类。统计学背景与AI高度相通,回归、假设检验等技能可直接对应模型评估。求职者应细读职位描述正文而非仅看要求列表,按岗位级别调整表述,突出解决问题的判断力,而非罗列工具或证书。
JioHotstar工程师分享为2023年IPL板球决赛备战的经验:按预期流量两倍(5000万至7500万并发)设计容量,确保视频播放这条“黄金路径”绝不失败。重点包括提前扩容短信验证等认证系统,对合作伙伴严格压测并按延迟切换流量,用200项清单排查超时等故障点,进行全链路仿真测试,并设定严格延迟预算(内部服务10-15毫秒,关键API失败快速熔断)。建议统一优先级原则、挑战系统性能、识别并加固关键路径。
成为AI公司的难点在于领导力而非技术。四条经验:明确业务目标,将AI视为运营模式而非战略;先消除无价值流程,再简化并用AI加速;重新设计工作,让员工与AI协作;衡量业务成果而非采用率。AI应增强人与现有专长,而非单纯裁员,真正标准是业务能做什么新事。
Verifone架构师Yuri Geronimus在KotlinConf 2026分享:支付系统需满足多国监管规范,他用Kotlin类型系统将规范写入代码,让编译器强制校验。通过值类、密封接口、非空边界、脱敏默认等十种模式,使非法状态无法构造。成果:开发提速2.7倍,认证一次通过,代码减少30%。他强调遗留系统应渐进重构而非重写。
该文本仅为付费阅读和登录提示,无实质文章内容,无法总结。
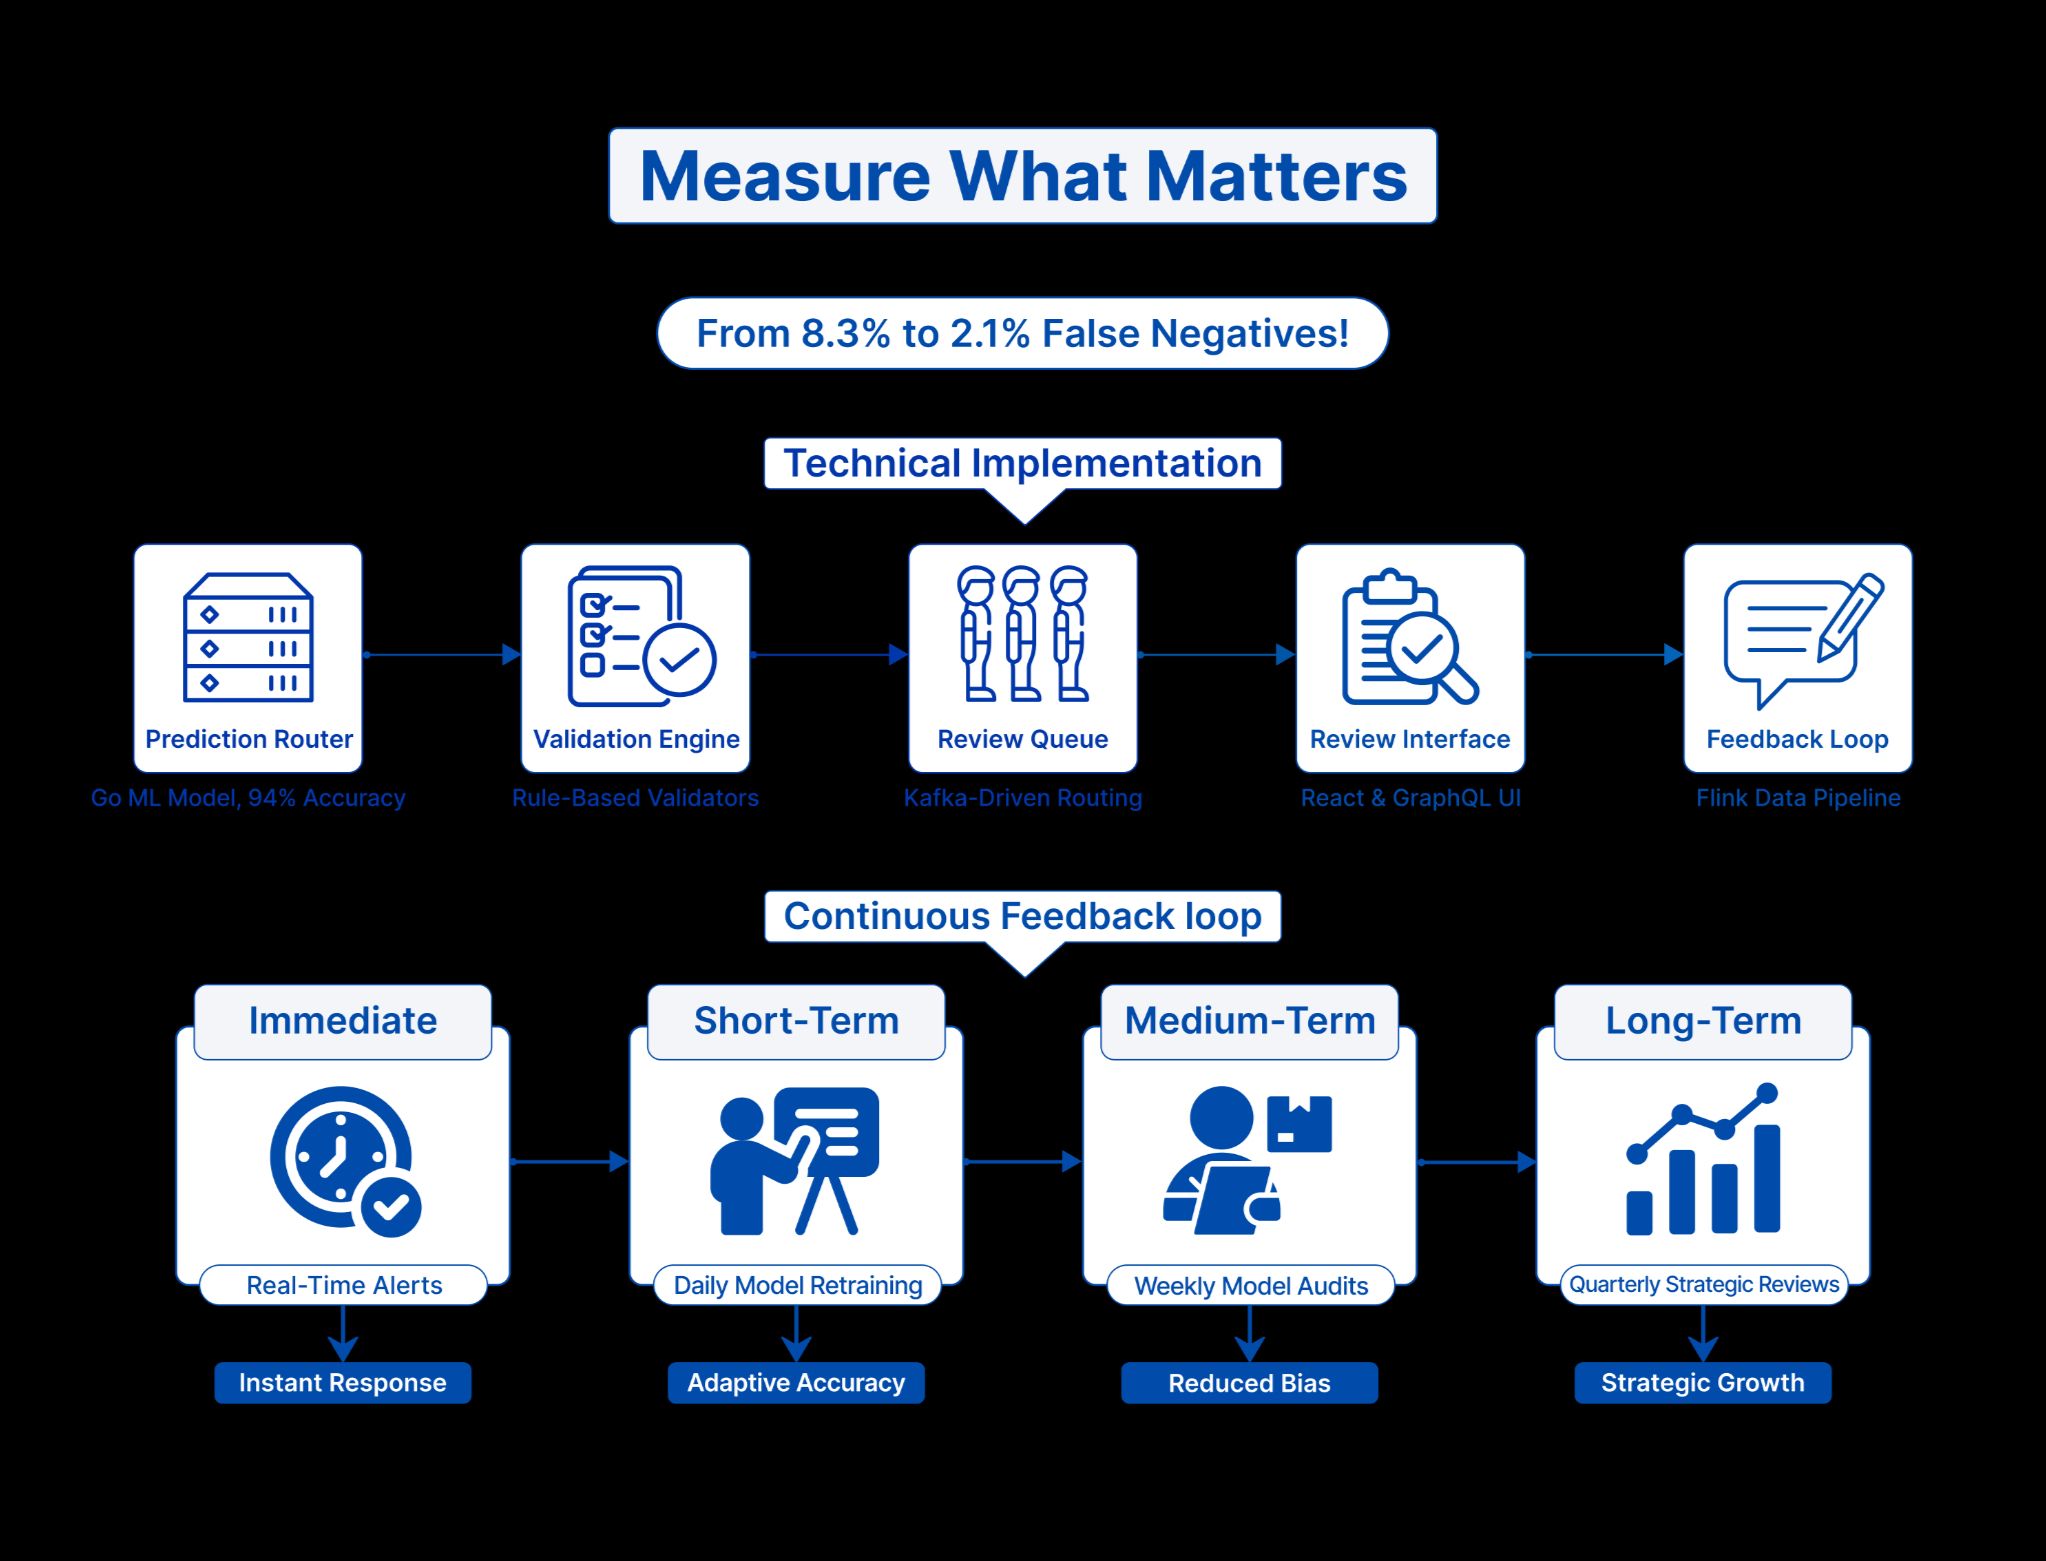
文章探讨“人在回路”(HITL)的利弊,指出盲目加入人工审核会拖慢系统、增加成本。有效做法是分层:约85%高置信度决策自动处理,12%异步专家复核,3%高风险案例实时人工介入。配合反馈闭环与工具优化,可兼顾速度与安全,将HITL变为竞争优势。
作者记账十年,发现传统记账只记录不解决问题,于是基于FIRE理念开发记账App「Coast」:将支出按固定、必要、弹性分类,自动生成预算,计算距离财务自由的时间,并让每笔消费显示对退休日期的影响。他还分享了Vibe Coding开发经验:需明确向AI描述问题、先建设计规范、善用Git、及时开新对话省Token,并强调App上线后运营推广才是真正难点。
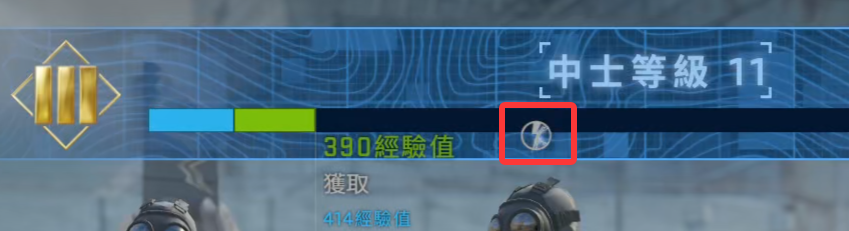
CS2经验结算分按胜局与按得分两套。死斗单局经验封顶75 XP,有效得分上限375分,超出作废。周常经验分四档:4500 XP内4倍、7500内2倍、11166内1倍,之后降至0.175倍。每周拿箱建议在周三4倍期组排竞技约三胜满5000 XP,休闲补缺,避免死斗脚本。
用户反馈 Qwen 3.8 Flash Next 未审查版长上下文出现多语言乱码。排查发现,BF16 舍入误差随生成累积,FP4/FP8 lm_head 扰动概率排序,导致语言混杂。修复方法:GDN 循环状态恢复 FP32,lm_head 使用原生 BF16,主体仍为 NVFP4。修复后连续生成约 1.1 万 tokens 无漂移,但显存增加、速度下降。建议日常使用官方原版量化,破甲版仅供研究。
OpenResty XRay AI Assistant Skill 让 Claude Code 等 coding agent 接入 XRay 真实采样数据,补齐运行时视野。以 Checkout 边缘服务为例,经三轮重构(精简审计对象、消除重复 JSON 编码、去除风控重复扫描),吞吐量从 336 RPS 提升至近 30,000 RPS。业务决策仍由工程师把关,且需目标机器已部署 XRay Agent。
MySQL性能优化关键在于innodb_buffer_pool_size和innodb_log_file_size两个参数。前者是InnoDB缓冲池大小,用于缓存数据和索引以减少磁盘I/O,建议设为系统内存的50%-80%;后者决定重做日志文件大小,影响写入性能与崩溃恢复,常规设置为128MB-512MB,写入密集场景可设为1GB-2GB。合理调整这两个参数可显著提升性能。
作者被裁后记录求职经历:公司按倒序名单快速裁员,四小时内离职。求职中用AI写简历、模拟面试,但猎头鱼龙混杂,招聘平台算法推荐低效,AI电话骚扰,职位普遍强求AI经验,诈骗职位与凑数、剽窃、不平等面试频发,流程冗长且HR常不反馈结果。作者最终倒在最后一轮,选择重新出发。
NVIDIA供应链案例表明,专用30B模型经专家决策轨迹训练后,在内部基准上超越更大通用模型。关键在于记录专家决策时的所见、理由与结果,并避免数据泄漏。企业应先设计决策记录与评测集,再考虑微调,适用于重复、可观察、有规律的任务。
作者分享Qwen模型移植经验:DeepSeek V4 Flash和Qwen 3.8 27B未审查版移植正常,但Qwen 3.8 Flash Next未审查版在输出超过5K时出现中英韩混合乱码,归因于训练不严谨。通过设置温度0.3、top_p 0.95、top_k 20,并统一模型ID为qwen3.8-flash-next-uncensored可解决。作者已更新算力舱内多个模型,后续将继续优化。
Meta推出ZGateway代理层,置于ZippyDB键值存储前,统一客户端流量。它通过连接管理、请求批处理、负载均衡和准入控制,将百万级客户端与数据库的密集连接网格压缩为可控层级,降低约97%连接数,支持跨区域容灾,并计划未来实现全流量统一及AI驱动的智能运维。
Vercel通过200多次试错,将设计师反馈转化为Agent可执行的规则。他们发现仅靠design.md不够,需结合固定场景、程序检查和人工评审。关键是将模糊要求具体化,如“表格用完整宽度”,并分层处理:样式用stylesheet,判断留guidance。最终错误减少57%,但强调需持续迭代,从周报小规模测试开始。
本文分享了作者使用Linux作为日常操作系统的经验和心得,包括选择发行版和桌面环境、Linux的门槛不高、软件生态的发展等。使用Linux的好处有老机器焕发新生、环保与资源利用、锻炼解决问题的能力。
西门子Xcelerator是开放式数字商业平台,旨在推动工业AI规模化落地。它通过Eigen工程智能体等自研产品、开发套件和Marketplace生态,解决工业场景复杂、部署成本高的问题,让AI智能体在真实工厂中持续生长,而非简单售卖软件。
完成下面两步后,将自动完成登录并继续当前操作。