本文介绍 EKS Fargate 实现无服务器 Kubernetes 的方式:通过准入 Webhook 将符合 Fargate 配置的 Pod 路由至专用调度器,按需创建独立计算环境,而非从节点池中选择。运行时提供 Kubelet 等节点组件,并利用网络命名空间隔离平台、节点与工作负载流量,每个 Pod 获得独立 ENI。EKS 还通过 PodAdmitHandler 限制单 Pod 单环境,并定期以 Eviction API 优雅替换 Pod 以完成打补丁。
DataMax是PolarDB新增的专用WAL日志节点,仅持久化并级联WAL、不重放日志,无需完整数据库副本,存储与CPU成本远低于普通备库。它可与主节点同可用区部署并参与同步提交,低延迟提供第二份持久WAL,同时向下游备库异步级联。通过新增'e'消息传递事务ID纪元、WAL保留边界等状态,并借助initdb指定系统标识完成握手,DataMax无需基础备份即可加入复制链,还支持时间线切换与安全提升。
2026年国芯展上,燧原科技首次参展,展示高性能超节点系统及软件平台能力,分享国产算力在工业、泛互联网等场景的落地实践,其“国芯国模高效能适配优化系统”获创新成果奖。公司还推出与中兴通讯共同开发的正交架构“云燧ESL64-O”超节点,采用高密集成、零线缆设计,可支撑万卡级以上集群组网。
StackGres 团队使用开源 Citus 在 EKS 上进行基准测试,在单行主键读、无写入场景下,以 24 个 worker 和 48 个查询路由器实现 1000 万 TPS,p50 延迟约 1 毫秒。相比 PlanetScale 的 Neki,Citus 以不到一半的数据节点和约 65% 的 vCPU 达到同等吞吐,成本约为其五分之一。团队将公开复现代码。
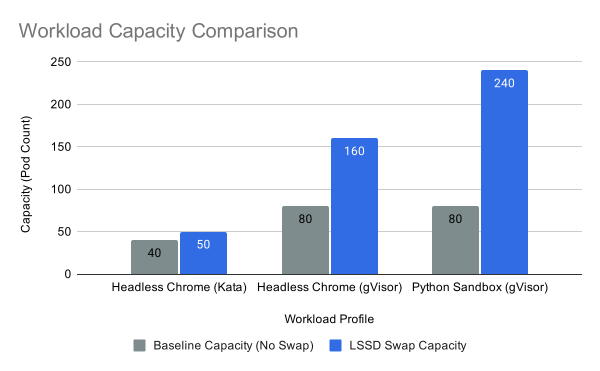
Kubernetes v1.34 起正式支持节点交换分区。使用 NVMe SSD 作为交换设备,可将闲置内存换出,显著提升 Pod 密度。测试表明:内核编译内存限制降低 50% 无性能损失;Python 沙箱并发从 80 增至 240,密度提升 3 倍,延迟主要源于 CPU 竞争而非交换 I/O。建议配置 LimitedSwap 并采用 Burstable QoS。
本文介绍Kubernetes的DaemonSet:其Pod可通过推送、主机端口、headless service的DNS或Service方式通信;节点标签变化时自动增删Pod,1.6版本起支持滚动更新。相比初始化脚本、裸Pod和静态Pod,DaemonSet更便于管理守护进程并自动替换故障Pod;与Deployment不同,它确保每个节点运行一个Pod。
Azul推出Intelligence Cloud AI助手,支持用自然语言查询实时Java运行环境,取代易过时的静态报告。由于AI加速漏洞利用,补丁窗口从32天缩短至5天,企业需持续掌握JVM与代码清单,以防范安全、合规及许可风险。
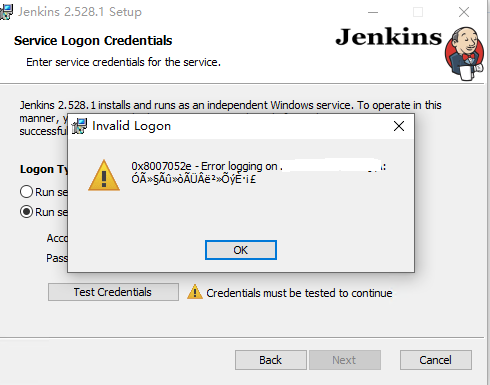
本文介绍 Jenkins 在 Windows 上的安装与配置:下载 LTS 安装包,推荐以服务方式启动,若遇服务登录凭据报错需在本地安全策略中添加管理员用户;支持 JDK 17 和 21,推荐 21;安装后验证密钥、创建管理员、安装推荐插件,并升级 Jenkins 及插件,使用 SVN 需手动安装 Subversion 插件;还介绍了配置节点和共享库的方法。
浪潮信息在AICC2026发布元脑SD200 Ultra超节点AI服务器,基于本土AI芯片,单机可运行2.8万亿参数Kimi K3大模型,Token生成时延低至5.85毫秒,支持10万亿参数模型,推理性能提升3倍以上。同时发布元脑HC2000多元算力机组,同等投资下Token产能提升10倍。
华为发布灵衢互联架构及超节点集群产品。该架构实现协议归一、内存语义,带宽达TB级,时延压缩至2微秒,支持CPU、NPU、内存、SSD等直接互联,降低大模型训练对单卡HBM需求。同时发布三级互联设备,支持百万卡集群扩展,以及由鲲鹏950、昇腾960超节点等组成的Agentic AI超节点集群。
本文介绍如何利用 Amazon DynamoDB 的租约机制构建弹性实时 WebSocket 工作节点集群:通过条件写入实现分布式锁,保证每个连接仅由一个工作节点持有;借助心跳续约检测故障,租约过期后由对账循环自动接管,实现秒级故障转移;支持优雅关闭以实现低停机部署,并利用 CloudWatch 指标驱动自动扩缩容。
Kubernetes v1.37 引入五个标准节点状况:DrainInProgress、Drained、MaintenancePlanned、MaintenanceInProgress、GracefulNodeShutdownInProgress,用于统一描述节点排空、维护和优雅关闭状态。该功能为 Alpha 且默认关闭,暂不影响核心组件行为,由管理员或授权控制器设置。它提供共享状态信号,提升运维可见性,避免组件因信息不足而冲突,未来将支持 DaemonSet 滚动更新等场景。
本文介绍EKS上GPU工作负载的架构实践,涵盖计算节点、网络邻近性和高性能存储三层。重点包括:EFA多网卡配置(含p6-b300特殊拓扑)、四种定价模式、基于AWS原生拓扑标签的调度、FSx for Lustre与S3 Express One Zone存储选型,以及Terraform模块实现,旨在提升分布式训练性能。
NDI宣布其全球硬件节点超120万个,涵盖200多个品牌,应用于广播、专业视听等领域。Sky、BBC等组织利用该标准连接设备与AI工具,摆脱供应商限制。NDI旨在成为传输层,支持AI驱动的视听体验。负责人称里程碑属于整个生态系统。
中诚华隆发布HL200推理芯片及超节点智算集群,实现国产AI推理算力从单点突破到万卡级集群协同升级。芯片支持FP4/FP8低精度,能效比领先,适配主流大模型。集群方案覆盖8卡至万卡部署,优化算力密度与能效,推动大模型规模化商业落地,并与多家企业合作共建国产算力生态。
27所高校联合成立教育网镜像站MirrorZ,聚合各校资源,自动为用户选择最佳节点,支持指定或排除特定镜像站,并提供状态看板。项目由清华发起,多校维护,代码开源,旨在解决镜像站分散、速度不稳等问题。
Cilium的L7服务网格能力基于BPF处理L3/L4,按需将流量重定向至节点Envoy处理L7语义,与sidecar和Istio Ambient模式不同。它适合以身份和L3/L4策略为主、L7规则较少的场景,但节点Envoy是共享故障域,且不覆盖完整Istio流量管理功能。开启时应渐进验证,避免“假网格”承诺。
本文介绍Neo4j图数据库生产环境排障方法,核心是“三轴分流”:先判断慢查询属于计划基数(轴A)、存储I/O(轴B)还是锁/并发(轴C),再对症处理。文章强调超节点问题应优先优化建模与查询而非硬件,并给出内存三分(page cache、heap、OS)的配置与指标解读,以及锁死锁排查、慢查询固定流程和症状速查表。
本文介绍Neo4j图数据库record存储引擎布局:节点15字节、关系34字节、属性41字节、关系组25字节,均采用定长记录加指针链表结构。稀疏节点直接扫描关系链,密集节点通过关系组按类型分桶。aligned为Community默认格式,block为Enterprise推荐格式。
AMD MI355X在运行Kimi K3模型时,凭借更低价格和更高每美元吞吐量,性能超越英伟达B300。通过修复投机解码和预填充内核的软件缺陷,MI355X单节点速度达到B200的3.8倍,首字延迟大幅降低。文章认为,CUDA生态并非不可撼动,硬件性价比和工程师修bug能力正成为新护城河。
完成下面两步后,将自动完成登录并继续当前操作。