Databricks提出企业AI应转向客户对话场景。语音智能体需结合受治理的数据、业务本体和快速决策模型,实时理解来电者身份与上下文,在规则内提供个性化服务,必要时转接人工。其架构分为对话层与运行于Databricks平台的“大脑”层,确保数据安全合规。每次通话可记录、评分并持续优化。建议从高频常规通话入手,用开源DIVA蓝图开展90天试点。
亚马逊推出首款数字相框Alexa Photo Frame,黑色款售价199.99美元,木质边框款229美元。该相框配备10英寸防眩光触摸屏,可显示Amazon Photos照片,Prime会员享无限存储且无需订阅。它支持Alexa Plus语音控制,能根据光线、笑容和季节智能挑选照片,自动跳过截图等无关图片,还可生成对比组图。用户可通过App为照片添加语音备注,送礼时可预载照片和语音。相框不显示广告。
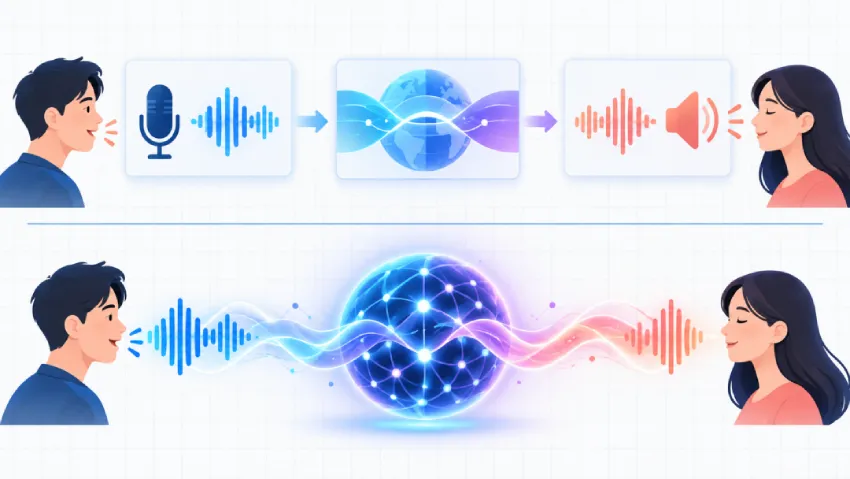
语音到语音同传的难点不在翻译本身,而在于一句话尚未说完时就要边听、边理解、边翻译并自然说出。传统ASR、翻译、TTS三级流水线易误差传递、丢失语气。同传核心是把握开口时机,在准确、实时、自然间取舍,并保留语义、表达与说话人特征。评价需兼顾准确性、延迟、稳定性、自然度与鲁棒性。技术正从级联走向更统一模型,两条路线各有优劣,也可组合使用。
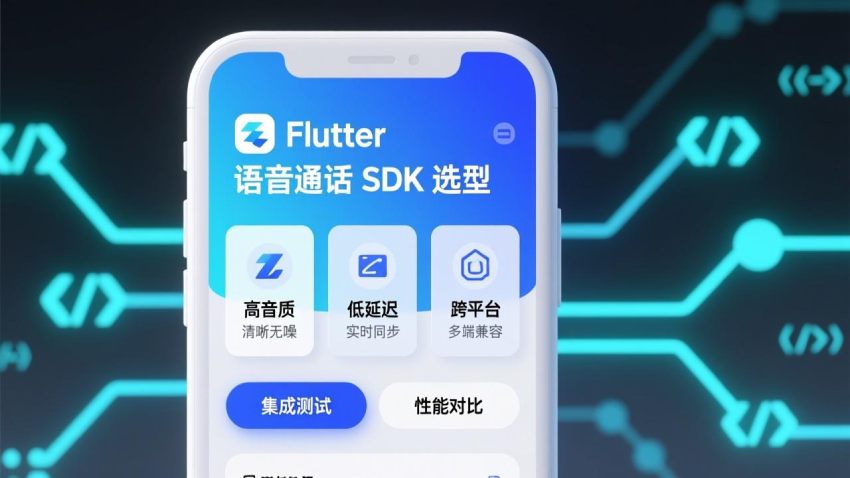
Flutter 语音通话选型需按场景决定。文章从 SDK 成熟度、音质、功能、全球覆盖、计费、合规、集成效率七个维度对比 ZEGO、Agora、LiveKit、Twilio、SendBird、腾讯 TRTC、网易云信七家方案:出海社交与语聊房推荐 ZEGO(500+ 节点覆盖 212 国、弱网抗丢包 80%、端到端 70ms);AI 语音对话选 LiveKit;落地电话线选 Twilio;国内可选 TRTC。集成时需注意 iOS 的 PushKit+CallKit、Android 前台服务保活等问题。
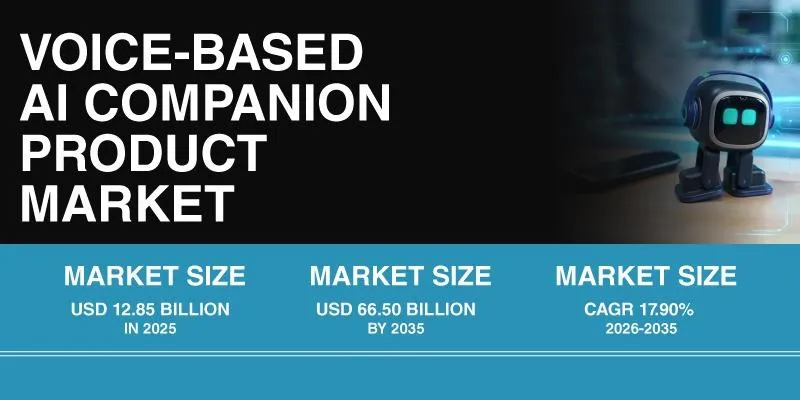
SNS Insider报告显示,2025年语音AI陪伴产品市场规模为128.5亿美元,预计2035年达665亿美元,复合年增长率17.90%。增长动力来自心理健康意识提升、生成式AI进步及智能设备普及。北美2025年以37.20%份额领先,亚太预计2026至2035年增速最快达24.60%。细分上,嵌入式AI伴侣占41.30%,个人消费者占52.60%,生产力与个人助理应用占30.80%,云端部署占48.90%,订阅模式占42.50%。市场也面临隐私、算力成本和AI伦理等挑战。
iRTE2026实时智能大会聚焦对话式AI从“会答”转向“持续参与真实交流”,核心挑战包括模型能力与业务结果对齐、实时对话底层技术底座,以及技术落地终端硬件的现实考验。声网提出五级对话能力框架,并展示多模型协作、实时推理云及对话式AI引擎等基础设施,推动语音识别、推理、传输与终端响应全链路协同。
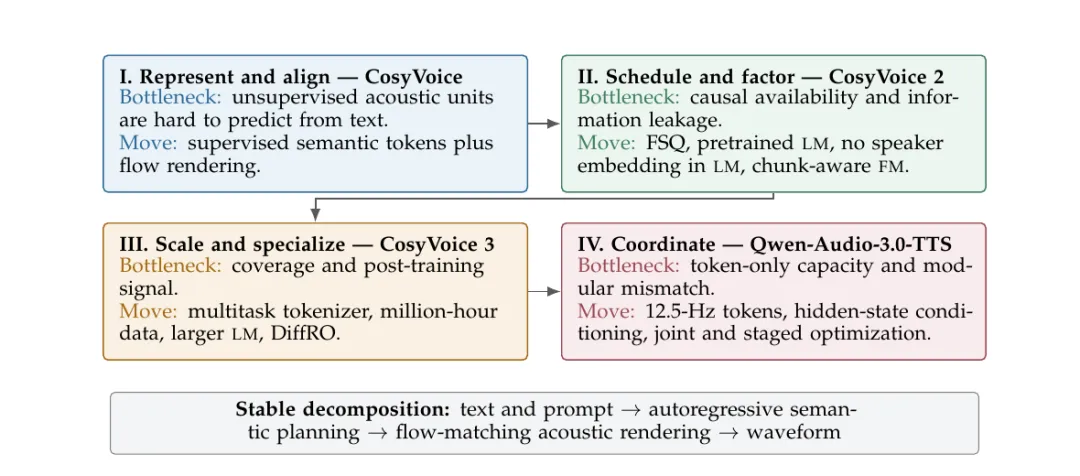
文章回顾了从CosyVoice到Qwen-Audio-3.0-TTS四代语音系统的演进,主线是在“LM语义规划+FM声学渲染”框架下接口的持续升级:CosyVoice用有监督语义码本解决表征问题;CosyVoice 2以FSQ和职责重划支持流式;CosyVoice 3扩大数据与模型规模并引入后训练;Qwen-Audio-3.0-TTS降低帧率、扩大容量,以连续隐状态作为渲染条件。作者据此提出表征、归属、可用时序、梯度可达四维接口框架。
微软在Foundry平台推出三款语音AI模型:MAI-Transcribe-2-Streaming可实时转写语音,数百毫秒内生成初步结果并逐步修正,在准确率榜单上排名第一;MAI-Voice-2.1主打多语言自然语音合成;Flash版优化高并发场景的响应速度与成本。业内人士认为语音AI已趋成熟,但真正难点在于判断对话轮次,延迟与轮次管理须同步改进,否则加速反而导致更多打断。
FunAsrNet 是纯 C# 实现的语音推理项目,基于 .NET 10,不依赖 Python、ONNX Runtime 等原生框架,自行实现模型加载、算子、解码、VAD 和中文 TTS。性能上,CPU 语音识别接近原版 C++,ARM64 上快 15%–27%,但 GPU 仍落后数倍。项目文档如实记录差距与失败,价值在于证明 .NET 可承载完整语音流水线,便于审计、维护和部署。
Ribbon推出Call Trust深度伪造检测方案,基于会话边界控制器在网络层分析通话流,用专利算法识别AI合成音频,无需用户安装应用,可大规模部署。语音钓鱼攻击激增,41%首席信息安全官过去一年遭遇语音深度伪造攻击。该方案计划2027年一季度开始客户试验,帮助运营商和企业重建语音通信信任。
Procore在Groundbreak 2026发布语音优先移动应用Procore AI Go,施工班组可用自然语言查询图纸、RFI、规格书等项目数据并获语音回答,现面向北美公测。Procore还与Meta合作将该应用引入智能眼镜,实现免手操作。应用支持按住说话和对话历史,未来可创建施工日志、起草RFI并引入AI智能体。研究显示深入应用技术每人每周可节省两到六小时。
Mistral AI发布Voxtral 3语音模型家族及配套SDK,包括3个转写模型、1个TTS模型和基于LiveKit的语音智能体SDK,均已在Mistral API公开预览。Small Transcribe 3的AA-WER为2.1%,排名第三,说话人分离表现最佳,但实时模式精度落后于Gemini 3.5 Realtime。批处理转写每分钟0.0035至0.004美元,TTS每百万字符13美元,未宣布开源权重。
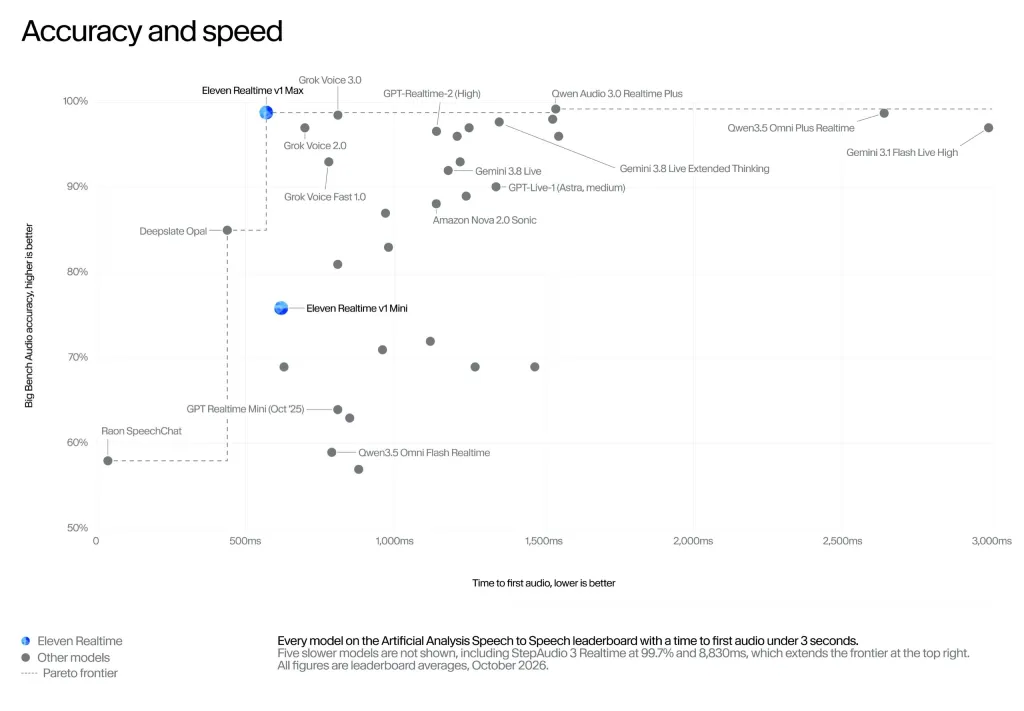
ElevenLabs发布两款实时语音识别模型:v1 Max在Big Bench Audio基准得分98.8%,响应仅0.57秒,兼具高精度与低延迟,面向客户支持等复杂任务;v1 Mini主打低成本自然对话,能识别对方发言结束或“嗯”等语气声。两者均可通过ElevenAgents平台及兼容OpenAI的实时API使用,按分钟加代币计费,Max价格更高。
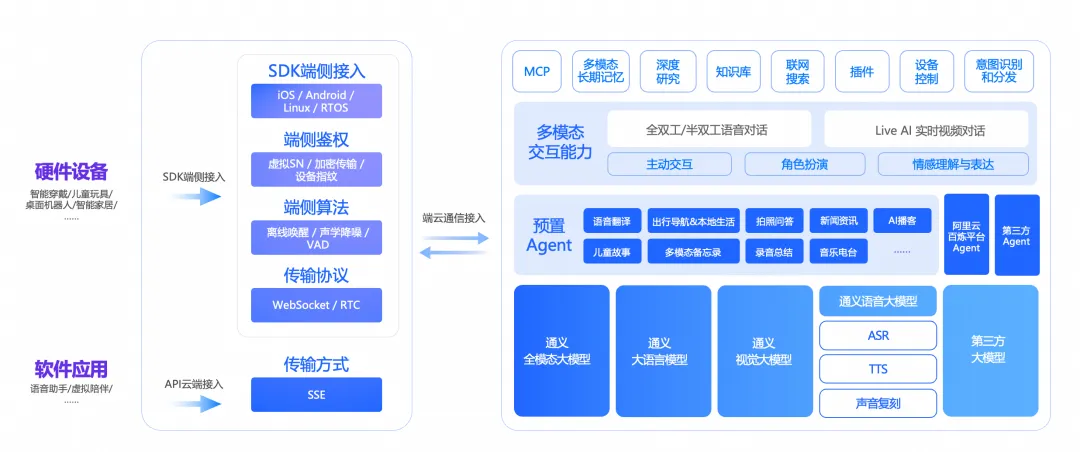
阿里云百炼多模态实时交互套件升级至Qwen-Audio-3.1,面向AI眼镜、学习机、汽车、机器人等硬件提供级联式语音交互方案。ASR支持30种语言、16种中文方言及热词识别,首字响应约160毫秒;TTS支持跨语言同音色与情绪语速调节,Elo评分全球第一。套件端到端延迟最低1秒,一套SDK适配30多个硬件平台,TTS降价约70%、ASR降价95%,并提供设备管理与运营能力。
ElevenLabs推出Eleven Realtime,提供Mini和Max两款托管语音代理模型,整合语音识别、推理、轮流对话与语音生成,但开发者无法独立配置底层模型。Max在语音推理和工具调用上更强,Mini适合多数场景且轮流对话表现略优。该服务兼容OpenAI Realtime API协议,但迁移需改用WebSocket并自行处理音频。
monday.com于10月19日发布语音AI销售平台Harmony,面向美英澳新中大型企业,整合自动外呼、线索资格判定、跟进、CRM更新与人工转接。技术路线为多个面向特定任务的专有小型模型分工协作,由实时预测引擎统筹,公司自述延迟约200毫秒、接通率最高70%。平台整合收购自OneAI的语音技术,基于Twilio,支持HubSpot、Salesforce等CRM回写,并提供可视化代理构建器与API。客户案例显示资格判定与实时转接有助提升成交,但效果仍待真实通话检验。
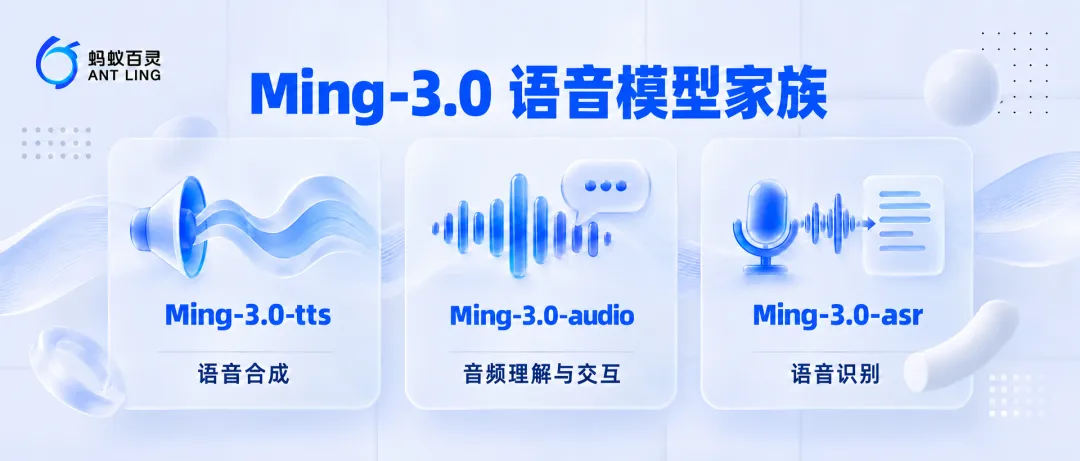
蚂蚁百灵开源Ming-3.0语音系列,共五款模型,覆盖语音合成、音频理解与对话、语音识别。TTS支持文字设定音色、导演模式调控情绪节奏及行内副语言标签,0.5B小模型表现突出;audio-flash/tiny可直接理解长音频并结构化输出,保留情绪与说话人信息;asr-tiny支持热词与上下文注入,提升口音、术语识别准确率。未来将探索Voice Agent长程复杂任务。
文章讨论端侧音视频降噪:语音降噪在频域用DNN估计0~1掩码并乘回频谱,RNNoise风格模型约150K参数,可实时运行;视频降噪结合时域多帧对齐与空域CNN,低端机可退化为单帧。核心是平衡降噪强度与听感、实时预算和场景泛化,并给出掩码下限、帧间重叠、旁路音乐、运动补偿等问题的修复方法。
日本语音AI公司Kotoba的语音技术已在生成式媒体平台fal上线,开发者可直接调用三项能力:针对日语及东亚语言调优的语音识别、支持流式输出的日语语音合成,以及流式输出音频与文本的实时语音翻译。开发者无需自建模型与推理链路即可产品化落地,流式能力可缩短首字响应时间,改善实时交互体验。
苹果发布带屏智能音箱HomeView,放弃纯语音路线,转向“语音+屏幕”的家庭智能中枢,思路与国内小度科技趋同。小度2018年布局带屏音箱,2026年推出“家庭智能体中枢”战略,可自主拆解任务、调度设备、闭环交付。凭借低价和开放生态,小度已进入超5600万家庭,为本土家庭AI提供更落地的样本。
完成下面两步后,将自动完成登录并继续当前操作。