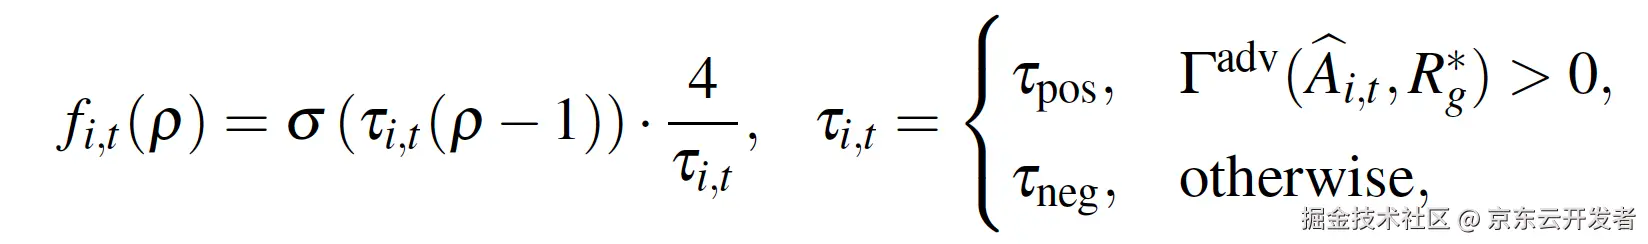小红花·文摘
  • 首页
  • AI Tokens🪙
  • 排行榜🏆
  • 直播
  • FAQ
沉浸式翻译 immersive translate
Dify.AI
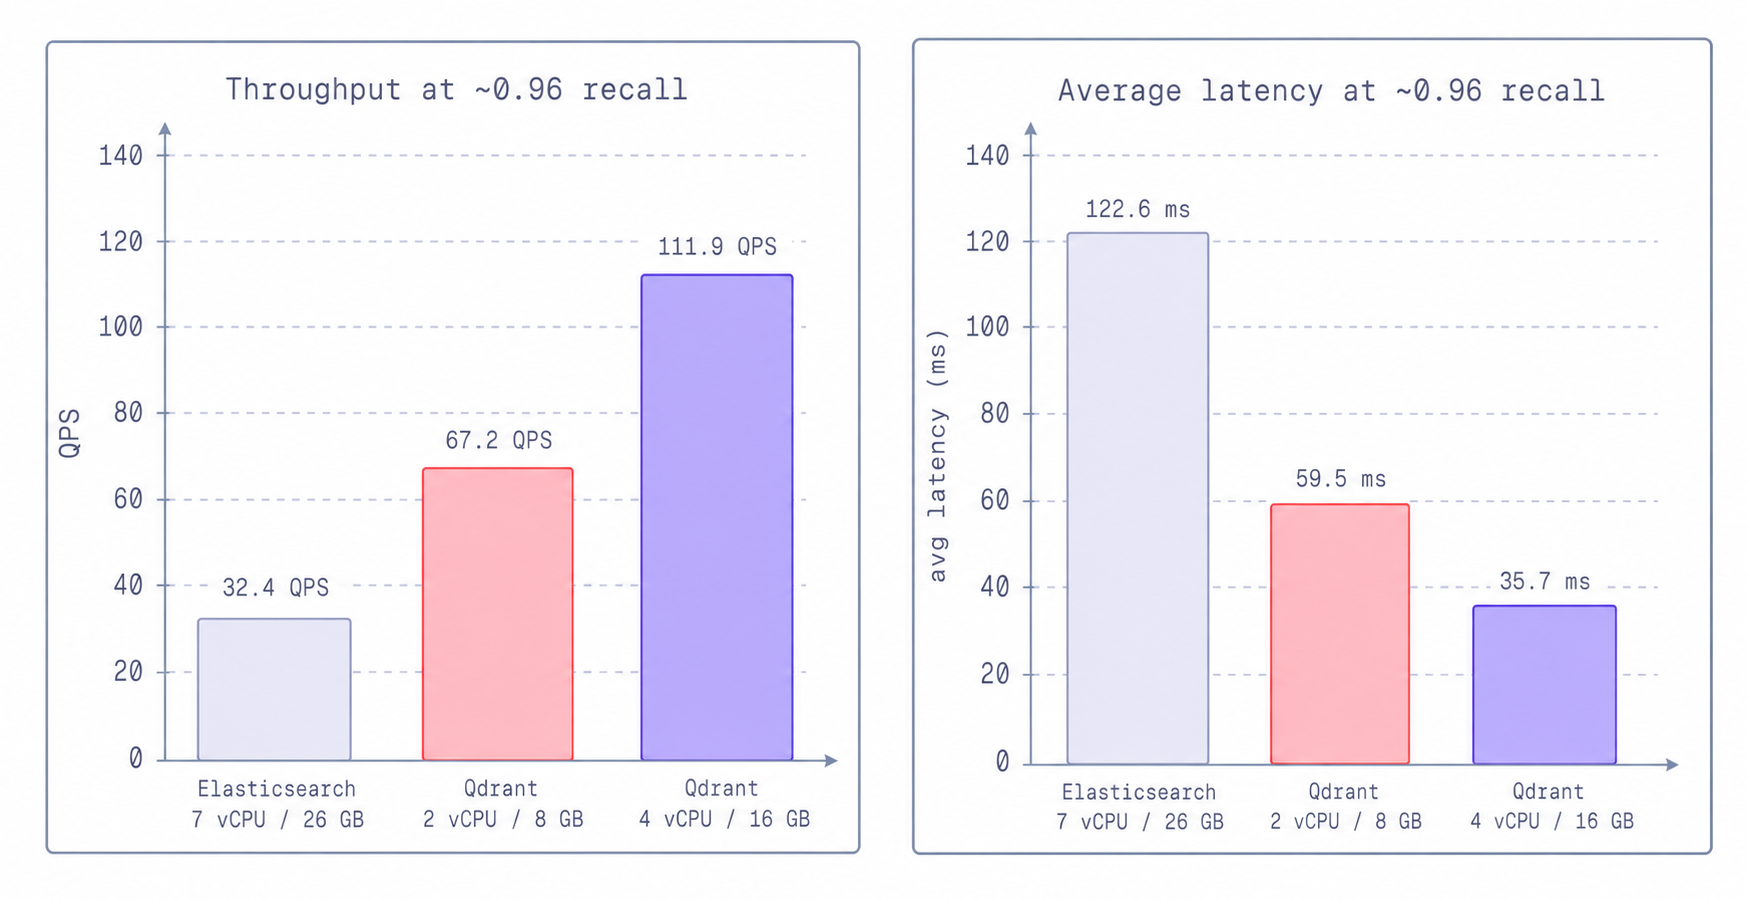
Qdrant在吞吐量上提高了2倍,延迟降低了50%,计算资源减少到1/3,超越了Elastic的DiskBBQ

Qdrant在基准测试中表现优于Elastic的DiskBBQ,吞吐量提高了2倍,延迟降低了50%。在相同的召回率下,Qdrant使用更少的CPU和内存资源,显示出更高的效率。Elastic的测试方法未能充分利用Qdrant的特性,导致结果偏差。Qdrant的两阶段检索和异步评分技术显著提升了性能。

Qdrant在吞吐量上提高了2倍,延迟降低了50%,计算资源减少到1/3,超越了Elastic的DiskBBQ

Qdrant - Vector Database Qdrant - Vector Database · 2026-07-08T00:00:00Z
Spring AI动态工具发现:省下75% token消耗

Spring AI推出了一种动态工具发现机制,显著降低了AI对话中的token消耗。通过按需加载工具,避免了冗余开销,测试显示token消耗减少近四倍,尤其在工具数量较多时效果明显。这种设计思路提升了资源使用效率。

Spring AI动态工具发现:省下75% token消耗

极道 极道 · 2026-07-02T03:10:00Z
突破传统限制:OxygenREC--一个基于指令跟随的“快慢思考“电商生成式推荐框架

京东零售OxygenREC团队提出了一种新型生成式推荐框架OxygenREC,旨在解决电商推荐系统中的推理能力、延迟、资源效率及多场景适应等问题。该框架结合“快慢思考”模式,实现一次训练多场景部署,显著提升推荐效果和资源利用率。

突破传统限制:OxygenREC--一个基于指令跟随的“快慢思考“电商生成式推荐框架

京东科技开发者 京东科技开发者 · 2026-02-11T06:13:00Z
OpenAI通过Fluent Bit优化回收了30,000个CPU核心

在2025年的KubeCon+CloudNativeCon上,OpenAI的Fabian Ponce强调了优化的重要性。他们通过Fluent Bit处理数据,发现fstatat64函数占用了35%的CPU。关闭该功能后,节省了约30,000个CPU核心,显著提升了资源效率。Ponce指出,分析性能瓶颈至关重要。

OpenAI通过Fluent Bit优化回收了30,000个CPU核心

The New Stack The New Stack · 2025-11-13T16:30:38Z
打破‘无共享’瓶颈:一种NoSQL范式

NoSQL数据库采用分布式架构和本地存储以实现高性能和低延迟,但直接附加存储(DAS)在现代数据中心面临成本和管理挑战。现代SAN解决方案提供高性能和数据服务,有效替代DAS,支持可持续发展和资源效率。

打破‘无共享’瓶颈:一种NoSQL范式

The New Stack The New Stack · 2025-10-23T15:00:18Z

本研究针对机器学习服务中的隐私问题,提出了一种基于密码技术的私密变压器推理方法,以保护用户数据和模型隐私,并回顾了相关进展与挑战。研究表明,该方法能有效平衡资源效率与隐私保护。

机器学习即服务中的私密变压器推理:综述

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-05-15T00:00:00Z

本研究通过QLoRA微调的LLM与检索增强生成技术,提高医疗决策支持系统的准确性和资源效率,同时关注患者隐私与数据安全。

Lightweight Clinical Decision Support System Based on QLoRA Fine-tuned LLM and Retrieval-Augmented Generation

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-05-06T00:00:00Z
Llama-Nemotron:2.5倍速度提升的AI推理,保持准确性

Llama-Nemotron是一种高效推理模型,通过垂直压缩和FFN融合实现2.5倍速度提升,保持准确性,优化资源效率,适用于推理和数学任务。

Llama-Nemotron:2.5倍速度提升的AI推理,保持准确性

DEV Community DEV Community · 2025-05-05T13:43:38Z
组件与容器:对抗吗?

WebAssembly组件为云原生微服务部署提供了一种新方式,具有可移植性、体积小和高效通信等优势。它们支持多种编程语言,能在多种设备上运行,提升资源效率。与Kubernetes结合使用时,能够有效管理应用,避免基础设施低效。WebAssembly与容器是互补的关系。

组件与容器:对抗吗?

Cloud Native Computing Foundation Cloud Native Computing Foundation · 2025-04-09T13:30:00Z
监控重要指标:可扩展系统的实用警报设计

现代分布式系统的性能涉及速度、延迟、可用性和资源效率的平衡。有效的警报设计能帮助团队及时发现问题,避免误报。关键警报领域包括可用性、延迟、计算指标和调用量。合理设置严重性和阈值,确保警报准确,减少干扰,维护系统健康。

监控重要指标:可扩展系统的实用警报设计

DEV Community DEV Community · 2025-04-04T20:57:03Z
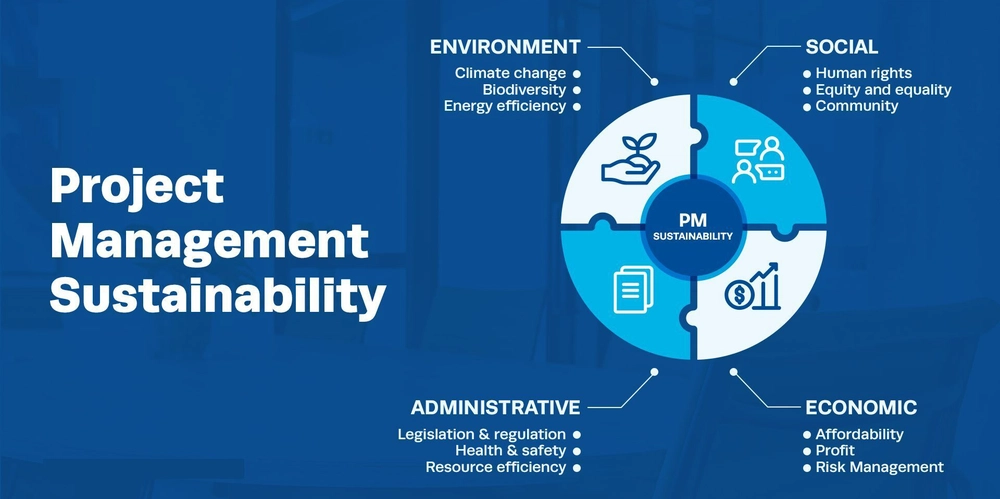
科技行业可持续项目管理的崛起

到2025年,科技行业的可持续性成为关键业务要求。可持续项目管理通过减少碳足迹、提高资源效率和增强利益相关者参与,推动积极变化。实施可持续实践的团队可实现更快的项目交付和更低的成本,其三大支柱为环境、社会和经济可持续性。新技术如AI和区块链的整合,有助于更有效地实现可持续目标。

科技行业可持续项目管理的崛起

DEV Community DEV Community · 2025-04-04T05:42:22Z

该研究提出了一种基于层次决策结构的强化学习规划方案(HAM-PPO),旨在优化精准农业中的生物胁迫管理。结果表明,该方法在作物产量恢复和资源利用效率方面显著优于传统方法。

优化精准农业中的导航和化学施用:基于深度强化学习和条件行为树的方法

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-03-23T00:00:00Z

本文探讨了基于CORDIC的激活函数设计,以满足资源受限系统的需求,促进神经网络加速。介绍的DA-VINCI激活函数为多种AI工作负载提供动态可配置和精度可调的解决方案,显著提升DNN、RNN/LSTM和Transformer的资源效率与质量,NEURIC计算单元展示了98.5%的结果质量。

A Review of Configurable Activation Functions Based on CORDIC in Neural Network Applications

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-03-18T00:00:00Z
LLM测试的演变:最佳实践与挑战

近年来,LLM测试从人工评审转向自动化方法,结合其他AI模型和合成测试数据。现代测试框架评估响应质量和资源效率,模型中心测试依赖标准基准,应用中心测试关注实际表现。有效的LLM测试需平衡这两种方法,解决输出变异和领域专业性等挑战。

LLM测试的演变:最佳实践与挑战

DEV Community DEV Community · 2025-03-05T15:44:50Z
为DeepSeek MoE模型带来「免费午餐」加速,专家链可大幅提升LLM的信息处理能力

王子涵等提出的专家链(CoE)技术通过专家间串行通信,显著提升了稀疏神经网络的性能和资源效率。CoE在降低内存需求和提高专家使用效率等方面超越了传统的专家混合模型(MoE),为大规模语言模型的高效扩展提供了新途径。

为DeepSeek MoE模型带来「免费午餐」加速,专家链可大幅提升LLM的信息处理能力

机器之心 机器之心 · 2025-03-05T02:40:09Z
利用联邦学习开发去中心化的人工智能模型

联邦学习在去中心化AI模型中提供隐私保护、资源效率和可扩展性,但面临通信开销和数据异构性等挑战。理解其特点和局限性有助于更有效地应用联邦学习。

利用联邦学习开发去中心化的人工智能模型

DEV Community DEV Community · 2025-02-27T00:40:51Z

FitLight提出了一种新颖的联邦模仿学习框架,旨在解决基于强化学习的交通信号控制方法在实际应用中的高学习成本和泛化能力差的问题。该框架支持在各种交通环境中即插即用,显著提高了控制策略的收敛速度和资源使用效率。

FitLight: Federated Imitation Learning for Plug-and-Play Autonomous Traffic Signal Control

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-02-17T00:00:00Z

本研究探讨了大型语言模型(LLM)中文本生成解码策略对GPU能耗的影响,强调了解码技术和超参数选择对文本质量和资源利用的影响,以及优化资源效率与文本质量之间的平衡。

节能意识的LLM解码:文本生成策略对GPU能耗的影响

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-02-17T00:00:00Z
介绍Fluid计算

Fluid计算是一种新型计算模型,超越无服务器架构,通过高性能迷你服务器优化资源效率,降低冷启动和计算成本。它支持实时扩展和按需计费,适用于电商和AI应用,确保计算资源靠近数据存储,提高性能和一致性,兼容Node.js和Python。

介绍Fluid计算

Vercel News Vercel News · 2025-02-04T13:00:00Z
Python支持函数内并发公测

Python现已公测函数内并发,优化多个调用的处理,提高资源效率,减少空闲计算时间和成本,特别适合外部API或数据库调用。此功能仅对Pro和Enterprise客户开放。

Python支持函数内并发公测

Vercel News Vercel News · 2025-01-14T13:00:00Z
  • <<
  • <
  • 1 (current)
  • 2
  • 3
  • >
  • >>
👤 个人中心
在公众号发送验证码完成验证
登录验证
在本设备完成一次验证即可继续使用

完成下面两步后,将自动完成登录并继续当前操作。
1 关注公众号
小红花技术领袖公众号二维码
小红花技术领袖
如果当前 App 无法识别二维码,请在微信搜索并关注该公众号
2 发送验证码
在公众号对话中发送下面 4 位验证码
小红花技术领袖俱乐部
小红花·文摘:汇聚分发优质内容
小红花技术领袖俱乐部
Copyright © 2021-
粤ICP备2022094092号-1
公众号 小红花技术领袖俱乐部公众号二维码
视频号 小红花技术领袖俱乐部视频号二维码