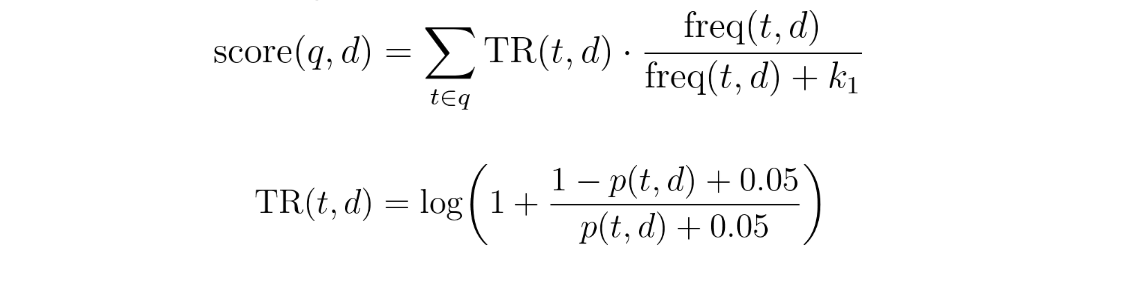Atlas Search 分页搜索时,BM25 依赖平均文档长度、文档总数、词频等语料统计,导致不同副本评分漂移,出现结果重复或遗漏。团队为此开发 StableTfl 评分函数,仅依据查询词、词频和文档长度打分,用词长估算稀有度,无需额外状态,各副本结果一致,已贡献给 Apache Lucene。在 BEIR 基准上 NDCG@10 约降 3 点(9%),适合重视一致性的分页与 RAG 场景;BM25 仍是默认选择。
本文探讨了Apache Lucene中有限状态转换器(FST)在段文件中的作用,如何通过词典快速定位倒排索引的postings。FST通过共享前缀压缩词典,减少内存占用,并支持高效查找与遍历。文章比较了Lucene的词典结构与PostgreSQL的GIN Entry Tree,强调两者在存储引擎假设上的不同,并讨论了FST的实现细节及其在查询中的应用。
OpenSearch软件基金会发布了OpenSearch 3.0,这是三年来的首次重大版本更新。新版本支持模型上下文协议、基于拉取的数据摄取和gRPC,提升了可扩展性和集成性。性能方面,3.0版本的向量搜索速度比1.3快9.5倍,并支持GPU加速和更高效的索引。同时,版本升级至Apache Lucene 10,增强了数据管理和传输功能。
Apache Lucene是一个高性能的开源文本搜索库,广泛应用于内容管理和企业搜索。尽管面临可扩展性和资金可持续性挑战,Lucene仍在不断创新,未来可能结合区块链和人工智能技术,推动搜索技术的发展。
Uber工程团队将搜索基础设施从Apache Lucene 8.0升级到9.5,提升了搜索能力和效率。新架构包含服务层和摄取层,支持实时更新和离线处理。升级后,搜索速度提高30%,CPU使用降低,基础设施成本减少。
搜索引擎通过索引和检索算法快速找到信息。Apache Lucene是一个用Java编写的开源库,是ElasticSearch和Solr的基础。Lucene的搜索技术包括查询预处理、倒排索引搜索、文档评分和结果排序。查询经过分词、标准化、去除停用词和词干提取,然后根据TF-IDF权重检索相关文档,并按得分排序显示最相关结果。
Elastic 8.13 正式发布,主要亮点包括:可观测性 AI 助手正式支持 Amazon Bedrock;新增向量搜索配置并正式发布同义词 API;Logstash 新增集成过滤插件;Elasticsearch 扩展相关性工具包,预览 Learning to Rank 及 Cohere 集成;可观测性方面预览 ES|QL 查询编辑与可视化,SLO 增强正式发布;平台层面正式发布解析集群 API、支持 Kafka 的 Elastic Agent,并升级至 Apache Lucene 9.10。
Apache Lucene 9.7发布,通过SIMD支持Java 20和Java 21提高性能,允许并行执行kNN查询。修复错误、优化和改进。新功能包括IndexWriter updateDocuments函数可同时更新多个匹配文档,函数查询可计算kNN向量相似度分数,KNN索引和查询可利用向量化计算距离,使用执行器创建的IndexSearcher可并发运行KNN查询,按字段排序的查询可动态修剪命中,减少计算软删除数量的合并时间开销。
完成下面两步后,将自动完成登录并继续当前操作。