

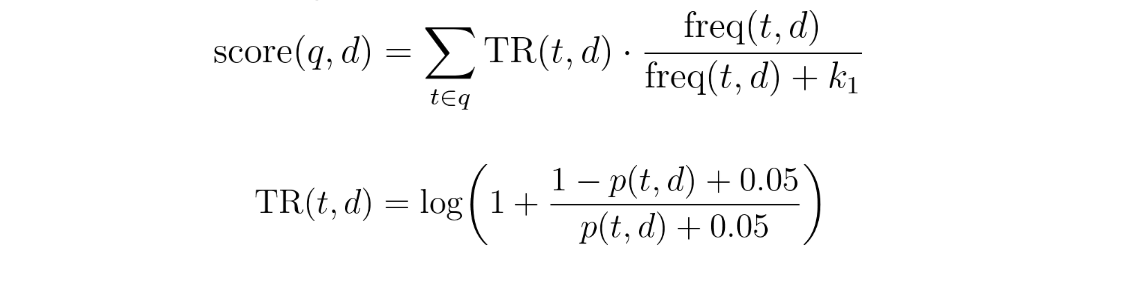

同一查询,同一评分:Atlas Search 中使用 StableTfl 实现一致排序
内容提要
Atlas Search 分页搜索时,BM25 依赖平均文档长度、文档总数、词频等语料统计,导致不同副本评分漂移,出现结果重复或遗漏。团队为此开发 StableTfl 评分函数,仅依据查询词、词频和文档长度打分,用词长估算稀有度,无需额外状态,各副本结果一致,已贡献给 Apache Lucene。在 BEIR 基准上 NDCG@10 约降 3 点(9%),适合重视一致性的分页与 RAG 场景;BM25 仍是默认选择。
延伸解读
分页重复与遗漏的根源
文章指出,BM25 评分依赖平均文档长度、文档总数和词频等语料统计,而分布式副本各自索引、统计值会漂移。同一查询在不同副本上可能给文档打出不同分数,导致跨页边界时排名互换,出现重复或遗漏。这不是副本故障,而是评分函数假设单一固定语料与分布式环境无法提供该语料之间的矛盾。
StableTfl 如何实现无状态一致
StableTfl 只使用查询词、词频和文档长度三个输入,完全移除语料统计。它用词长估算稀有度,依据 Zipf 短词常见、长词罕见的规律,并用文档长度归一化词频。因此同一文档在任何副本、任何时刻得分相同,无需粘性路由或索引快照等额外状态。该函数已贡献给 Apache Lucene,可作为无状态 Similarity 直接替换。
一致性换来的相关性代价
在 BEIR 的 21 个数据集上,StableTfl 的 NDCG@10 平均为 0.315,BM25 为 0.346,相对下降约 9%;Recall@10 也从 0.388 降至 0.350。文章明确,BM25 仍是默认选择,适合追求原始相关性的场景;StableTfl 适合多副本分页、RAG 或混合检索等更看重结果可复现、稳定评分的部署。
语言与调参限制
StableTfl 的常数基于英文文本拟合,其他拉丁字母语言可能需要重新拟合。对于中文、日文等词常为单字符的语言,词长代理稀有度的假设完全失效。此外,分析器中的词干提取会缩短词元,影响稀有度校准。文章建议未来可针对特定语言或生物医学、法律等专业领域重新拟合常数,以缩小质量差距。
Q&A
Atlas Search 分页时为什么会出现重复或遗漏结果?
因为 BM25 评分依赖语料统计(平均文档长度、文档总数、词频等),而不同副本的统计会因索引进度不同而漂移,导致同一查询在不同副本上排序不一致,从而在分页边界产生重复或遗漏。
StableTfl 是什么?它如何保证不同副本评分一致?
StableTfl 是 Atlas Search 团队开发的一种评分函数,仅依据查询词、词频和文档长度打分,不使用任何语料统计,因此同一文档在任何副本上得分相同,排序一致。
StableTfl 与 BM25 在评分机制上有什么主要区别?
BM25 使用逆文档频率(IDF)衡量词稀有度,依赖语料统计;StableTfl 则用词长估算稀有度(基于 Zipf brevity law),仅依赖文档本身信息,无需语料统计。
使用 StableTfl 会损失多少检索质量?
在 BEIR 基准的 21 个数据集上,StableTfl 的平均 NDCG@10 为 0.315,BM25 为 0.346,相对下降约 9%(约 3 个点)。
StableTfl 适合哪些应用场景?
适合重视一致性的场景,如多副本部署的分页搜索、需要可复现检索的 RAG 和混合管道,以及下游逻辑依赖稳定分数的系统。BM25 仍是默认选择,当原始相关性优先时使用。
StableTfl 有哪些局限性?
其常数基于英文文本拟合,其他拉丁语系语言可能需要重新拟合;对于中文、日文等单字成词的语言,词长代理完全失效。此外,检索质量相比 BM25 有约 3 个点的 NDCG 下降。
