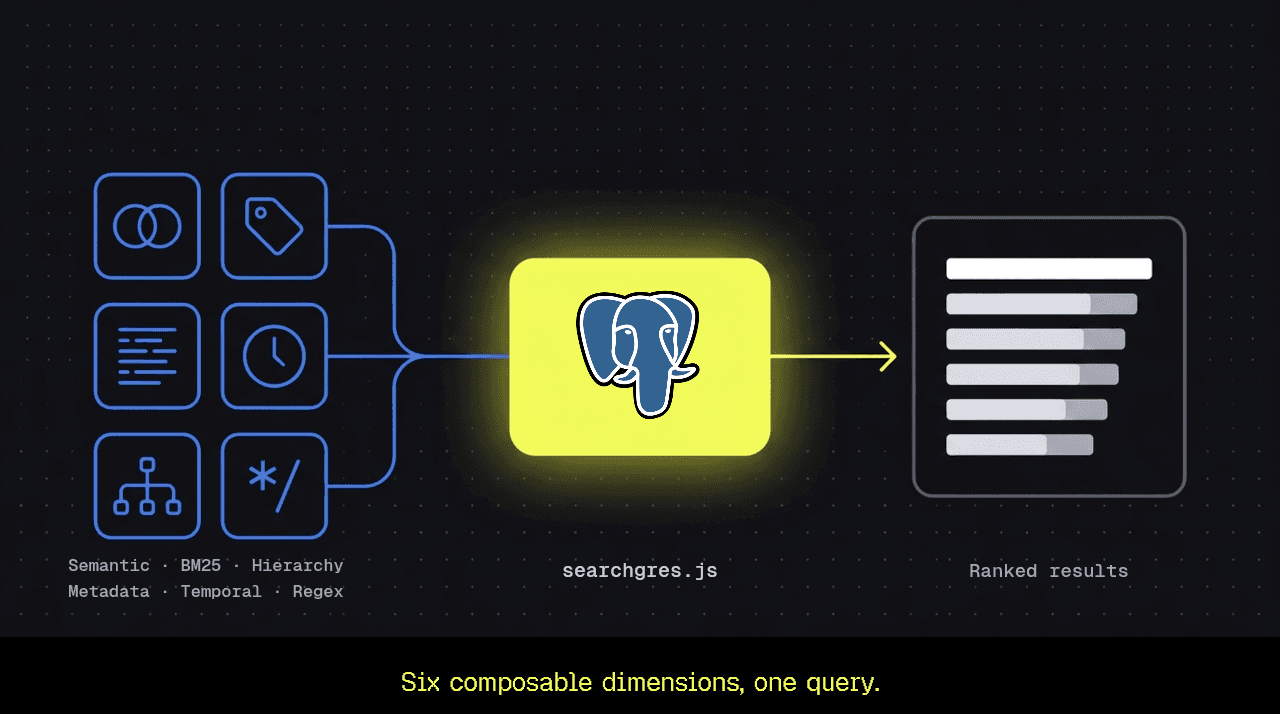
searchgres.js 是一个采用 Apache-2.0 许可的开源 TypeScript 库,用于在 PostgreSQL 中实现可组合搜索。它支持在单条 Postgres 查询中组合 BM25 关键词检索、语义排序,以及按层级、元数据和时间过滤,从而简化混合搜索的实现。
Qdrant 1.20 发布,主要更新包括:全文索引支持 BM25 评分,无需生成嵌入向量,统计自动从数据推导;新增代码分词器,按大小写和下划线拆分标识符,提升代码搜索效果;新增逐元素嵌套索引,嵌套过滤速度提升 7 至 38 倍;新增 turbo16 和 turbo8 数据类型,分别以 16 位和 8 位存储向量,turbo16 精度无损且搜索更快,turbo8 召回接近 float16;内存分层扩展至 ID 跟踪器,内联存储不再重复保存向量;集群安全加固,内部 API 默认要求认证,内部端口可绑定私有网络。
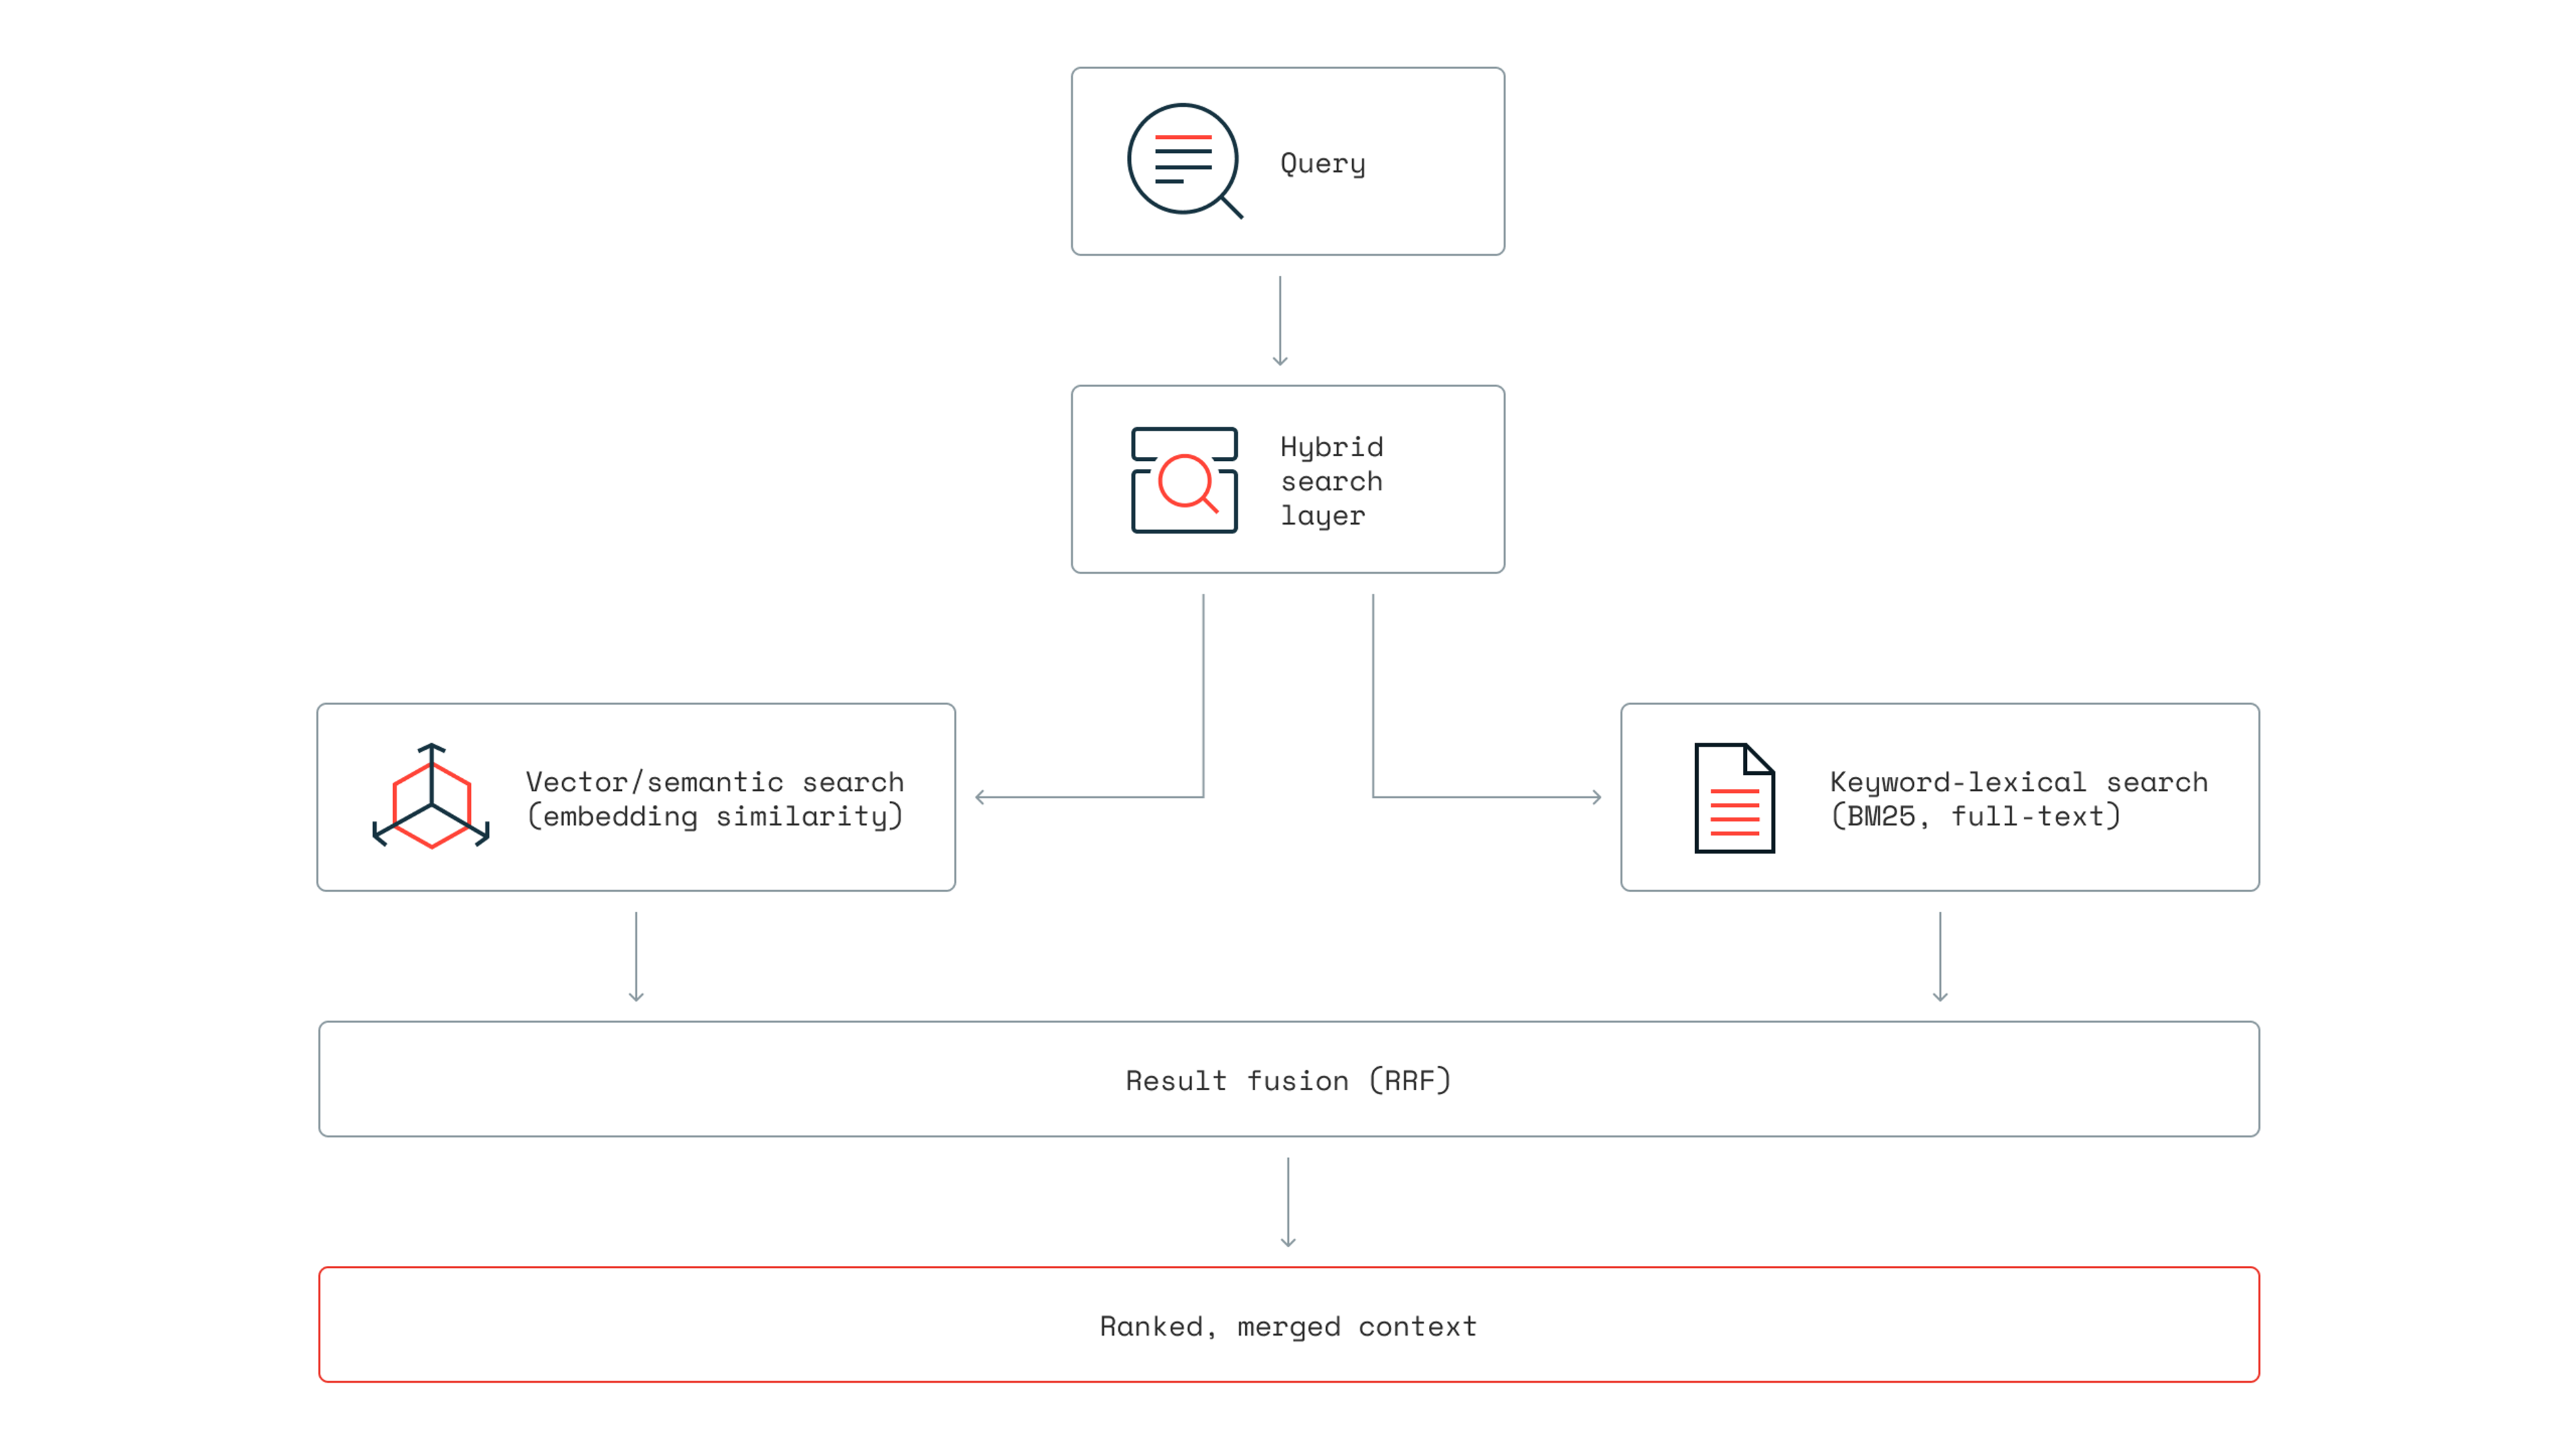
该课程介绍如何在 PostgreSQL 内构建生产级混合搜索,无需 Elasticsearch 等外部集群。它结合关键词匹配与向量语义检索,用 RRF 在 SQL 中合并排序结果,并以 24 万篇维基百科文章为例,演示 BM25 排序、pgvector 存储 384 维嵌入、查询计划分析,以及 Python、FastAPI 和 Psycopg 后端实现。
Databricks 内部应用 Slide Hub 基于 Lakebase Postgres 实现混合搜索,结合向量检索与 BM25 关键词检索,无需独立搜索系统。基准测试显示:8 CU 以下时数据库为瓶颈,8 CU 以上时应用为瓶颈;缓存与索引比例决定命中率,接近 1.0 时延迟稳定。建议索引用 quality 模式、候选数设为 200,生产环境最小 0.5 CU 以避免冷启动。
本文介绍Postgres全文搜索的倒排索引原理:以词项为键映射到文档ID的倒排列表,支持并集、交集快速查询;包含词项字典、倒排列表及可选的位置和词频数据,用于短语查询和BM25评分;索引通过分词、词干化、停用词处理构建,采用分段存储、合并和墓碑机制应对增删改;在Postgres中需处理ctid、WAL、VACUUM、事务可见性及查询规划等集成问题。
团队发布了Postgres全文搜索扩展Lead,其功能与TIN相同,兼容SQL和TINQL查询,支持索引写入、ACID、快照隔离、持久化、BM25评分和高亮。但Lead速度慢,每次搜索都全表扫描,仅适合CI中小型表测试,生产环境仍应使用TIN。
本文介绍从零实现GeekAgent第14天,构建轻量RAG知识库。通过`rag_add`采集网页或文件,按800字切块存入JSON;`rag_search`用BM25检索相关段落,最多返回四块。复用Day13的切块与搜索函数,实现“先查资料再回答”,支持`/rag`命令管理,适合少量文档场景。
本文介绍GeekAgent第13天实现“主动记忆”功能:在每轮对话前自动检索长期记忆,无需模型主动调用搜索工具。实现方法包括将长记忆按320字窗口、80字重叠切块,用BM25算法排序,并将命中结果拼入系统提示。相比手动搜索,自动唤起更早介入,提升记忆利用率。
本文介绍LLM Wiki在企业合规知识问答中的实践,面临三道坎:并发编译导致38%页面重复,通过串行规划解决;目录摘要有损压缩导致查询遗漏,用BM25全文检索补充,命中率从70%提升至92.7%;人工修正被重编译覆盖,用语义pin保存修正意图。最终强调LLM Wiki适合少而精的知识,非RAG替代品。
Qdrant 1.19 推出 turbo4 数据类型,将稠密向量以每维 4 位存于磁盘,存储降至 float32 的八分之一,召回率仅小幅下降。教程以宠物用品搜索为例,用 ColBERT 多向量存为 turbo4,配合 BM25 稀疏向量:先用 BM25 预取候选,再用 ColBERT 后期交互重排,兼顾速度与精度。
该论文评估了不同检索增强生成范式在企业级语料规模扩展下的性能。实验发现,当语料超过约1000万token时,BM25检索器优于密集向量检索和文件系统代理。文件代理在小规模下表现略好,但随着规模增大,因候选发现能力不足而失效。结合BM25候选发现的Agent方法效果最佳。图RAG方法因建库成本过高或准确率低而失败。结论是BM25负责全局候选排序,Agent负责在缩小后的范围内推理。
pgEdge ColdFront新增混合搜索功能,在PostgreSQL内结合密集向量与BM25稀疏向量,通过RRF融合结果。支持精确术语匹配和概念查询,可调p_alpha平衡权重。在pgEdge集群中,嵌入自动复制,实现高可用搜索,降低存储成本。
本文讨论了BM25算法在全文检索中的应用,分析了其公式、参数及与TF-IDF的区别。BM25通过饱和TF和长度归一解决了传统TF在长文档中的失效问题,并提及了Lucene和Elasticsearch的实现细节,强调了BM25在召回和可解释性方面的重要性。此外,文章探讨了BM25与学习排序的关系及其在实际应用中的工程边界。
本文讨论了在Elasticsearch和Lucene中结合稀疏BM25与稠密kNN进行混合检索的策略,重点分析了两种索引的共存、查询策略及其对性能的影响。混合检索需同时利用BM25和kNN信号,以确保候选文档的一致性和可比性。文章还探讨了写入路径、代价模型及与专用向量引擎的边界问题,强调了统一Segment生命周期的重要性。
本文探讨了全文检索引擎的架构,重点分析了Lucene和Elasticsearch的设计与实现,包括倒排索引、文档模型、分析链、BM25打分机制和近实时刷新等关键概念,适合搜索引擎工程师和研究生深入理解搜索系统的内部运作。
本文介绍了在RAG系统中实现混合语义-词汇搜索的方法,结合BM25词汇搜索与语义搜索,通过互惠排名融合(RRF)进行整合。混合搜索策略有效提升了检索效果,提供了Python实现的详细步骤,包括库的安装、数据集加载、BM25和语义搜索的独立执行及结果融合。通过示例查询,展示了混合搜索的优势。
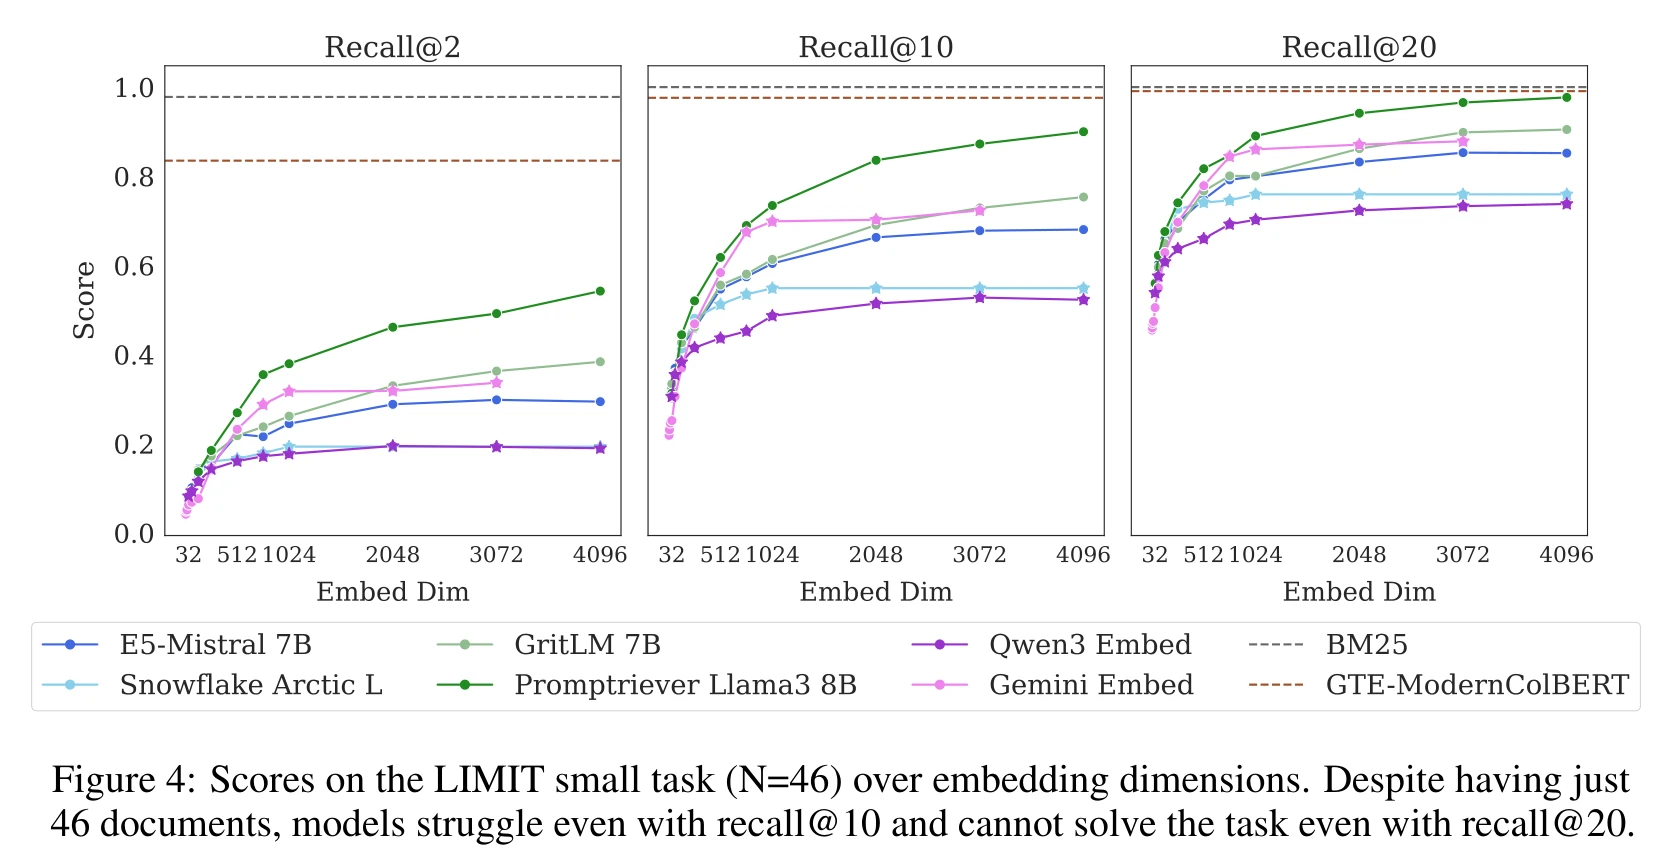
这篇文章探讨了向量检索的理论极限,指出在高维嵌入中,单向量模型无法有效表示所有检索结果。研究表明,查询复杂度增加时,单向量模型表现显著下降,无法满足高风险领域需求。文章建议结合BM25和密集检索,以弥补不足,并强调多向量模型和交叉编码器的重要性。
向量检索在RAG系统中应用广泛,但存在理论限制。研究显示,单向量模型在复杂查询时维度不足,表现不佳。BM25在词汇匹配中表现优异,但在语义匹配上不如向量模型。为提高检索效果,结合BM25与向量检索或采用Cross-encoder等多向量模型是必要的。
混合搜索结合了BM25和向量检索,克服了纯向量和关键词搜索的不足,提升了检索准确性,适用于技术文档及法律医疗领域。通过双路径处理,优化查询结果,降低LLM成本,提高上下文质量。Redis支持混合搜索,简化操作,适合构建RAG系统和智能代理。
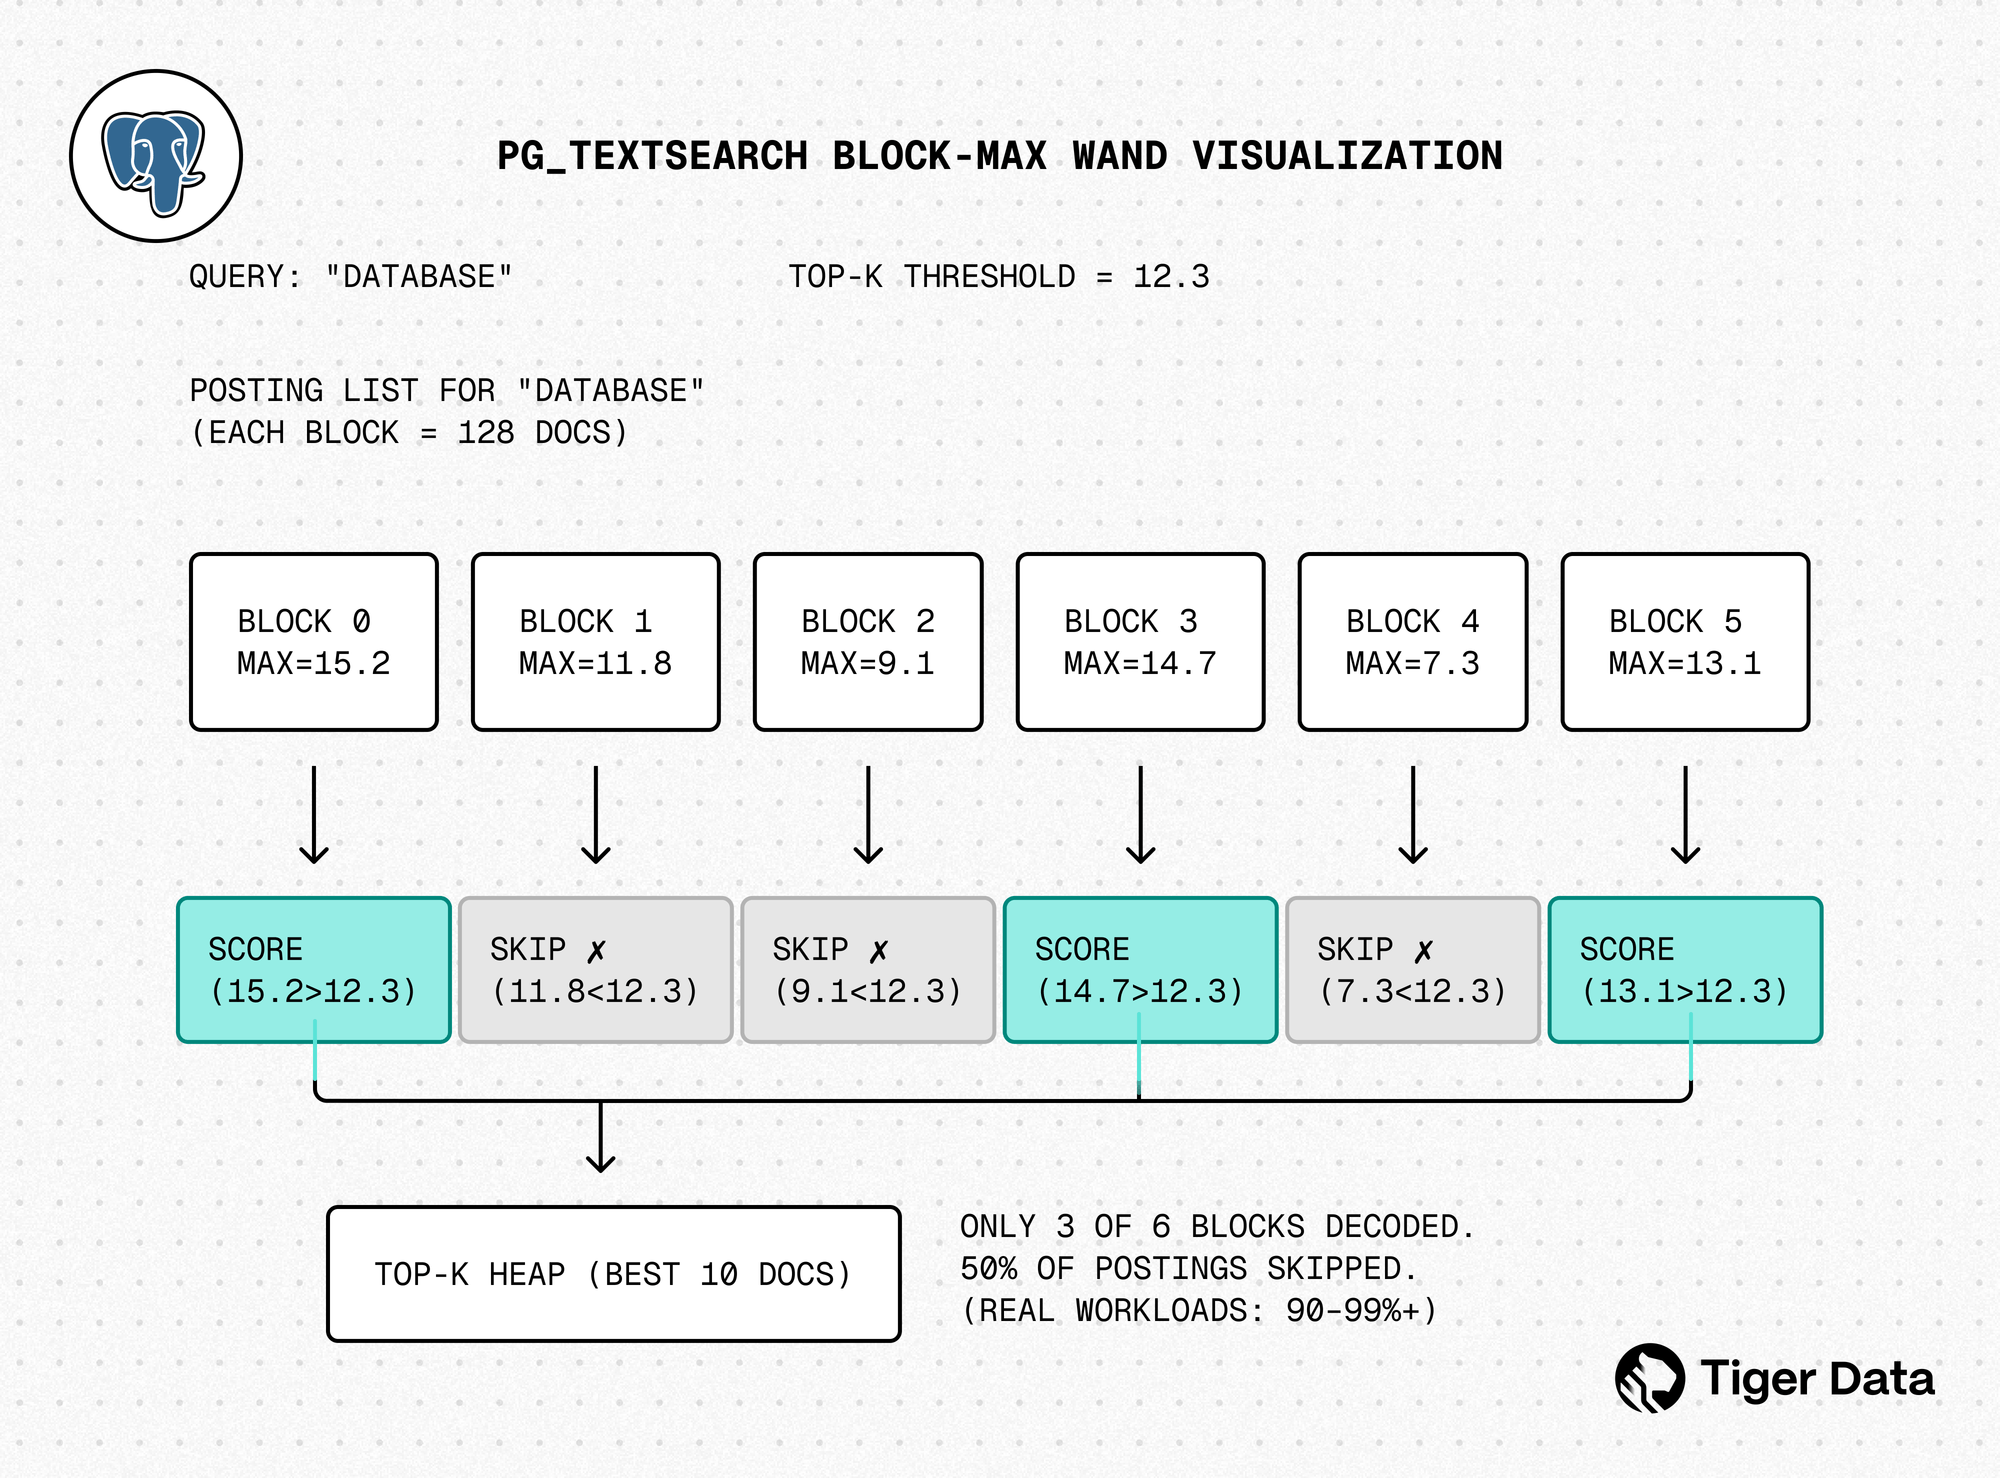
pg_textsearch是基于Postgres的BM25索引扩展,提供高效的全文搜索。它通过内存中的反向索引和块最大WAND算法优化查询速度,支持快速排名和并行构建索引。与ParadeDB相比,pg_textsearch在短查询上表现更佳,索引大小更小,但不支持短语查询和模糊匹配。
完成下面两步后,将自动完成登录并继续当前操作。