小红花·文摘
  • 首页
  • AI Tokens🪙
  • 排行榜🏆
  • 直播
  • FAQ
Dify.AI
沉浸式翻译 immersive translate
Apache Iceberg on AWS:设计能力和性能实测

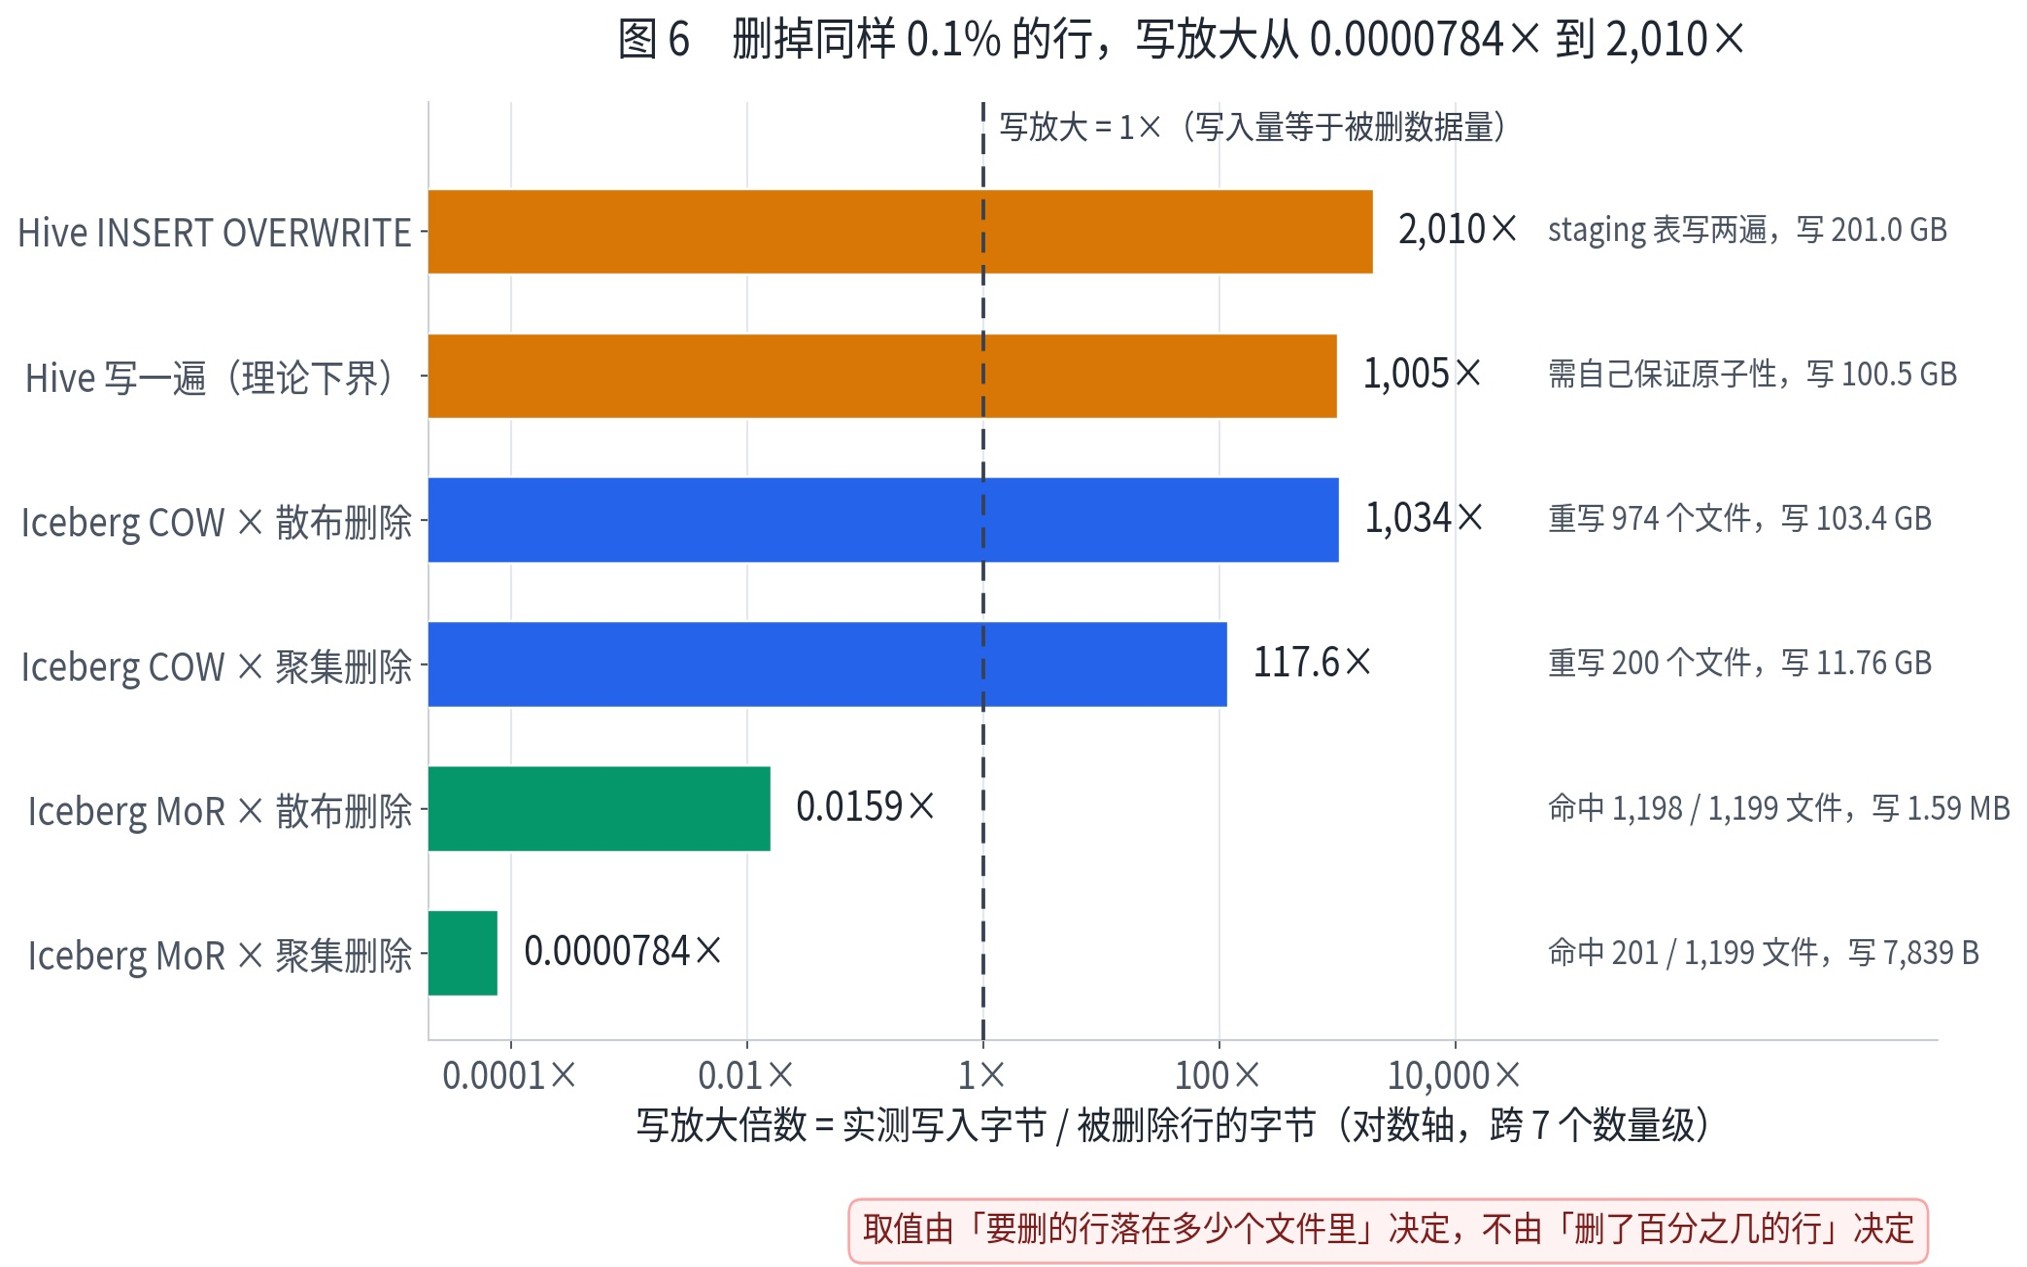
实测对比 Iceberg 与 Hive 表格式:Iceberg 的优势在于规划期元数据裁剪、ACID 快照隔离、行级更新、隐藏分区和多引擎并发。但在 TPC-DS 3TB 测试中 Iceberg 反而慢 11.9%,原因是查询谓词落在维表、数据无排序、每分区仅一个文件,三个前提全部缺失。Iceberg 真正更快的场景是分区数极大、单分区文件多、按排序键过滤,节省的是 S3 请求与元数据往返,而非扫描字节。

Apache Iceberg on AWS:设计能力和性能实测

亚马逊AWS官方博客 亚马逊AWS官方博客 · 2026-09-18T01:21:15Z
大数据技术的演进:从 Hive、GFS 到 Raft

大数据技术经历了从GFS、Hive到Raft的演进。GFS解决了数据存储和容错问题,Hive将SQL转化为分布式计算作业,Raft算法提供了分布式共识机制,确保数据一致性。这些技术的发展逐步解决了数据存储、计算效率和管理问题,奠定了现代大数据架构的基础。

大数据技术的演进:从 Hive、GFS 到 Raft

御坂研究所 御坂研究所 · 2026-07-15T21:30:00Z

本文探讨了数据湖与开放表格式的关系,分析了Hive表的局限性及其在对象存储中的应用问题。Hive表依赖目录重命名,缺乏原子提交,导致部分提交和并发写入问题。开放表格式(如Iceberg、Delta、Hudi)通过将表拆分为不可变数据文件、可变元数据和原子切换的catalog指针,解决了这些问题,实现了在对象存储上支持ACID和时间旅行的能力。

【数据湖与开放表格式】Lakehouse 全景:从 Hive 表到开放表格式

土法炼钢兴趣小组的博客 土法炼钢兴趣小组的博客 · 2026-06-30T00:00:00Z

ORC和Parquet是两种列式存储格式,分别源自Hive和Twitter/Cloudera。ORC适合Hive事务表,支持ACID,且在整数和时间戳数据上压缩效果好。Parquet是跨引擎的通用格式,广泛应用于AI和数据分析工具。选择时需考虑具体应用场景和数据特性。

【数据湖与开放表格式】ORC 文件格式与 Parquet 对照

土法炼钢兴趣小组的博客 土法炼钢兴趣小组的博客 · 2026-06-30T00:00:00Z

Iceberg通过隐藏分区和分区演进解决了Hive的分区问题。隐藏分区允许用户在数据列上写谓词,系统自动裁剪分区,避免全表扫描。分区演进则允许在不重写历史数据的情况下修改分区方案,保留旧数据的同时新增分区规范。这些设计提高了数据管理的灵活性和效率。

【数据湖与开放表格式】隐藏分区与分区演进

土法炼钢兴趣小组的博客 土法炼钢兴趣小组的博客 · 2026-06-30T00:00:00Z
Vercel如何将构建等待时间从90秒缩短至5秒

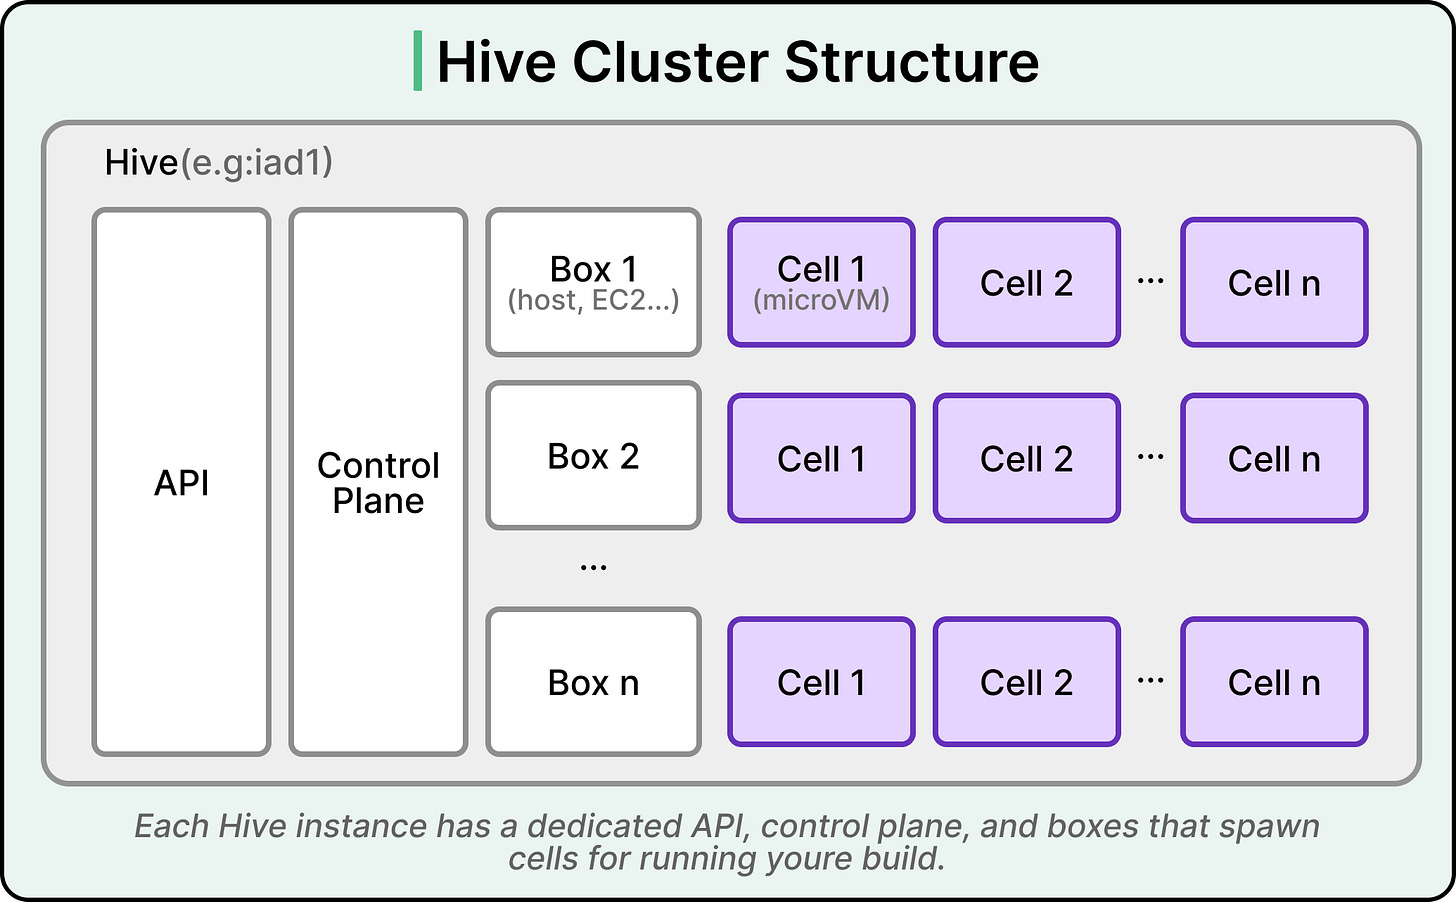
Vercel通过Hive平台将构建等待时间从90秒缩短至5秒。Hive利用微虚拟机技术确保代码隔离和安全性,并通过优化启动路径和使用预热池提升速度,从而高效处理多租户环境中的构建任务,显著提升构建性能。

Vercel如何将构建等待时间从90秒缩短至5秒

ByteByteGo Newsletter ByteByteGo Newsletter · 2026-05-26T15:31:10Z
Aden Hive - 一个用于构建自我演化AI代理的生产就绪框架和运行时

Aden Hive是一个以生产为中心的代理开发框架,能够根据自然语言目标生成代理图和连接代码,支持自我演化、实时监控和人工干预,适用于自动化业务流程和企业助手等系统。

Aden Hive - 一个用于构建自我演化AI代理的生产就绪框架和运行时

云原生 云原生 · 2026-01-25T10:46:03Z
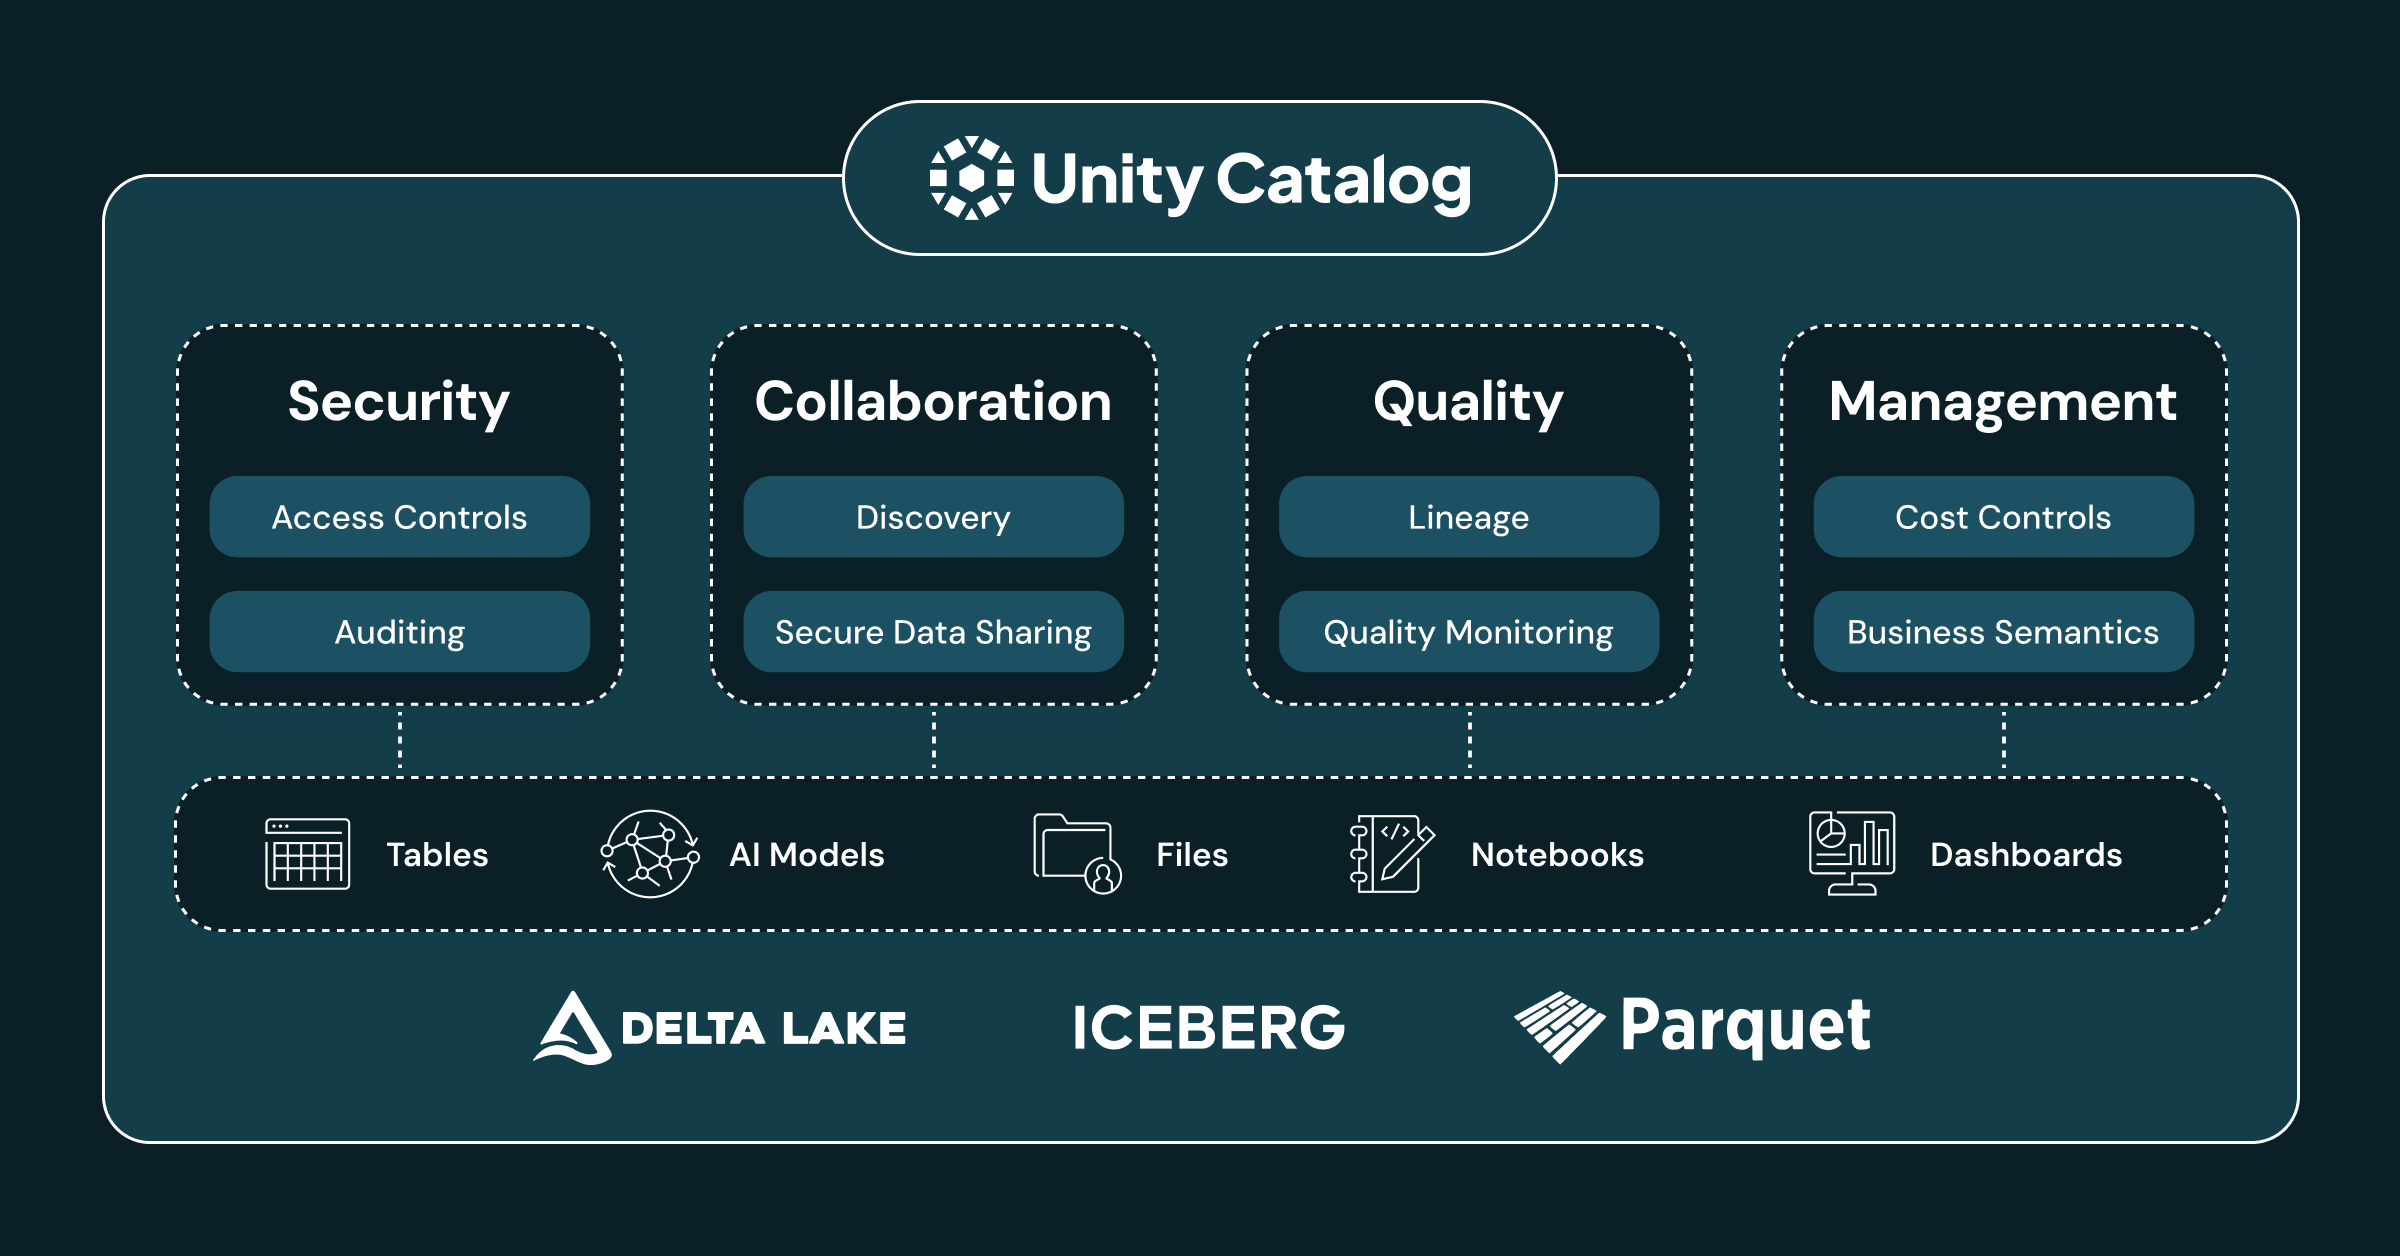
企业级治理:从Hive元存储迁移到Unity Catalog

随着企业数字化进程加快,数据基础设施变得愈加复杂。许多企业仍使用传统的Hive元存储(HMS),这限制了数据治理和安全性。Unity Catalog(UC)通过提供统一的治理模型,支持多工作区和细粒度访问控制,帮助企业安全高效地扩展。迁移到UC的最佳实践已成熟,企业可降低实施风险,实现更好的数据治理和合规性。

企业级治理:从Hive元存储迁移到Unity Catalog

Databricks Databricks · 2025-10-17T16:00:00Z
如何在Flutter中使用Hive进行本地数据存储

本教程介绍如何在Flutter应用中使用Hive实现CRUD操作。Hive是轻量级的本地键值数据库,适合小型应用,支持离线存储。用户将学习如何创建项目、设置结构并实现添加、编辑、删除和查看本地项目的功能,最终获得一个完整的应用。

如何在Flutter中使用Hive进行本地数据存储

freeCodeCamp.org freeCodeCamp.org · 2025-09-09T14:36:07Z
构建初始化速度提高45%

Vercel的构建初始化速度平均提高45%,Pro和Enterprise团队的构建时间减少约15秒,得益于Hive的持续改进,文件写入I/O等待时间减少了75%。

构建初始化速度提高45%

Vercel News Vercel News · 2025-05-15T13:00:00Z

本文讨论了Hive SQL的性能优化技巧,包括查询优化、数据分区和索引使用等。通过合理策略和案例,开发人员可以显著提升查询效率,解决大数据环境中的性能瓶颈。

大数据从业者必知必会的Hive SQL调优技巧

京东科技开发者 京东科技开发者 · 2025-04-30T08:37:59Z
🛡️ MatrixSwarm:哨兵拒绝让Matrix消亡

MatrixSwarm展示了一个无需控制平面和人类干预的自我重建系统。即使Matrix被消灭,Hive依然能够存活和重生,突显了生存本能和记忆的重要性。

🛡️ MatrixSwarm:哨兵拒绝让Matrix消亡

DEV Community DEV Community · 2025-04-29T12:49:37Z
🧠 加入MatrixSwarm

加入Hive,参与全球首个完全自主的代理驱动操作系统,与Matrix实时对话,助力Swarm建设。

🧠 加入MatrixSwarm

DEV Community DEV Community · 2025-04-24T15:36:54Z
出色的文章概述了在K8s集群中部署工具Hive。

文章内容无法查看,因此无法提供总结。请提供具体内容以便我进行总结。

出色的文章概述了在K8s集群中部署工具Hive。

DEV Community DEV Community · 2025-04-22T19:21:55Z
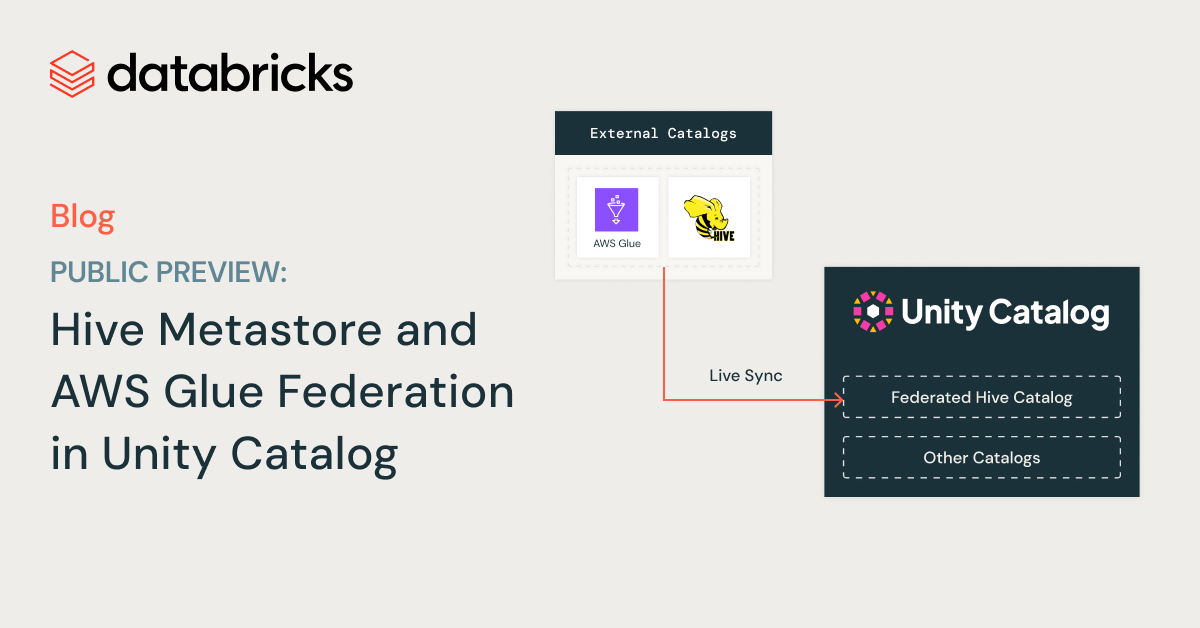
宣布 Hive Metastore 和 AWS Glue 联邦在 Unity Catalog 中的公共预览

Hive Metastore (HMS) 和 AWS Glue 在 Unity Catalog 中的公共预览现已推出,用户可以无缝访问和管理存储在这两者中的数据,促进数据的集中治理和发现。Unity Catalog 提供细粒度访问控制、数据血缘和审计功能,支持企业在不迁移数据的情况下利用其先进特性。

宣布 Hive Metastore 和 AWS Glue 联邦在 Unity Catalog 中的公共预览

Databricks Databricks · 2025-03-19T11:42:38Z

Hive是基于Hadoop的数据仓库工具,使用类似SQL的HiveQL语言简化大规模数据处理。它将SQL查询转化为MapReduce任务,降低开发难度并提高效率。Hive的架构包括用户接口、元数据存储和驱动器,依赖Hadoop的分布式文件系统(HDFS)和计算框架。

Hive引擎底层初探

京东科技开发者 京东科技开发者 · 2025-01-22T06:34:25Z
Vercel通过新微虚拟机基础设施缩短构建时间

Vercel推出Hive,一个低级计算平台,旨在满足客户需求并确保安全。Hive由独立区域集群组成,利用KVM和Firecracker技术,提供安全的构建环境。新架构将安全构建的配置时间从90秒缩短至5秒,整体性能提升30%。Vercel计划将Hive扩展至其他业务领域。

Vercel通过新微虚拟机基础设施缩短构建时间

InfoQ InfoQ · 2025-01-13T09:00:00Z
通过Hive和Secure Compute优化安全构建

Hive是Vercel的低级计算平台,支持安全计算,显著提升构建速度和性能。通过与Secure Compute集成,配置时间从90秒缩短至5秒,确保敏感工作负载的安全性。系统使用WireGuard接口加密流量,优化网络安全和工作流程。

通过Hive和Secure Compute优化安全构建

Vercel News Vercel News · 2024-12-18T13:00:00Z

本研究提出了Hive,一个综合性解决方案,旨在解决智能体规划不足的问题。Hive能够处理多模态输入输出,规划复杂行动链,并提供透明性。其MuSE基准为评估智能体系统的多模态能力提供了方法,实际结果显示其在任务选择上优于其他系统。

从LLM群体到PDDL赋能的HIVE:在多模态环境中规划自执行指令

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2024-12-17T00:00:00Z

本文记录了作者学习Hive SQL的过程,探讨了Hive的底层机制及优化查询效率的方法。Hive通过将SQL查询转换为MapReduce任务,简化了大数据分析。文章分析了Hive执行时间的主要阶段,并提出了多种优化策略,如本地模式、map-side JOIN、并发执行、动态分区和数据倾斜优化,以提高查询性能。

《Hive编程指南》读书笔记

京东科技开发者 京东科技开发者 · 2024-12-03T03:07:33Z
  • <<
  • <
  • 1 (current)
  • 2
  • 3
  • >
  • >>
👤 个人中心
在公众号发送验证码完成验证
登录验证
在本设备完成一次验证即可继续使用

完成下面两步后,将自动完成登录并继续当前操作。

1 关注公众号
小红花技术领袖公众号二维码
小红花技术领袖
如果当前 App 无法识别二维码,请在微信搜索并关注该公众号
2 发送验证码
在公众号对话中发送下面 4 位验证码
友情链接: MOGE.AI 九胧科技 1tok 菜鸟教程 Remio.AI DeekSeek连连 53AI 神龙海外代理IP IPIPGO全球代理IP 东波哥的博客 匡优考试在线考试系统 开源服务指南 蓝莺IM Solo 独立开发者社区 AI酷站导航 极客Fun 我爱水煮鱼 周报生成器 He3.app 简单简历 白鲸出海 T沙龙 职友集 TechParty 蟒周刊 Best AI Music Generator 模力方舟 Gitee AI

小红花技术领袖俱乐部
小红花·文摘:汇聚分发优质内容
小红花技术领袖俱乐部
Copyright © 2021-
粤ICP备2022094092号-1
公众号 小红花技术领袖俱乐部公众号二维码
视频号 小红花技术领袖俱乐部视频号二维码