
Apache Iceberg on AWS:设计能力和性能实测
内容提要
实测对比 Iceberg 与 Hive 表格式:Iceberg 的优势在于规划期元数据裁剪、ACID 快照隔离、行级更新、隐藏分区和多引擎并发。但在 TPC-DS 3TB 测试中 Iceberg 反而慢 11.9%,原因是查询谓词落在维表、数据无排序、每分区仅一个文件,三个前提全部缺失。Iceberg 真正更快的场景是分区数极大、单分区文件多、按排序键过滤,节省的是 S3 请求与元数据往返,而非扫描字节。
延伸解读
性能测试的边界条件
TPC-DS 3TB 测试中 Iceberg 比 Hive 慢 11.9%,这一结果有明确的适用边界。测试数据每分区仅约 1 个文件、无排序、查询谓词落在维表,导致 Iceberg 的元数据裁剪优势完全无法发挥。若你的表分区数极大、单分区文件多、且按排序键过滤,Iceberg 的规划期优势会显著体现。因此不能将本次结果直接推广为 Iceberg 普遍更慢。
规划期优势的触发条件
Iceberg 的规划期优势依赖三个前提:查询谓词在规划期可求值、表有排序使列界统计有效、每分区文件数远大于 1。三者缺一,元数据裁剪收益为零,但规划期开销仍在。实测中 Iceberg 规划期比 Hive 慢 33.3%,正是因为三个前提全部缺失。评估是否采用 Iceberg 时,应先检查自己的数据布局是否满足这些条件。
成本节省的真实来源
Iceberg 节省的是 S3 请求与元数据往返,而非扫描字节。在排序场景下,规划期选中字节减少 79%,但执行期 Hive 通过 Parquet row group 统计也能过滤,实际执行期差距仅 1.29 倍。下推的 count(*) 请求数减少 98.1%,节省的是 footer 读的 GET 请求。若关注扫描字节,zstd 压缩比 snappy 落盘小 23.6%,这是独立于表格式的真实节省。
行级删除的写放大差异
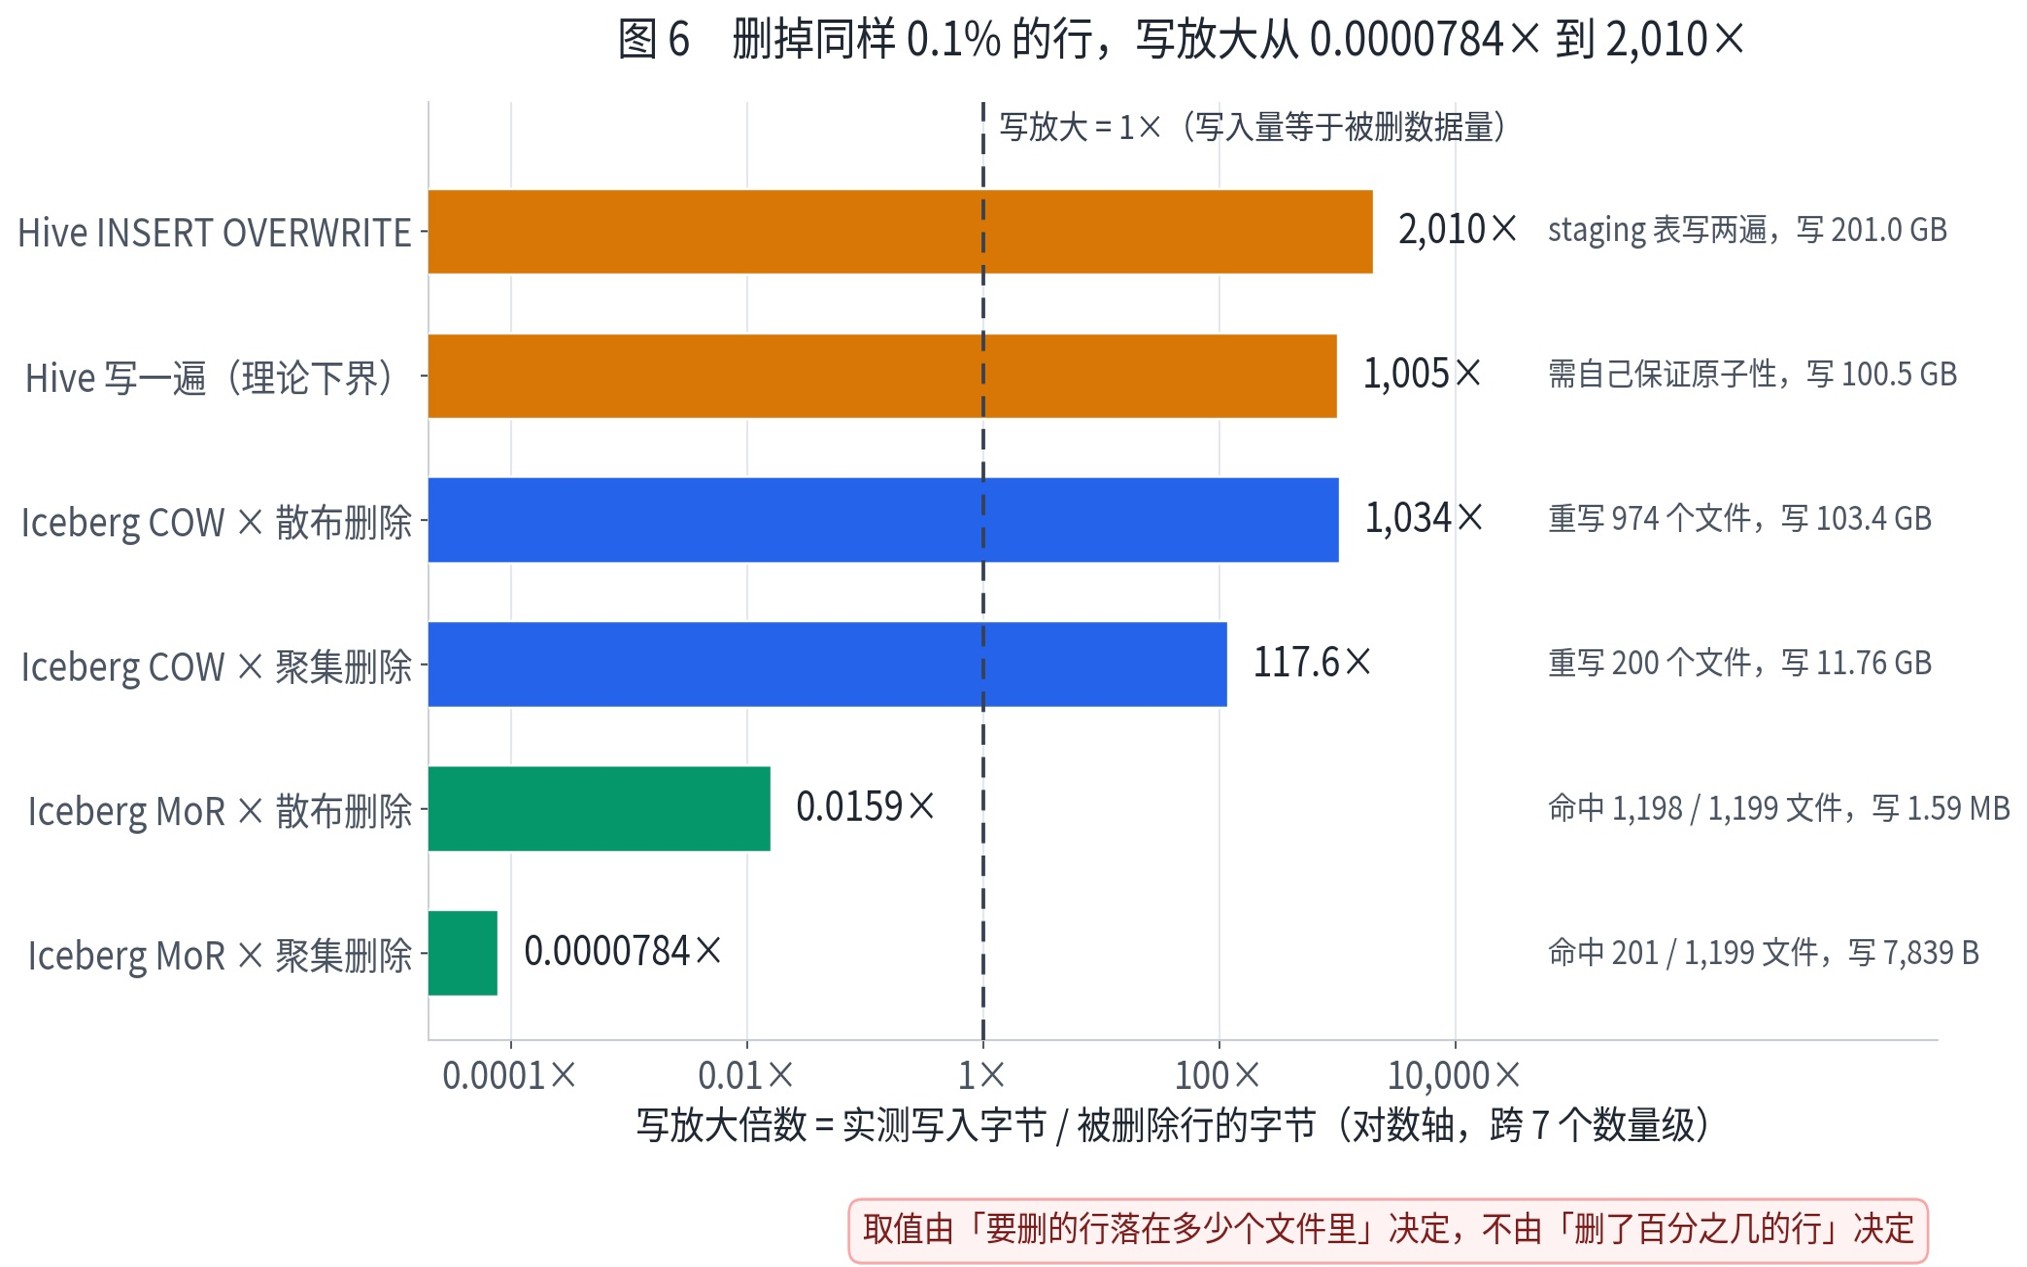
行级删除的写放大由目标行命中的文件数决定,而非删除行数占比。实测删除 0.1% 的行,散布形态下 CoW 写放大 1034 倍,比 Hive 理论下界 1005 倍还差;聚集形态下 CoW 仅 117.6 倍,MoR 可低至 0.0000784 倍。选择 CoW 还是 MoR 前,应先用 SELECT count(*) FROM (SELECT DISTINCT _file FROM t WHERE <谓词>) 量出命中文件数。
Q&A
Iceberg 表相比 Hive 表在查询规划阶段有哪些核心优势?
Iceberg 在规划阶段通过元数据树实现两级裁剪:一级过滤排除整批 manifest,二级过滤排除单个数据文件,且规划期零次 S3 LIST,文件路径已写在 manifest 中。而 Hive 表需要依赖 metastore 和文件系统两处信息,规划成本随命中分区数和分区内文件数线性增长。
在 TPC-DS 3TB 测试中,为什么 Iceberg 反而比 Hive 慢 11.9%?
因为 Iceberg 元数据裁剪依赖的三个前提全部缺失:查询谓词落在维表而非分区列、表没有 sort order 导致列界统计无效、每个分区仅约 1 个文件使细粒度裁剪无收益。规划期开销增加 33.3%,但未换回任何过滤收益。
Iceberg 在什么条件下会比 Hive 更快?
当分区数极大(如 10 万分区)、单分区内文件数很多(如 10 万文件)、或按排序键过滤时,Iceberg 规划期优势显著。例如命中 10 万分区时 Iceberg 规划耗时 582 ms,Hive 无索引需 129,213 ms,快 237.6 倍。
Iceberg 的行级删除如何减少写放大?
Iceberg 提供 MoR 和 CoW 两种方式。MoR 只写 delete file,写放大字节约等于变更行数乘以 delete 记录字节,实测删除 95.34 MiB 数据仅写 7,839 字节;CoW 重写命中的数据文件,写放大取决于命中文件数,聚集删除时写放大 117.6 倍,散布删除时 1,034 倍。
Iceberg 的隐藏分区如何解决 BI 工具生成 SQL 时的分区列不匹配问题?
Iceberg 通过 transform 从列值推导分区值,并将推导关系存在 partition spec 中。读取时谓词自动转换成分区谓词,无需用户感知分区列。而 Hive 表需要用户显式指定分区列,否则可能全表扫描或静默错误。
AWS 对 Iceberg 提供了哪些支持?
AWS 通过 Glue Data Catalog 提供原生 catalog 后端、Iceberg REST Catalog 服务端、联邦目录和 Lake Formation 权限控制。此外还有 S3 Tables 托管运维、Firehose 和 MSK 的摄入支持,以及 EMR、Athena、Redshift 等引擎的读写支持。
