



2026年,OpenAI的GPT-6 Astra采用“循环深度”技术,在Transformer中引入深度循环,不增加参数却加深计算,引发AI安全争议。该技术区别于2017年废弃的序列循环,旨在提升参数效率,但面临训练不稳定、推理成本高等挑战。文章探讨了循环架构的复兴及其对AI发展的意义。
二阶非线性光学研究强激光与特殊光学晶体的相互作用,产生新频率光束。斯坦福大学等团队提出基于长短期记忆网络(LSTM)的代理模型,显著提升计算速度,降低运算成本,解决传统模型的局限性。该模型在实时优化和数据融合中具有广泛应用潜力,为光电系统设计提供新思路。
本文介绍了语言模型的发展历程,包括N-Gram、NPLM、RNN和LSTM等。N-Gram通过统计前n-1个词的概率进行预测,但缺乏泛化能力;NPLM引入词向量,具备一定的泛化能力;RNN和LSTM通过递归状态支持变长序列,解决了长期依赖问题。总结了N-Gram和Bag-of-Words的基本原理及应用。
本文探讨了RNN(循环神经网络)与Transformer架构的演变。RNN面临长程依赖、梯度稳定和训练并行的三难问题,LSTM部分解决了梯度问题,但仍无法并行训练。2017年,Transformer通过完全依赖注意力机制解决了这三难,成为主流架构。尽管Transformer在长程依赖和并行性上表现优异,但其复杂度和内存消耗仍是局限。未来可能会出现结合循环结构的新模型,如Mamba和RWKV,以应对Transformer的不足。
本文探讨了循环神经网络(RNN)在处理变长序列中的应用及其局限性。RNN通过权重共享和记忆机制处理序列数据,但存在长程依赖、梯度消失和训练并行性等问题。LSTM和GRU作为RNN的变体,通过门控机制改善了这些问题。尽管RNN在早期自然语言处理和机器翻译中发挥了重要作用,但随着Transformer的出现,其应用逐渐减少。
ParaRNN是一个新框架,突破了非线性递归神经网络(RNN)的序列并行化限制。它通过将非线性递归关系转化为单一方程组,并利用牛顿迭代法进行并行求解,实现了高达665倍的速度提升。该框架支持训练7B参数的LSTM和GRU模型,表现出与同规模的Transformer相当的困惑度。ParaRNN的开源代码库将促进高效序列建模的研究。
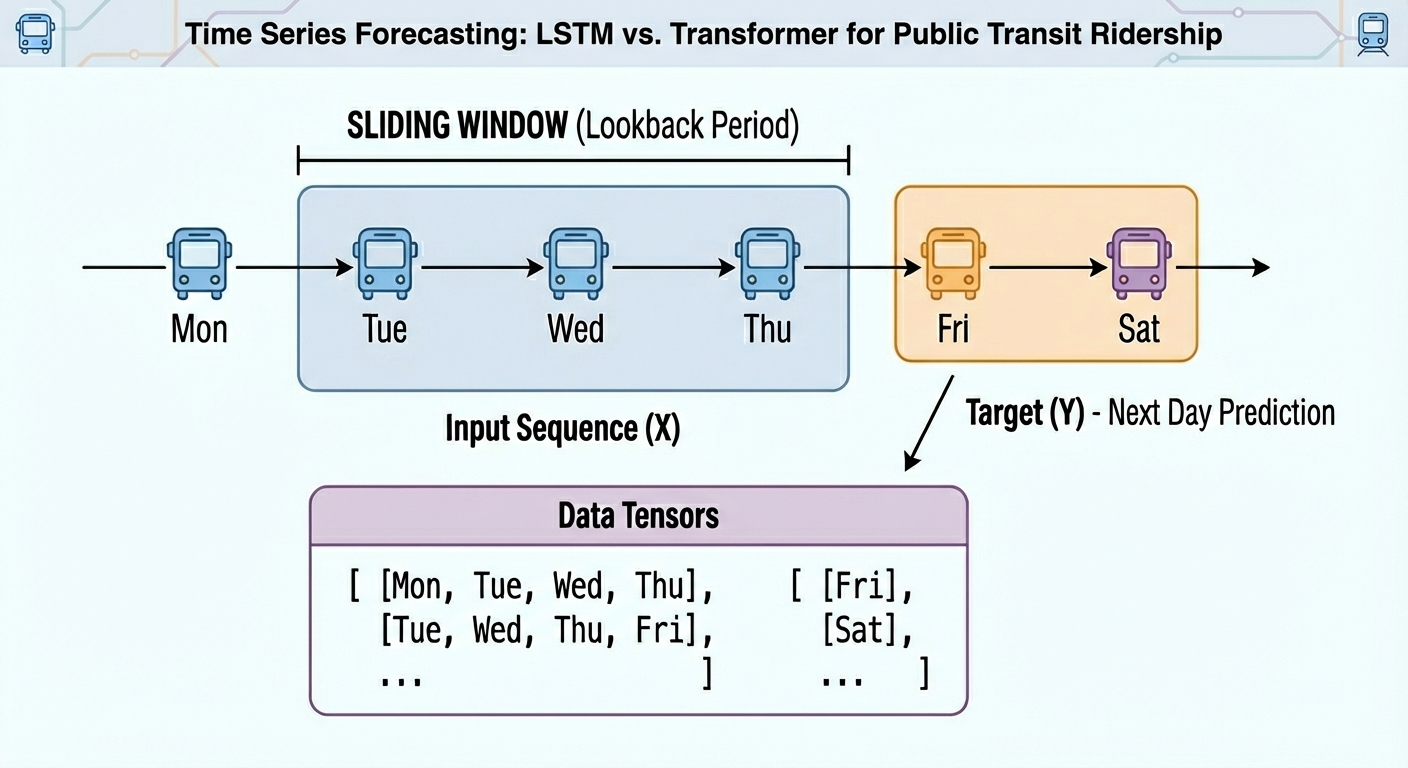
本文探讨了使用LSTM和Transformer模型进行单变量时间序列预测。通过分析芝加哥公共交通数据,展示了数据预处理、模型训练和评估的过程。结果表明,两种模型的预测性能相似,Transformer略优。建议尝试不同数据集以观察模型表现的差异。
该课程在freeCodeCamp.org YouTube频道上详细讲解了神经机器翻译的发展历程,包括RNN、LSTM和Seq2Seq模型的历史突破及其数学原理,并通过PyTorch实验帮助学习者逐步重建这些重要论文。
LSTM之父Schmidhuber质疑何恺明是残差学习的奠基人,指出早在1991年,Hochreiter已提出循环残差连接以解决梯度消失问题。他认为ResNet等深度学习成果应归功于早期研究,争论已持续多年。
本文介绍了如何构建和训练基于LSTM的序列到序列(seq2seq)模型,用于英语到法语的翻译。模型采用编码器-解码器架构,编码器处理输入序列生成上下文向量,解码器基于该向量生成输出序列。文章详细讲解了数据集准备、模型实现、训练过程及改进方法,并强调了注意力机制的重要性。
机器之心数据服务现已上线,提供高效稳定的数据获取,简化爬取流程。
京东科技提出了一种基于LSTM网络的无阈值时间序列异常检测方法,结合基线模块和无监督检测模块,实现高效准确的异常分析,克服了传统阈值设定的局限性,适应性强,适用于不同周期和动态变化的场景,实践验证效果显著。
递归神经网络(RNN)是一种处理序列数据的神经网络,具备“记忆”功能,广泛应用于自然语言处理、机器翻译和情感分析等领域。长短期记忆(LSTM)网络解决了基本RNN的梯度消失问题,增强了对长距离依赖的捕捉能力。尽管RNN存在训练困难和计算开销大的缺点,但其在深度学习中的重要性持续上升。
多类文本分类是自然语言处理中的关键任务,RNN和LSTM模型用于处理文本序列。RNN适合顺序数据,但对长文本效果不佳;LSTM通过增强记忆能力解决此问题。构建分类器需收集标记数据、预处理文本、建立并训练模型。该技术广泛应用于情感分析和邮件分类等领域,提高了文本处理的准确性和效率。
本研究提出了一种名为HybridoNet-Adapt的框架,用于准确预测锂离子电池的剩余使用寿命(RUL)。该方法结合特征提取、去噪和归一化,利用LSTM和神经常微分方程块,显著提高了预测的可靠性,实验结果表明其优于现有技术,具有重要的实际应用价值。
该研究提出了一种新方法,利用有限视图推断抓取策略,结合LSTM单元的循环生成对抗网络(R-GAN),实现了89%的准确率。
本文探讨了时间序列预测的三种主要方法:自回归积分滑动平均(ARIMA)、指数平滑时间序列(ETS)和长短期记忆网络(LSTM)。ARIMA适用于稳定数据,ETS适合具有周期性的数据,而LSTM则利用深度学习捕捉复杂模式,适合处理序列数据。这些方法有助于优化资源配置和降低运营风险。
本研究提出了AP-pVAD模型,结合NPQ与LSTM-Transformer,解决了pVAD脉动控制中的关键问题。结果表明,该模型在压力和脉动时间预测上误差较低,具有良好的有效性和稳定性,对pVAD的临床应用具有重要意义。
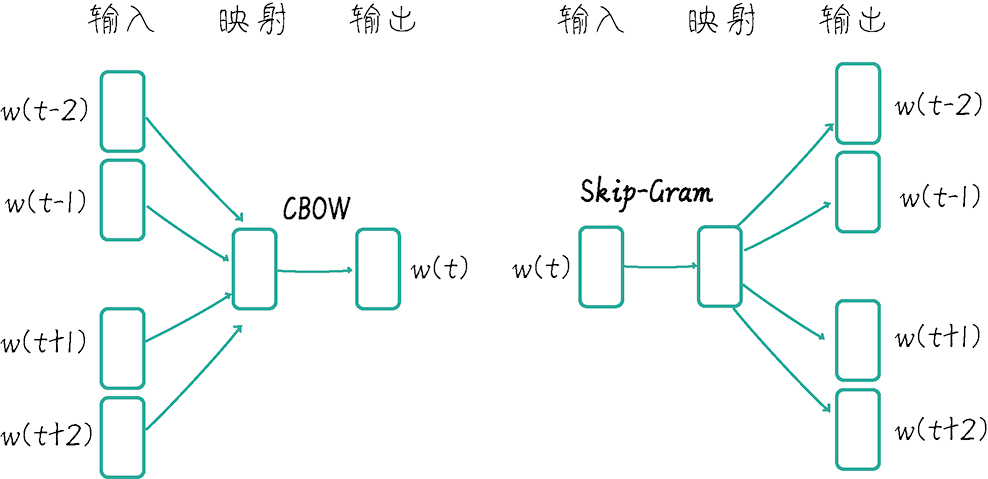
本文介绍了N-gram模型和Word2Vec的基本概念。N-gram模型用于计算句子概率,捕捉短语结构和上下文关系,但存在局限性。Word2Vec通过降低维度和赋予词语语义信息,解决了传统one-hot编码的问题,提升了词与词之间的关联性,并展示了其训练过程及在文本分类中的应用。
本文介绍了N-gram模型和Word2Vec的基本概念。N-gram模型用于计算句子概率,捕捉短语结构和上下文关系,但存在局限性。Word2Vec通过降维和赋予词语语义信息,解决了传统one-hot编码的问题,增强了词与词之间的关联性。结合LSTM和自注意力机制,进一步提升了模型性能。
完成下面两步后,将自动完成登录并继续当前操作。