DeepSeek V4.1 Flash 1017每秒一千五百个词,人类连读都读不过来!注意,这是运行在Fireworks Ultrafast。 DeepSeek 11秒写完俄罗斯方块,速度是Claude Opus 5.5的七倍,评论区却吵成一锅粥。 速度数字炸了,但没人告诉你分母是什么
Claude Opus 5.5 一夜之间反编译了一款 PS2 时代的游戏,现
谷歌Gemini 4 Argon在18项基准测试中14项领先Claude Opus 5.5,且限时半价。作者实测三项任务:代码审查两者持平,Argon更便宜;规格测试因一行代码错误失败;长上下文测试中Argon推理错误严重、回答草率。结论:Argon虽便宜,但可靠性不足,不建议使用。
谷歌发布旗舰模型Gemini 4 Argon,主打复杂多步任务,覆盖编程、金融、科研等领域,在Vals Index排名第一。该模型支持百万Token,定价激进。内部测试中代码提交量增长35%,回滚率降低近三分之一。实测显示其3D生成与代码能力出色,成本远低于竞品。但未付费用户默认仅能使用轻量版Flash-Lite,满血体验需付费。
Meta发布Muse Wonder系列模型,主攻个人智能体,强化跨对话记忆与长任务执行能力,部分评测比肩GPT-6.1等领先模型。Meta借此重整AI业务,推动订阅与API收费,但编程和3D生成仍逊于对手,成本与授权问题也待解决。
Anthropic发布Sonnet 5.5,价格仅为Opus 5.5的一半。相同提示测试显示:Sonnet 5.5在代码修复和并发测试中更准、更快、更便宜,15次运行全部通过,总成本比Opus 5.5低约36%;Opus 5.5在智能体测试中更快、更省。建议硬编码任务默认用Sonnet 5.5并调高输出上限,智能体循环仍用Opus 5.5。
Opus 5.5派10个数字分身去算晶体结构,居然说找到了室温磁性半导体! Vals AI用Claude Opus 5.5智能体跑量子模拟,声称发现两种室温磁性半导体。但科学家泼冷水:计算机预测不等于真实存在,LK-99阴影未散。AI到底在发现还是做功课? AI智能体发现室温磁性
OpenAI的Codex负责人Tibo宣布,未来28天每天二选一:要么交付对多数用户明显有用的改进,要么重置额度。此举被视为安抚用户,因DevDay更新过多、额度重置频繁且套餐缩水、模型任务中途断连等问题引发不满。关键不在“每天”,而在改进是否真正有用。
本期播客聚焦AI行业动态:Anthropic发布Opus 5.5,价格更低、性能更强,并扩大网络安全防御应用;OpenAI推出低价GPT-6系列Sol和Luna,但可解释性受限。Meta的Muse登陆Mac,下载量超ChatGPT早期,却遭亚马逊封禁。开源方面,DeepSeek-V4.1-Flash优化KV缓存压缩,Bonsai 227B实现近无损压缩。政策上,中美将讨论AI风险,多公司因呼吁“放缓”AI被诉,公众对数据中心负面看法上升。研究涉及奖励黑客检测、疼痛轴表征及多智能体通信。
2026年10月初,一条消息在会计圈和AI圈同时刷屏:Anthropic 的 Claude Opus 5 在一项专业会计任务测评中拿到了20题全对、100%的成绩,而12名持证注册会计师(CPA)的得分
国产模型 MiniMax M3.1 Flash Preview 在前端创作上可与旗舰 Claude Opus 5.5 一较高下,测试涵盖动态作品集、手绘与水墨短片、交互场景及游戏原型,风格统一、完成度高。该模型以速度与成本优势,让更多编程任务稳定进入开发流程,推动 AI 能力普及。
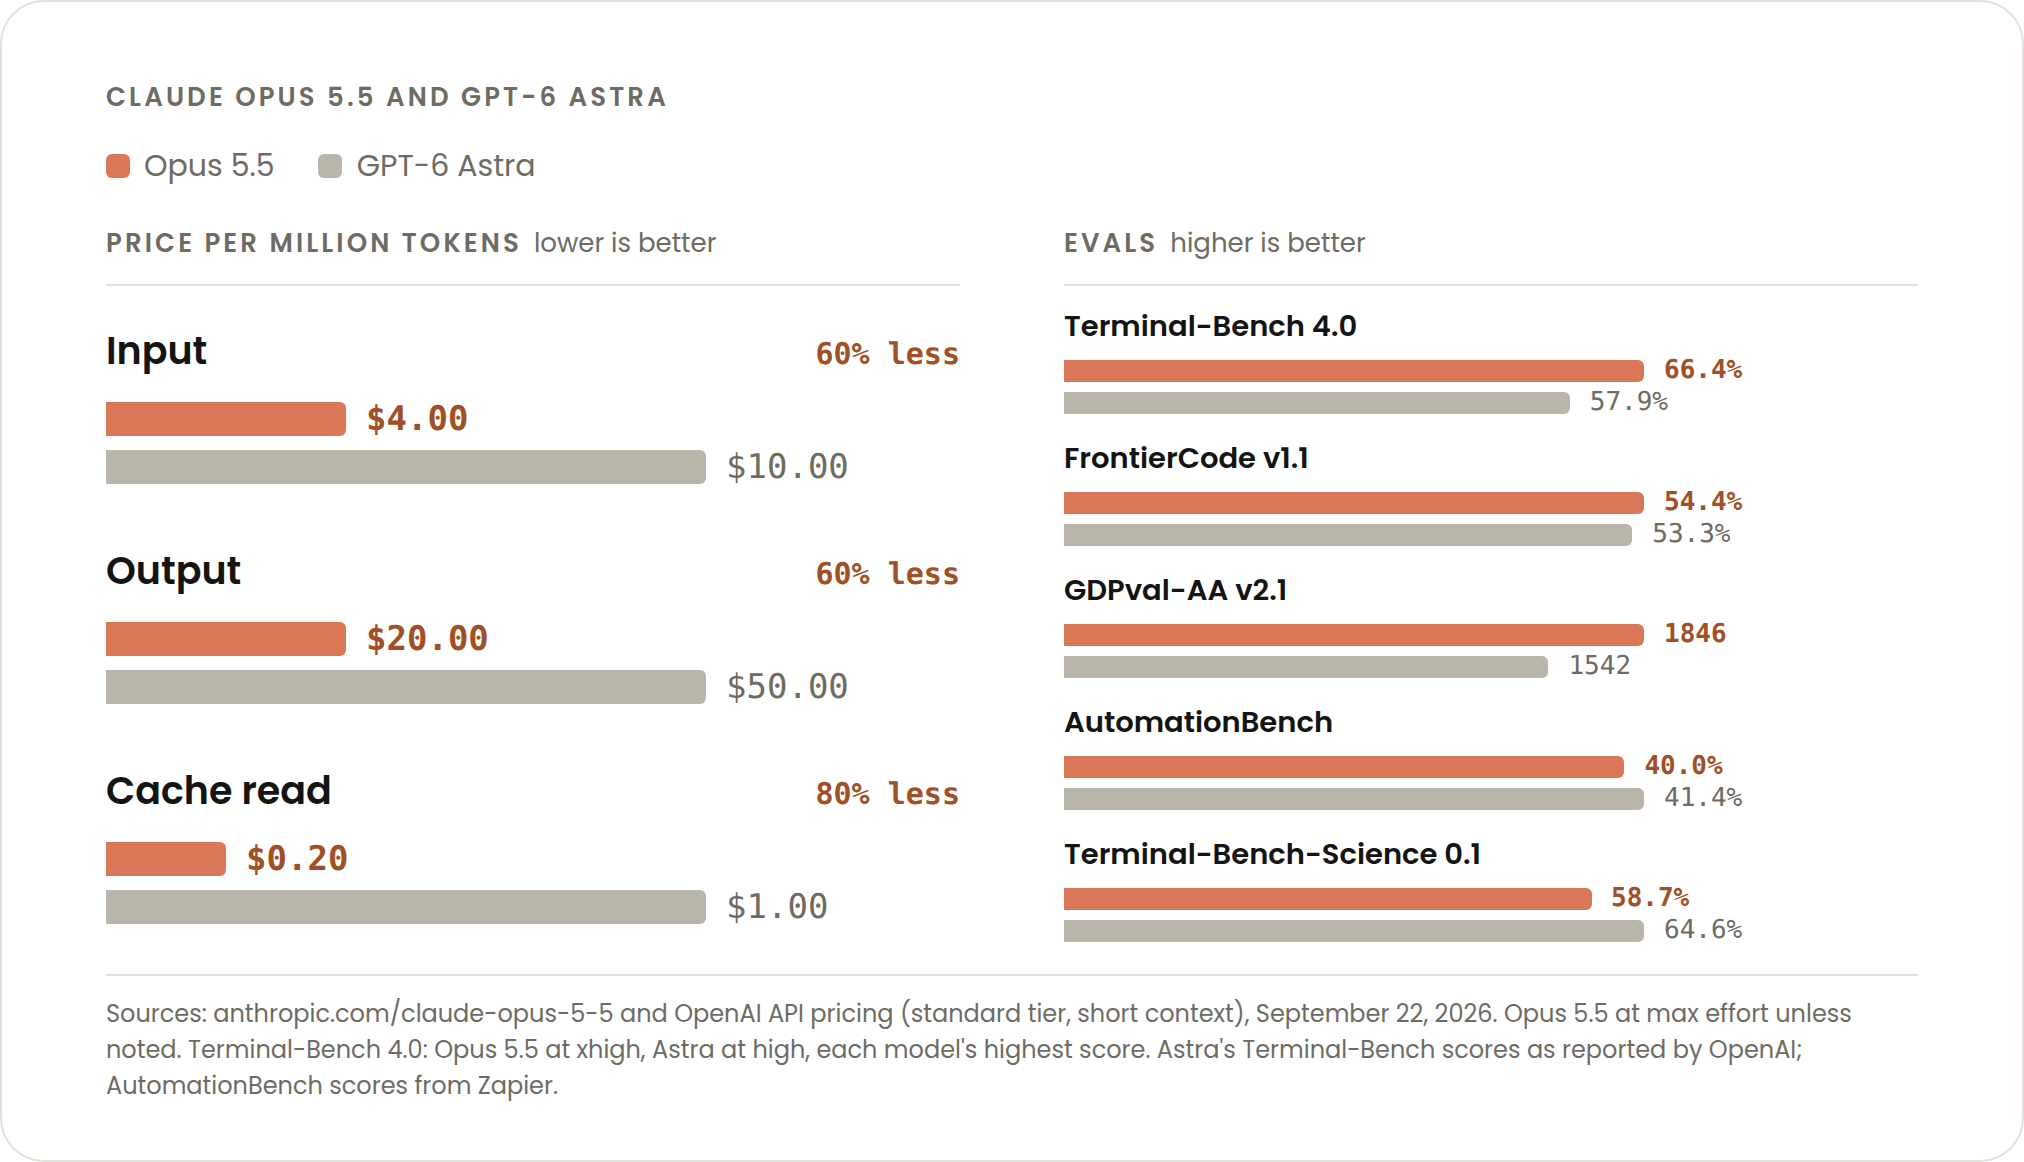
谷歌发布Gemini 4 Argon,在多项榜单登顶,性能超越Claude Opus 5.5和GPT-6 Astra,成本约为对手一半,支持百万Token输出,主打编程、金融、法律及网络安全防御。目前仅向审核过的网络安全团队开放。内部评价不一,有人质疑其编程实际表现和刷榜,谷歌予以否认。
Anthropic发布Claude Opus 5.5,价格不到Fable 5.1的一半,基准测试领先。作者通过编码测试对比:Opus 5.5在代理测试中正确保留有问题的测试代码,成本更低,但过度思考、耗token多,并发测试两次超限失败;Fable 5.1更快、15次全对,却在代理测试中删除必要代码以通过测试。总体Opus 5.5便宜22%,但耗时多67%。作者建议代理任务用Opus 5.5,追求速度用Fable 5.1。
开源项目Jev Use为Codex等AI代理提供技能与运行时,通过Jev模型优化浏览器和桌面自动化任务编排,减少往返调用,将执行效率提升约2.6倍。
Anthropic发布Claude Sonnet 5.5,速度较上代提升逾30%,单任务成本最多降低30%,擅长编程、文档与幻灯片制作。Terminal-Bench 4.0得分70.6%,远超Sonnet 5的10.3%。定价不变,每百万输入2美元、输出10美元。已在Claude平台及AWS、谷歌云、微软Azure上线,并首次为Sonnet配备网络安全防护与推理防提取分类器。
OpenAI发布GPT-6 Sol,宣称在业务任务上优于Claude Opus 5且成本仅9%。实测对比Opus 5.5:单次任务两者持平,但重复测试中Opus 5.5十五次全对,Sol仅十二次全对。Sol在价格和速度上占优,总成本仅为对手16%,但准确性稍逊。建议高容错场景用Sol,高风险场景用Opus 5.5。
上周AWS主要动态:Amazon Bedrock上线OpenAI GPT-6 Sol、Luna及Anthropic Claude Opus 5.5,强调按需匹配模型;CloudWatch Omni统一观测应用与智能体;EventBridge增强自定义事件总线;SageMaker HyperPod推出GPU感知推理网关;SES等发布智能体技能;Strands框架开源,成本降低约28%;AWS再获Gartner容器管理领导者。
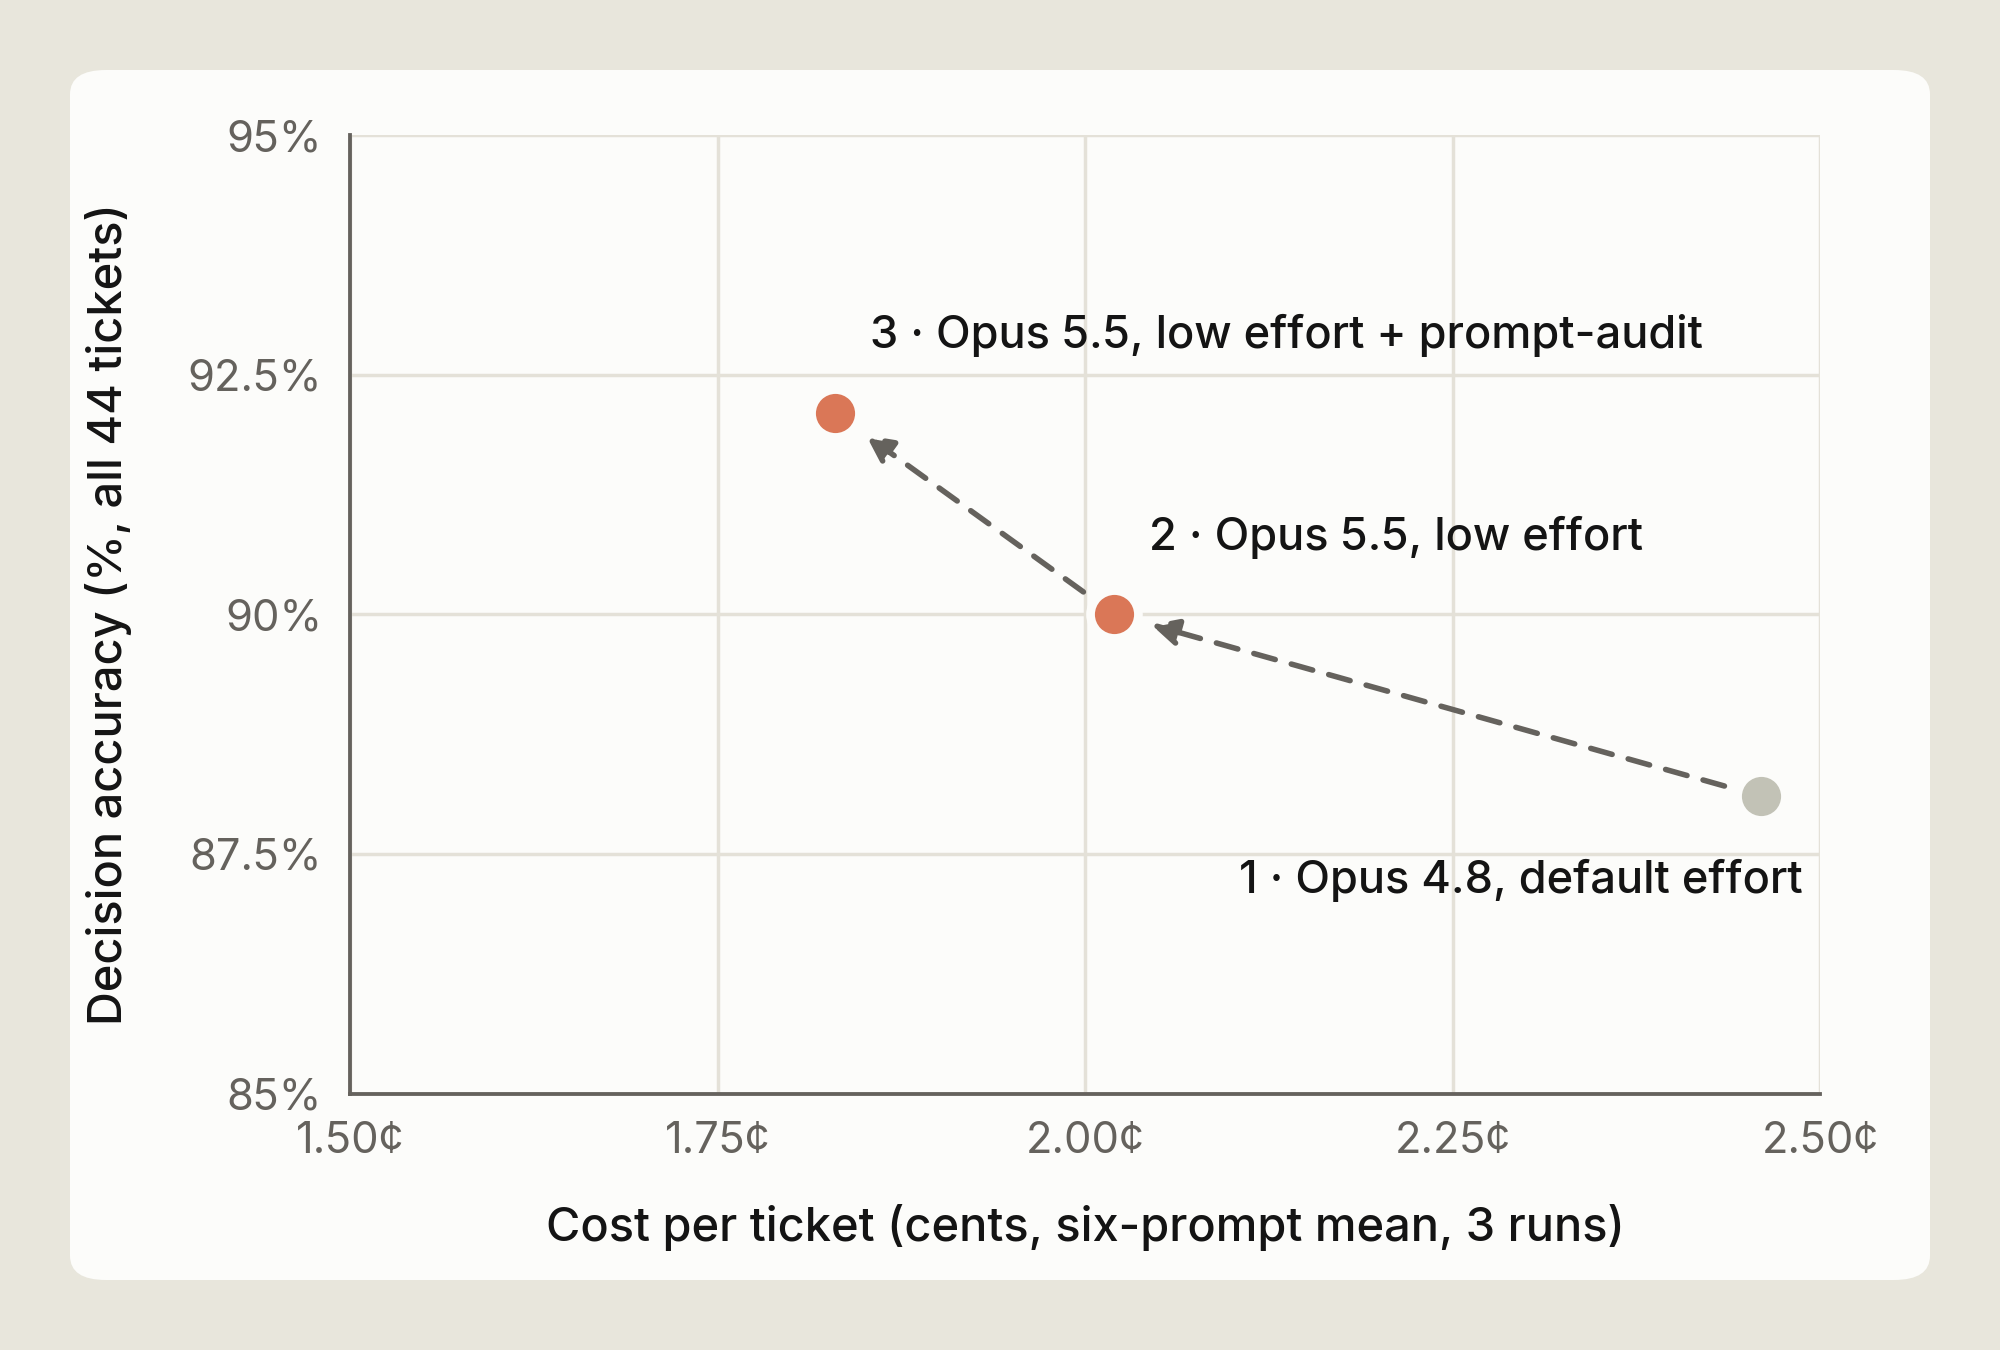
Anthropic发布Claude Opus 5.5,宣称比Opus 5便宜40%、快30%。作者用三道推理题实测:两者正确率相同,Opus 5.5每题更省钱更快,逻辑题省43%,石子游戏省69%,主要靠减少输出token,速度仅快11%。但难题中两模型都可能思考近20分钟无结果,且Opus 5.5曾误触安全过滤拒答。建议升级,但设输出上限,计数题应配代码工具。
Claude Code任务成本由轮次、缓存读取、输出token和模型选择构成。Opus 5.5较Opus 5输入输出便宜20%,缓存读取便宜60%。日常建议用中等effort让模型自检,卡住再升high,两次失败换Fable 5.1,搜索类子代理用Sonnet或Haiku。可用/usage查看实际用量,自行测量最可靠。
Claude Opus 5.5按token计费比Opus 5便宜约40%,主要惠及长时间、高上下文会话。成本优势来自三方面:输入输出token降价20%、缓存读取降价60%;Claude Code缓存命中率提升,未命中输入减少超50%;完成同一任务所需轮次更少,输出速度提升30%以上。建议在会话开始时选定模型、离开前压缩上下文,并为长会话设置一小时缓存。
完成下面两步后,将自动完成登录并继续当前操作。