作者记录了其Apple健康数据可视化网页在移动端因大文件解析导致内存超限而崩溃的问题,并提出五层流式重构方案:使用file.stream()分块读取、fflate流式解压、在Worker内进行极简SAX解析、将列存buffer转为Parquet并交由DuckDB-WASM以SQL下钻查询、用Canvas渲染图表;同时讨论了OPFS持久化、跨域隔离及iOS限制等优化要点。
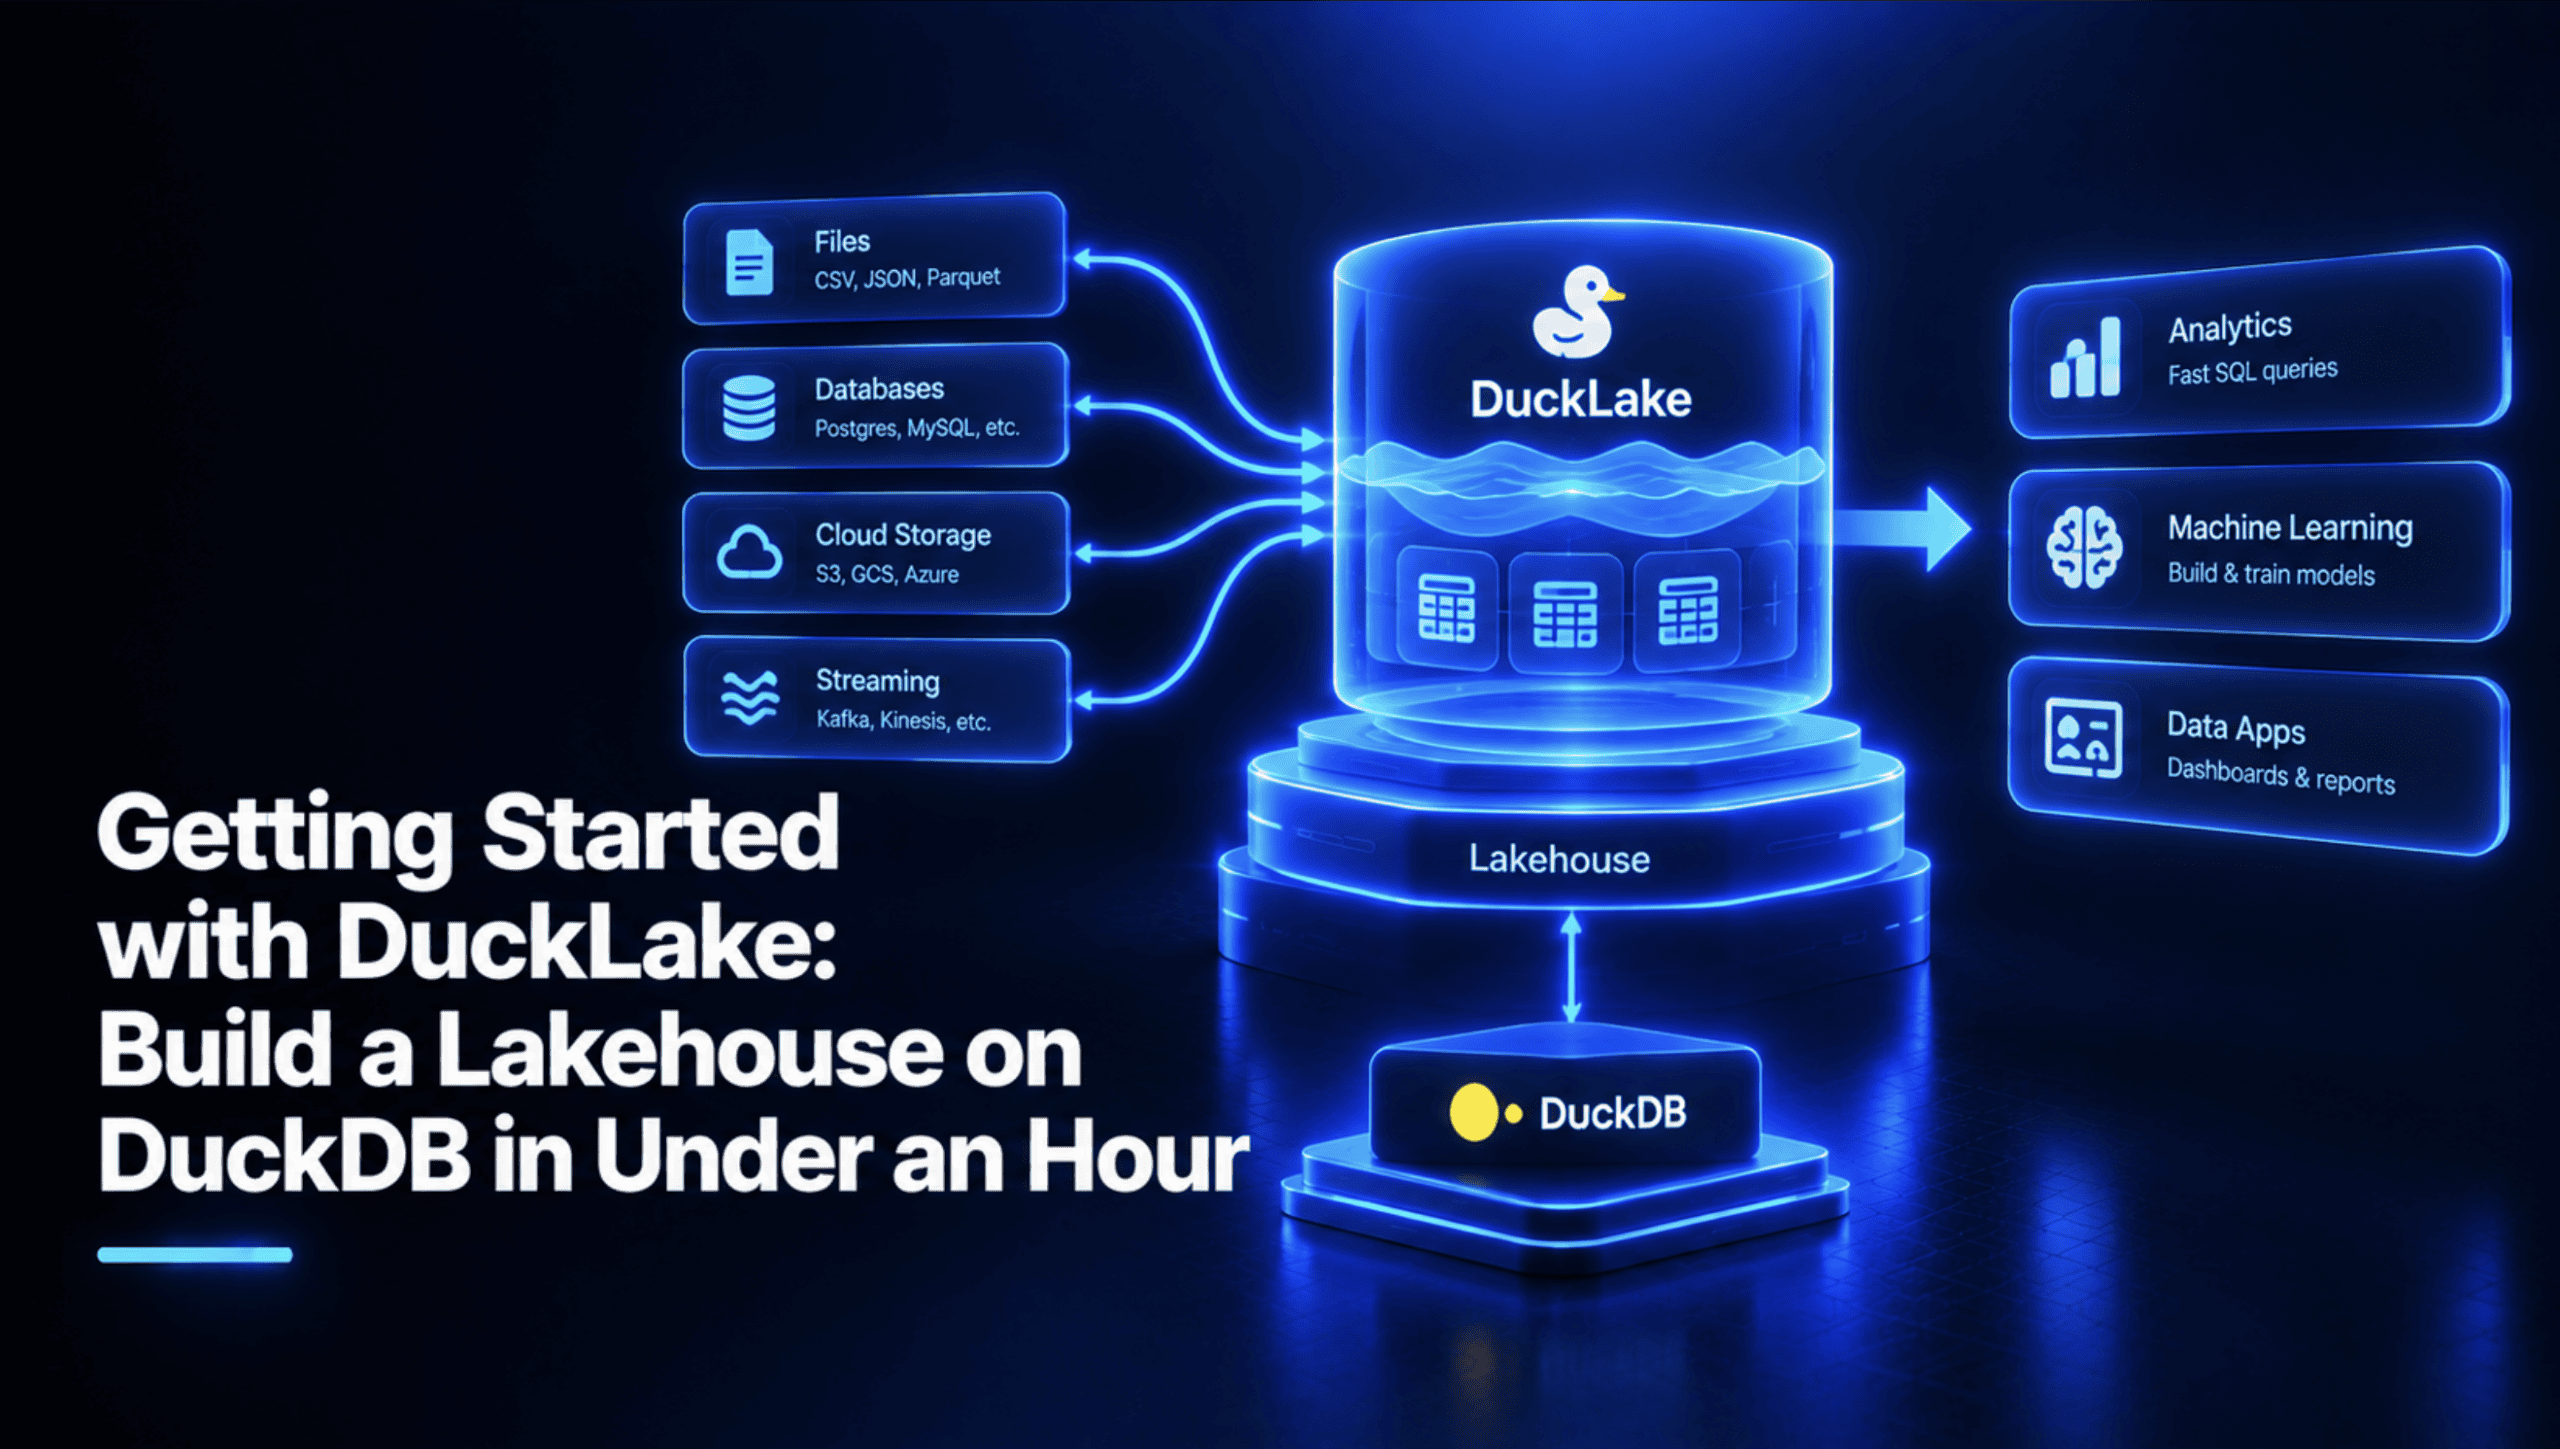
DuckLake是DuckDB团队推出的开放湖仓表格式,元数据存于SQL数据库,数据存为Parquet文件,1.0版于2026年4月发布。本文用Python和duckdb包在笔记本上搭建湖仓:生成示例Parquet数据,创建表并加载,执行追加、更新及增删列等模式变更,用AT (VERSION => n)查询历史版本并恢复误删数据,最后合并小文件。需注意旧文件要过期快照后清理,小写入默认内联,单客户端用DuckDB目录,多用户改用PostgreSQL。
作者发布实验性向量化数据库pg_vexec一个月后称,其在ClickBench查询执行上已超过ClickHouse:Parquet格式几何均值快13倍、总时间快18倍;MergeTree上几何均值快1.9倍、总时间快1.3倍。项目源于将Greenplum移植到PostgreSQL 19并提取ORCA优化器,目前正开发GPU版本,并已公开测试遥测数据与源码。
本文为Python资讯合集,涵盖:Django ORM迁移教程(回填必填字段、回滚迁移、解决多人迁移冲突,并用Django 6.1新fetch模式优化慢页面);Python函数式编程、MVC模式与Flask应用;PyTorch 2026年贡献增长58%、AI编码代理参与增多;贝叶斯超参数优化;Pendulum库中检查调用栈的“诅咒”加号运算符;PyPI因邮件信誉算法更新重新允许Outlook邮箱注册;Parquet列式存储优势分析;以及Gemini 4 Argon绘图、项目结构、PDF表格提取、字符串教程、开源项目与会议信息。
湖屋中的Parquet文件不可修改,模式演进通过元数据实现:每列创建时分配不可变字段ID并写入文件,读取时按ID映射,无需重写数据。新增列分配新ID,旧文件缺失该ID则填NULL;删除列仅设结束快照,保留历史以支持时间旅行;重命名列不改ID,旧文件自动适配。模式版本仅在结构变更时递增,以保证同版本文件可安全合并。
湖仓项目第二阶段使用Go语言的parquet-go库读写Parquet文件。Parquet为列式存储,记录每列min、max、null_count统计信息,支持文件裁剪以减少I/O。写入时通过StatsCollector实时收集统计;读取时按列投影,仅读所需列。每列带field ID,重命名后仍能正确匹配,为模式演进奠定基础。文件以UUID命名避免冲突。
Amazon S3表类数据存储服务现已支持Apache Iceberg V3全部数据类型,包括变体、纳秒时间戳、几何、地理位置和未知类型,以及删除向量和行谱系。用户可新建V3表或从V2升级,升级不可逆。V3以删除向量替代位置删除文件,提升行级操作效率,并原生支持半结构化和地理空间数据。新数据类型需Spark 4.0以上引擎,且仅支持Parquet格式。该功能已在所有支持区域推出,不额外收费。
本文介绍用Go构建小型湖仓引擎,模仿DuckLake架构:元数据存于Postgres,数据用Parquet。核心是八张元数据表,涵盖快照、表、列、数据文件、列统计、删除文件等。通过begin_snapshot和end_snapshot实现快照可见性与时间旅行。相比Iceberg的清单文件树,数据库方案让文件裁剪变成SQL查询,原子提交只需事务,但依赖运行中的数据库。
DuckDB 读写 S3 上的 Parquet 文件需要 AWS 凭证。除硬编码密钥外,可用 `PROVIDER credential_chain` 让 DuckDB 按 AWS SDK 顺序自动查找凭证:环境变量、IRSA Web Identity、SSO 配置文件、ECS 任务角色、EC2 实例元数据,取首个可用者。该逻辑位于 aws 扩展,也适用于 GCS 和 R2。IRSA 通过注解 ServiceAccount 注入角色与令牌,由 kubelet 和 SDK 自动轮换。DuckLake 本地开发用静态密钥,生产用凭证链。
Hardwood 1.1 Beta1发布,首次支持Parquet写入,提供RowWriter和ColumnWriter两种API,并优化查询层(Bloom过滤器、字典行组剪枝)及性能(固定长度列表快速路径等)。CLI改用Æsh框架,启动更快,新增AI代理技能和WebAssembly实验版本。此版本修复109个问题,兼容DuckDB和parquet-java,未来将完善写入功能。
Parquet是一种高效的列式二进制数据格式,比CSV更可靠,支持压缩和快速查询,被Spark、DuckDB等主流工具广泛支持。Apache Iceberg作为表格式管理Parquet文件集合,提供事务、模式演进和时间旅行功能。两者结合,可在低成本存储上实现数据仓库行为,适合数据超出单一系统时使用。
Parquet 是一种列式二进制文件格式,其元数据页脚包含所有列块的字节偏移和统计信息,配合 S3 的 HTTP 范围请求,可实现精准读取,仅下载所需数据。它支持列式压缩、统计剪枝和自描述特性,在对象存储上高效运行。Iceberg 等湖仓格式依赖它实现双层数据跳过,相比 CSV、Avro 等格式,Parquet 在分析场景中优势显著。
本文介绍使用Amazon Athena分析Kiro团队用量报表的实践。针对CSV中动态模型列可能导致数据错位的问题,通过ETL将宽表转为长表,采用Parquet格式和Partition Projection建表,实现稳定查询。方案完全Serverless化,月成本低于1美元,并接入Amazon QuickSight构建看板,便于团队观测用量、治理额度。
Spotify等公司需快速访问海量数据,但传统SQL引擎延迟高。RAP(随机访问Parquet)通过外部索引将键直接映射到文件位置,实现O(1)查找,避免扫描。它支持排序、分组、单页键、ZSTD帧重置等优化,减少读取次数和字节数,甚至可零读取。RAP复用现有Parquet文件,无需复制,使数据湖支持交互式查询,降低在线服务成本,惠及AI代理等场景。
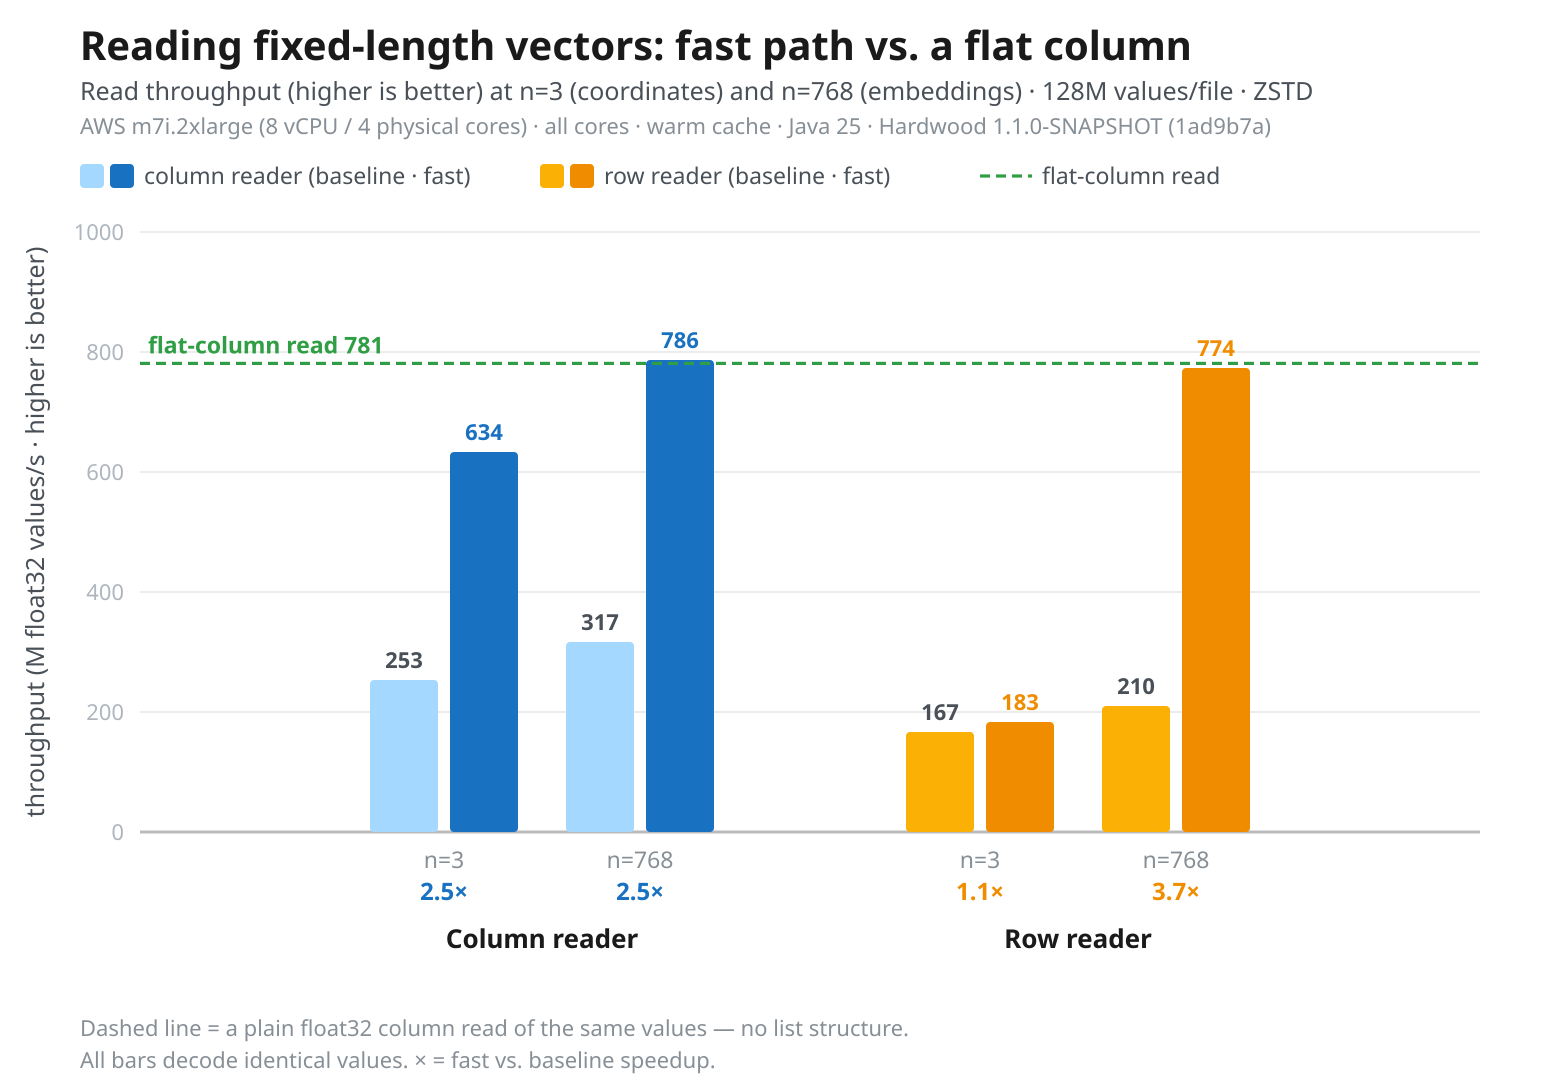
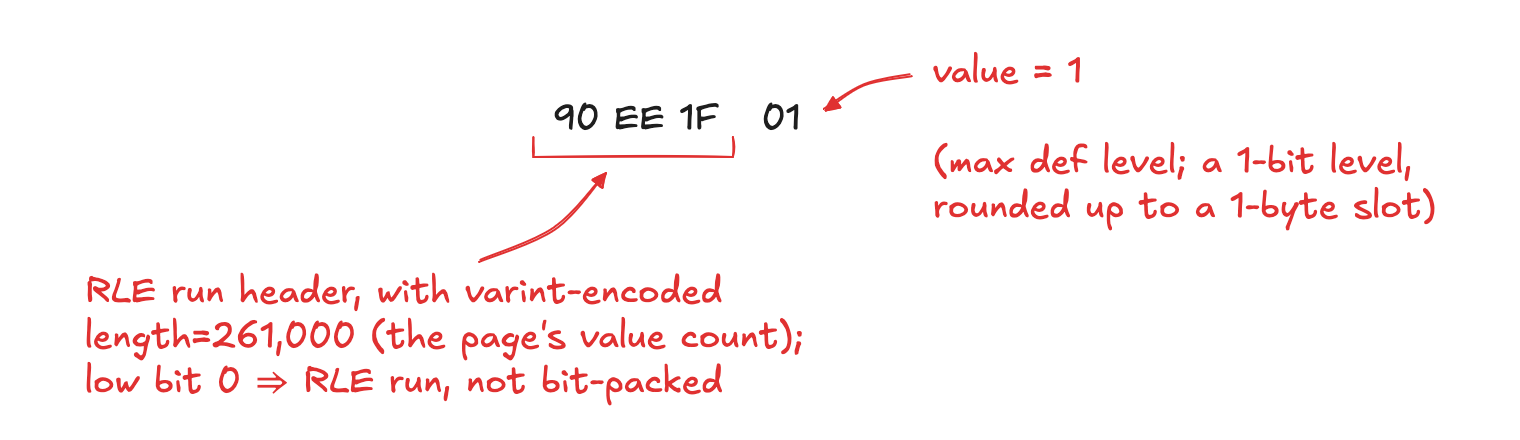
Apache Parquet存储固定长度列表(如向量嵌入)效率低,因Dremel编码开销大。Hardwood通过检测定义和重复级别流,识别固定长度列表并绕过常规解码,实现快速路径。列读取器提速达2.5倍,行读取器最高3.9倍,接近扁平列性能。该优化可选启用,预计1.1版默认开启。
ORC和Parquet是两种列式存储格式,分别源自Hive和Twitter/Cloudera。ORC适合Hive事务表,支持ACID,且在整数和时间戳数据上压缩效果好。Parquet是跨引擎的通用格式,广泛应用于AI和数据分析工具。选择时需考虑具体应用场景和数据特性。
本文探讨了Parquet文件的结构与性能优化,包括数据的物理切分(行组、列块、页面)、元数据存储方式,以及通过裁剪元数据(如列索引、偏移索引、布隆过滤器)提高查询效率。Parquet采用“先写数据、后写元数据”的设计,文件尾部包含所有统计信息,支持高效的谓词下推和投影下推,显著减少读取数据的IO量。
Apache Arrow 旨在解决不同系统间的数据内存表示问题,通过定义一种与语言无关的列式内存格式,实现零拷贝共享。其内存布局包括有效性位图和数据缓冲区,支持高效分析运算。C 数据接口允许在同一进程中无拷贝传递数据,而 IPC 和 Flight 则支持跨进程和网络传输。Arrow 与 Parquet 互补,前者优化内存计算,后者优化磁盘存储。
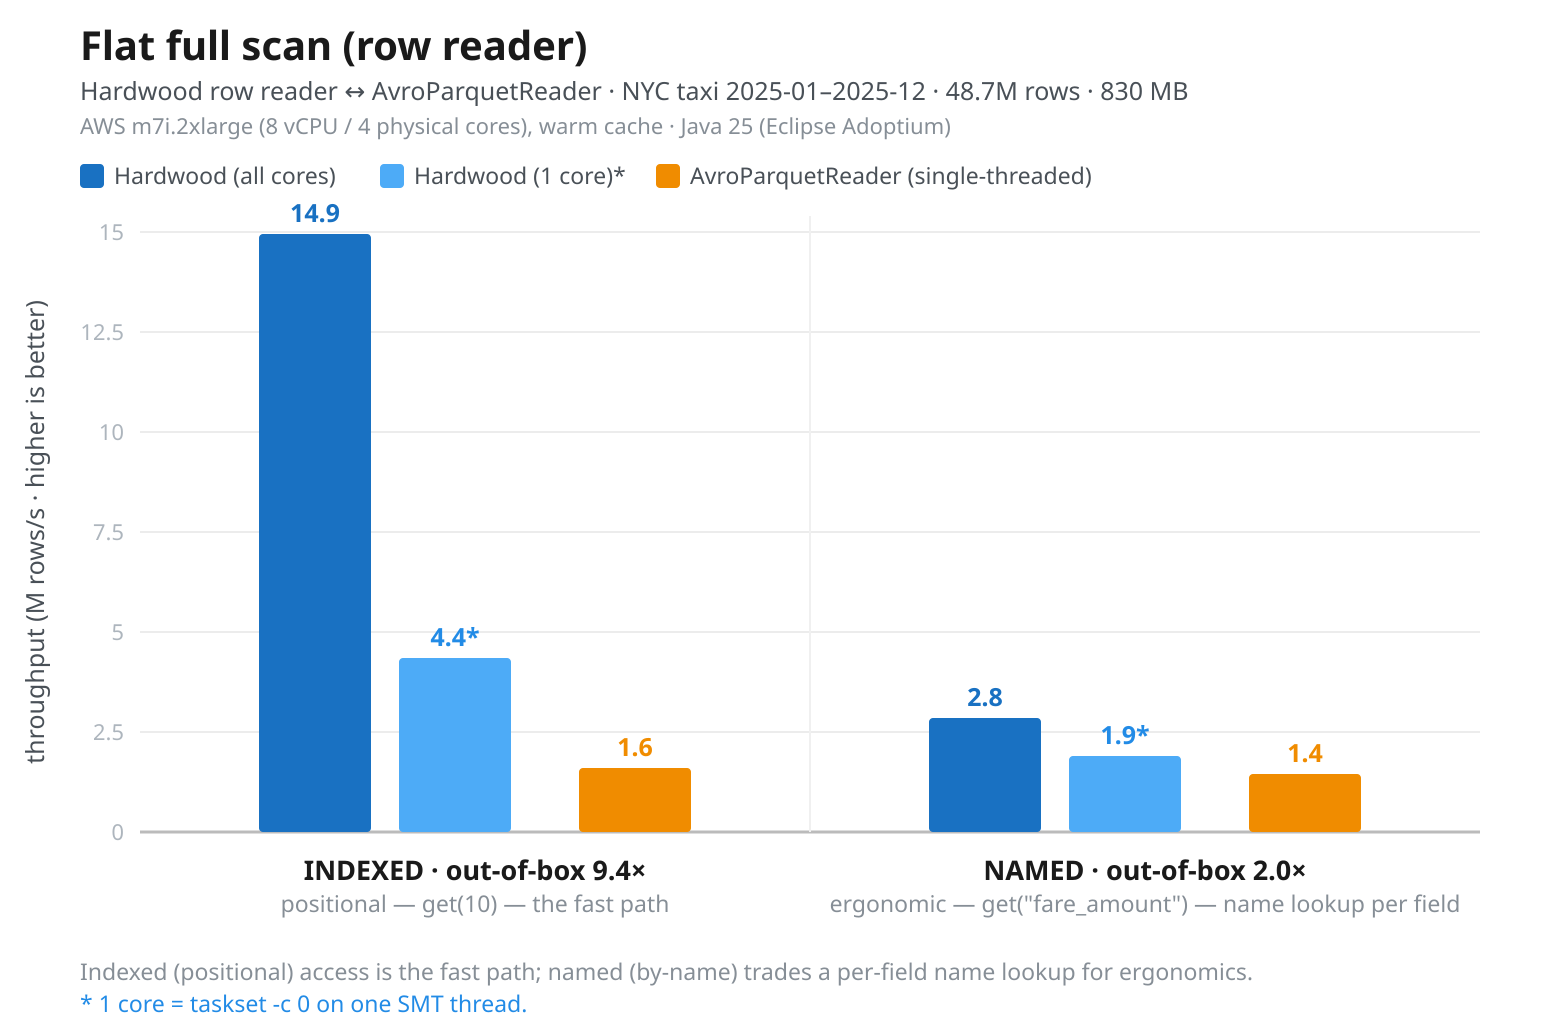
Hardwood是一个为JVM开发的新Parquet库,专注于快速读取Apache Parquet文件,支持多线程和无强制依赖。1.0版本已发布,兼容Java 21及以上,开源并可从Maven Central获取。它支持多种列类型和压缩方案,提供行读取和列读取两种API,适合不同的使用场景。未来版本将增加写入支持和性能优化。
Polars 1.41版本发布,新增快速的parquet元数据解码和嵌套子计划消除等功能。
完成下面两步后,将自动完成登录并继续当前操作。