
小红花·文摘
  • 首页
  • AI Tokens🪙
  • 排行榜🏆
  • 直播
  • FAQ
AI音乐制作工具Suno现已支持生成语音

Suno推出语音生成功能Speech,已在网页和移动端公测。用户输入脚本或描述后,可同时生成配音与背景音乐,音乐可关闭。该功能提供简单和高级两种模式,可调整语音性别、风格等,最长约八分钟。官方表示功能尚不完善,将根据反馈改进。

AI音乐制作工具Suno现已支持生成语音

The Verge The Verge · 2026-10-02T09:42:19Z
Zipper-LoRA:面向 Speech-LLM 多语种语音识别的动态参数解耦方法

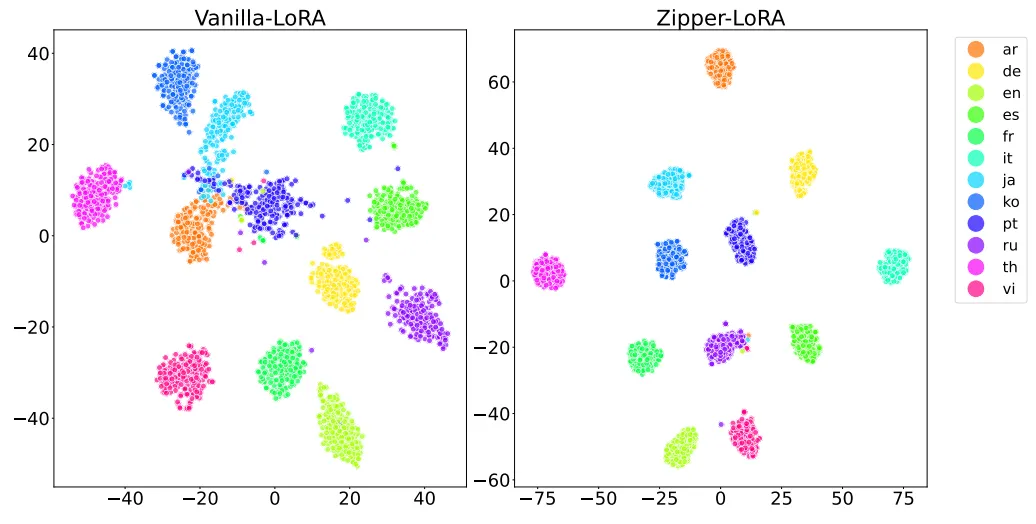
针对Speech-LLM多语种识别中共享LoRA参数引发的跨语言干扰,本文提出Zipper-LoRA框架,将低秩空间解耦为共享Rank与语言特有Rank,并结合动态路由与Initial-B热初始化。在12种语言上的实验表明,该方法显著降低低资源语言错误率,性能优于现有LoRA方案,已被TASLP 2026接收。

Zipper-LoRA:面向 Speech-LLM 多语种语音识别的动态参数解耦方法

实时互动网 实时互动网 · 2026-09-20T03:32:29Z
dsh-speech测评:DeepSeek Harness语音插件让打字变成历史

dsh-speech是DeepSeek Harness的语音插件,支持实时语音输入和AI回答的语音摘要,由AllModels.io提供技术。它区别于其他插件,将语音识别与摘要分离,用户可调整摘要详细度。安装简单,但需特定版本,且依赖付费服务,新用户获1美元额度。该插件旨在让打字成为可选项,提升交互效率。

dsh-speech测评:DeepSeek Harness语音插件让打字变成历史

极道 极道 · 2026-09-04T04:08:00Z
HuggingFace 开源speech-to-speech,支持本地部署

HuggingFace发布开源语音智能体流水线speech-to-speech,完全模块化,支持本地运行,无需API密钥。它通过Silero VAD、Parakeet TDT、Gemma 4和Qwen3-TTS等组件实现语音检测、转写、生成和合成,提供与OpenAI Realtime兼容的WebSocket API,可无缝替换,支持多语言和多种运行模式。

HuggingFace 开源speech-to-speech,支持本地部署

实时互动网 实时互动网 · 2026-08-10T02:09:35Z
Krafton开源语音AI基础模型“A.X K2 Raon-Speech”,发力游戏角色语音交互

Krafton开源语音AI模型A.X K2 Raon-Speech,采用端到端语音直接转换,保留情感语调,21B参数,韩语综合第一、英语第三,覆盖语音识别、合成等6领域,未来将用于游戏CPC角色实时互动。

Krafton开源语音AI基础模型“A.X K2 Raon-Speech”,发力游戏角色语音交互

实时互动网 实时互动网 · 2026-07-29T02:40:38Z
如何使用Web Speech API构建语音驱动的AI应用程序

本文介绍了如何使用Web Speech API构建一个全栈应用程序,该应用程序能够接收音频输入并将其转录为文本,随后将文本发送给AI助手并显示其响应。文章详细说明了前端和后端的构建过程,包括使用Node.js创建后端,集成AI助手,以及使用Vite构建前端。最后,介绍了如何将应用程序部署到Google Cloud Run和Firebase。

如何使用Web Speech API构建语音驱动的AI应用程序

freeCodeCamp.org freeCodeCamp.org · 2026-03-26T21:18:39Z

马克·卡尼在2026年达沃斯论坛上指出,国际秩序正经历重大变革,各国需诚实面对现实,重建基于价值的合作。中等强国如加拿大应增强战略自主,积极参与全球事务,推动共同利益,避免过度依赖强国。

Mark Carney's Speech at the 2026 Davos Forum (Reading Material)

LFhacks.com LFhacks.com · 2026-01-23T01:31:53Z
NVIDIA AI 发布 Nemotron Speech ASR:全新的开源实时转录模型

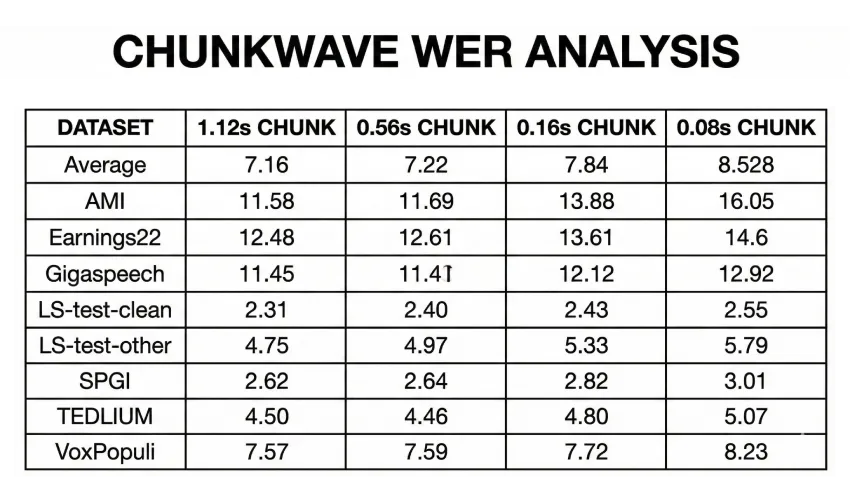
NVIDIA发布了Nemotron语音识别模型,专为低延迟语音助手和实时字幕设计。该模型采用缓存感知的FastConformer编码器和RNNT解码器,支持16 kHz音频,提供多种输入块配置,词错误率在7.2%至7.8%之间,显著提升了并发性和稳定性,适用于实时语音应用。

NVIDIA AI 发布 Nemotron Speech ASR:全新的开源实时转录模型

实时互动网 实时互动网 · 2026-01-08T02:51:11Z

在大语言模型(LLM)开发中,流式输出可以逐段生成内容,提升用户体验。语音合成(TTS)通常需要完整文本,导致延迟。通过中间件机制,将LLM的流式输出与TTS结合,可以实现边生成边朗读,从而提高交互流畅性。

让Micsoft Speech语音边加载边朗读

dotNET跨平台 dotNET跨平台 · 2025-08-07T00:02:12Z

本研究提出FMSD-TTS框架,针对藏语低资源问题,通过少量音频和方言标签生成方言语音,提升了方言表现力和说话人相似性。

FMSD-TTS: Few-Shot Multi-Speaker Multi-Dialect Text-to-Speech Synthesis for Generating U-Tsang, Amdo, and Kham Speech Datasets

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-05-20T00:00:00Z

MISP 2025挑战聚焦于复杂声学条件下的会议转录,提出音视频说话者分离与识别任务。参与者通过结合音频和视频模态,显著提升了系统准确率,展示了多模态信息在语音处理中的潜力。

Multimodal Information Based Speech Processing (MISP) 2025 Challenge: Audio-Visual Speaker Separation and Recognition

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-05-20T00:00:00Z

本研究提出了一种新模型,结合卷积层和Transformer块,从表面肌电图信号中预测发音特征,相关性达到约0.9,并首次成功将预测特征解码为可理解的语音波形。

Prediction of Articulatory Features from Surface Electromyography in Speech Production

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-05-20T00:00:00Z

本研究提出ClapFM-EVC框架,旨在解决高保真情感语音转换中的灵活性和可解释性问题。该框架通过自然语言提示或参考语音生成高质量的转换语音,并能够调节情感强度,研究结果验证了其有效性。

ClapFM-EVC: High-Fidelity and Flexible Emotional Voice Conversion with Dual Control from Natural Language and Speech

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-05-20T00:00:00Z

本研究针对语音LLM在上下文推理和副语言理解方面的不足,提出了一种新框架,通过实际语音数据生成问答数据集。研究结果显示,语音LLM在同理推理任务中的局限性,强调了对相关数据集和更强模型的需求。

Creation of Contextual Paralinguistic Data for Multi-Modal Speech LLM: Data Condensation and Spoken QA Generation

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-05-19T00:00:00Z

本研究提出了一种基于最佳运输的图匹配方法(GM-OT),旨在解决从预训练语言模型向声学特征学习转移语言知识时的对齐挑战。该方法通过将语言和声学序列建模为结构化图,提升了知识迁移效率,显著提高了自动语音识别模型的性能。

Cross-modal Knowledge Transfer Learning for Automatic Speech Recognition Based on Optimal Transport Graph Matching

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-05-19T00:00:00Z

本研究探讨了语音基础模型在听障人士语音可懂性预测中的不足,分析了编码层选择和预测头架构等因素,强调了单一编码层和时域建模的重要性,并发现多个模型集成显著提升了性能,为提高听障人群的语音可懂性提供了实用见解。

Revealing Best Practices for Predicting Speech Intelligibility in Hearing-Impaired Individuals Using Speech Foundation Models

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-05-13T00:00:00Z

本研究提出AlignDiT模型,解决多模态语音生成问题,能够从文本、视频和音频合成高质量语音,提高可懂性和同步性。

AlignDiT: A Multimodal Alignment Diffusion Transformer for Synchronous Speech Generation

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-04-29T00:00:00Z

本研究提出了一种新的听觉感知导向的MOS预测模型(APG-MOS),旨在改善自动语音质量评估中的主观感知模型不足。该模型结合生物听觉机制与语义分析,提高了与人类判断的一致性,实验结果表明其优于现有模型。

Auditory Perception-Based MOS Prediction Model for Synthetic Speech (APG-MOS)

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-04-29T00:00:00Z

本文探讨了主动脑机接口中的静默语言解码,提出了一种新型预训练范式,有效提升了静默语言的解码能力。实验结果表明,该模型在语义和单词分类任务中表现优异,推动了相关研究的发展。

Pre-trained Large Brain Language Model for Active Brain-Computer Interfaces: Silent Speech

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-04-29T00:00:00Z

本研究评估了GPT-4o、Llama 3和Mistral在反制阴谋论中的有效性,发现这些模型生成的反驳内容往往普通且重复,并存在承认恐惧和幻觉事实的问题,揭示了AI生成内容的局限性。

Debunking Conspiracy Theories Through Dialogue? Exploring AI-Generated Counter-Speech to Challenge Conspiracy Theories

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-04-23T00:00:00Z
  • <<
  • <
  • 1 (current)
  • 2
  • 3
  • >
  • >>
👤 个人中心
在公众号发送验证码完成验证
登录验证
在本设备完成一次验证即可继续使用

完成下面两步后,将自动完成登录并继续当前操作。

1 关注公众号
小红花技术领袖公众号二维码
小红花技术领袖
如果当前 App 无法识别二维码,请在微信搜索并关注该公众号
2 发送验证码
在公众号对话中发送下面 4 位验证码
小红花技术领袖俱乐部
小红花·文摘:汇聚分发优质内容
小红花技术领袖俱乐部
Copyright © 2021-
粤ICP备2022094092号-1
公众号 小红花技术领袖俱乐部公众号二维码
视频号 小红花技术领袖俱乐部视频号二维码