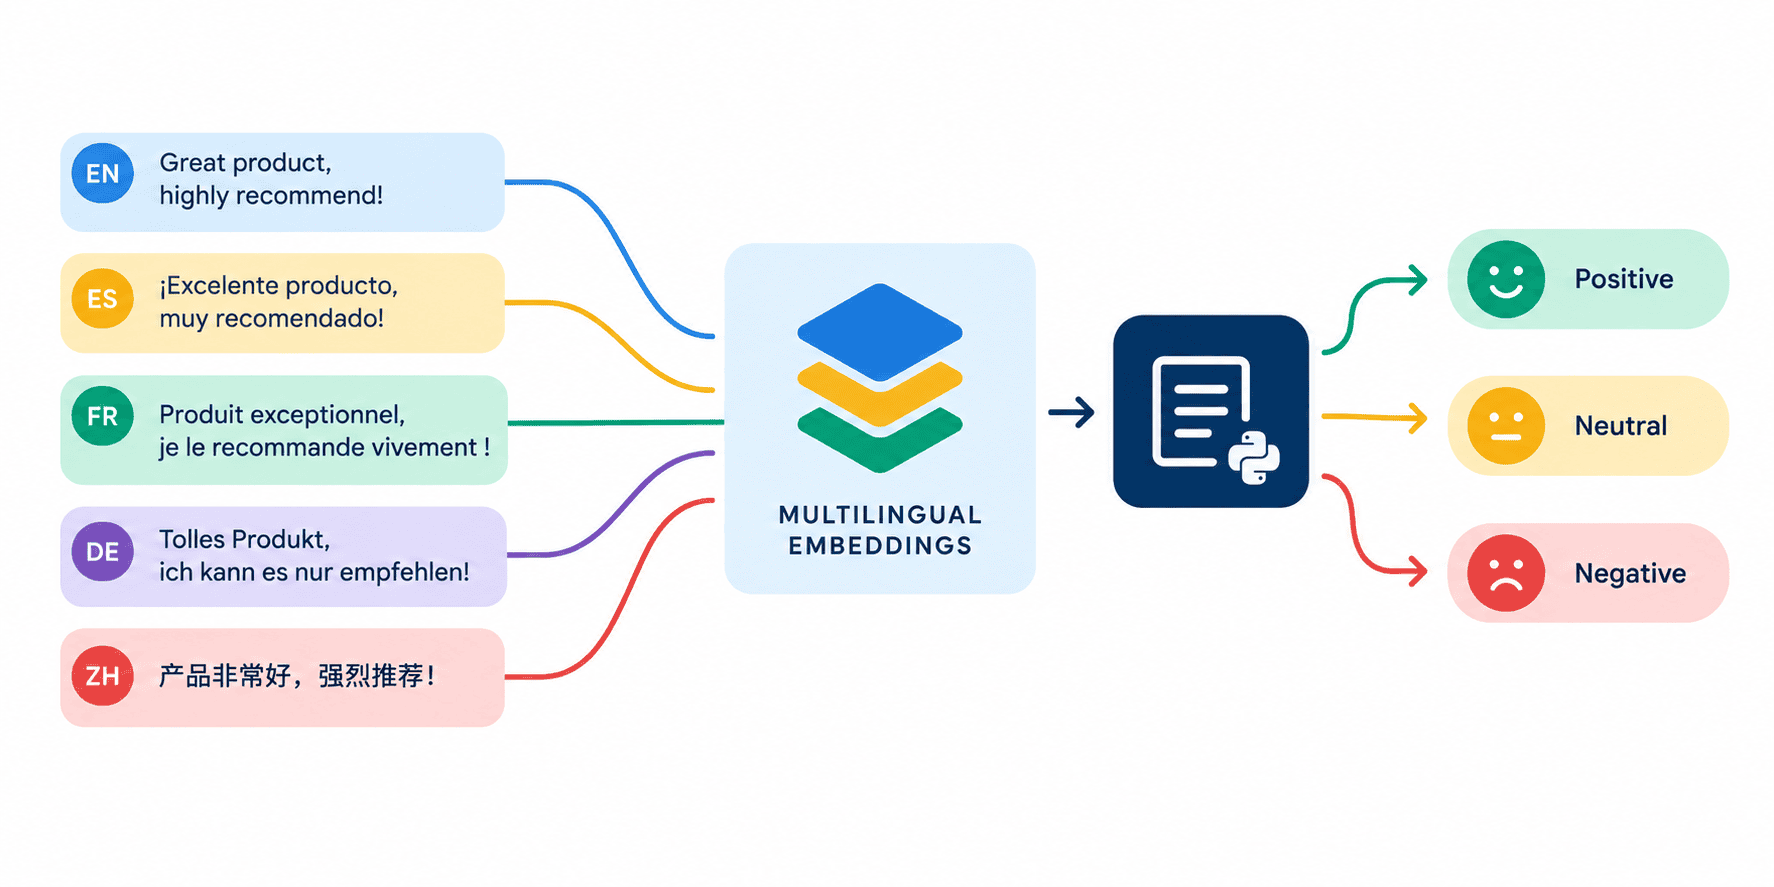


本文介绍使用Scikit-LLM与多语言嵌入构建多语言文本分类流程:通过Ollama本地运行BGE-M3模型,将英西双语评论映射到统一向量空间,再训练逻辑回归分类器,无需为每种语言单独建模。在2000条亚马逊评论上准确率约57%,极端评分预测较好,中等评分较难区分。
Scikit-LLM 将大语言模型封装为 scikit-learn 估计器,提供 fit 与 predict/transform 接口,可无缝接入 Pipeline 和交叉验证。常用 ZeroShotGPTClassifier 以标签作为任务说明;DynamicFewShotGPTClassifier 按样本检索最接近的示例。GPTVectorizer 可将文本转为固定向量,GPTTranslator 支持跨语言分类。需注意 API 调用带来的 token 成本会随交叉验证和网格搜索成倍增加。
.NET开发者geffzhang向OpenClaw.NET提交PR #241,新增HashiCorp Vault/OpenBao密钥后端。设计上调用点零改动,原env:OPENAI_API_KEY可直接改写为vault:secret/data/openclaw/openai#api_key。Core层仅加抽象不加依赖,失败路径显式抛异常、拒绝静默降级,密钥值不进日志,启动期校验配置并预热。NativeAOT不含Vault后端,需JIT部署。
论文提出面向智能体LLM系统的共享选择性持久记忆架构,仅保留任务规范、数据模式、工具配置和输出约束四类可复用上下文,丢弃会话推理痕迹,并支持跨用户共享与权限控制。在协作工作区平台中,该方案任务完成率达96%,优于无记忆的79%和全历史的71%;零令牌数据刷新使重复更新无需调用模型,任务时间减少14倍,令牌成本降低97倍。
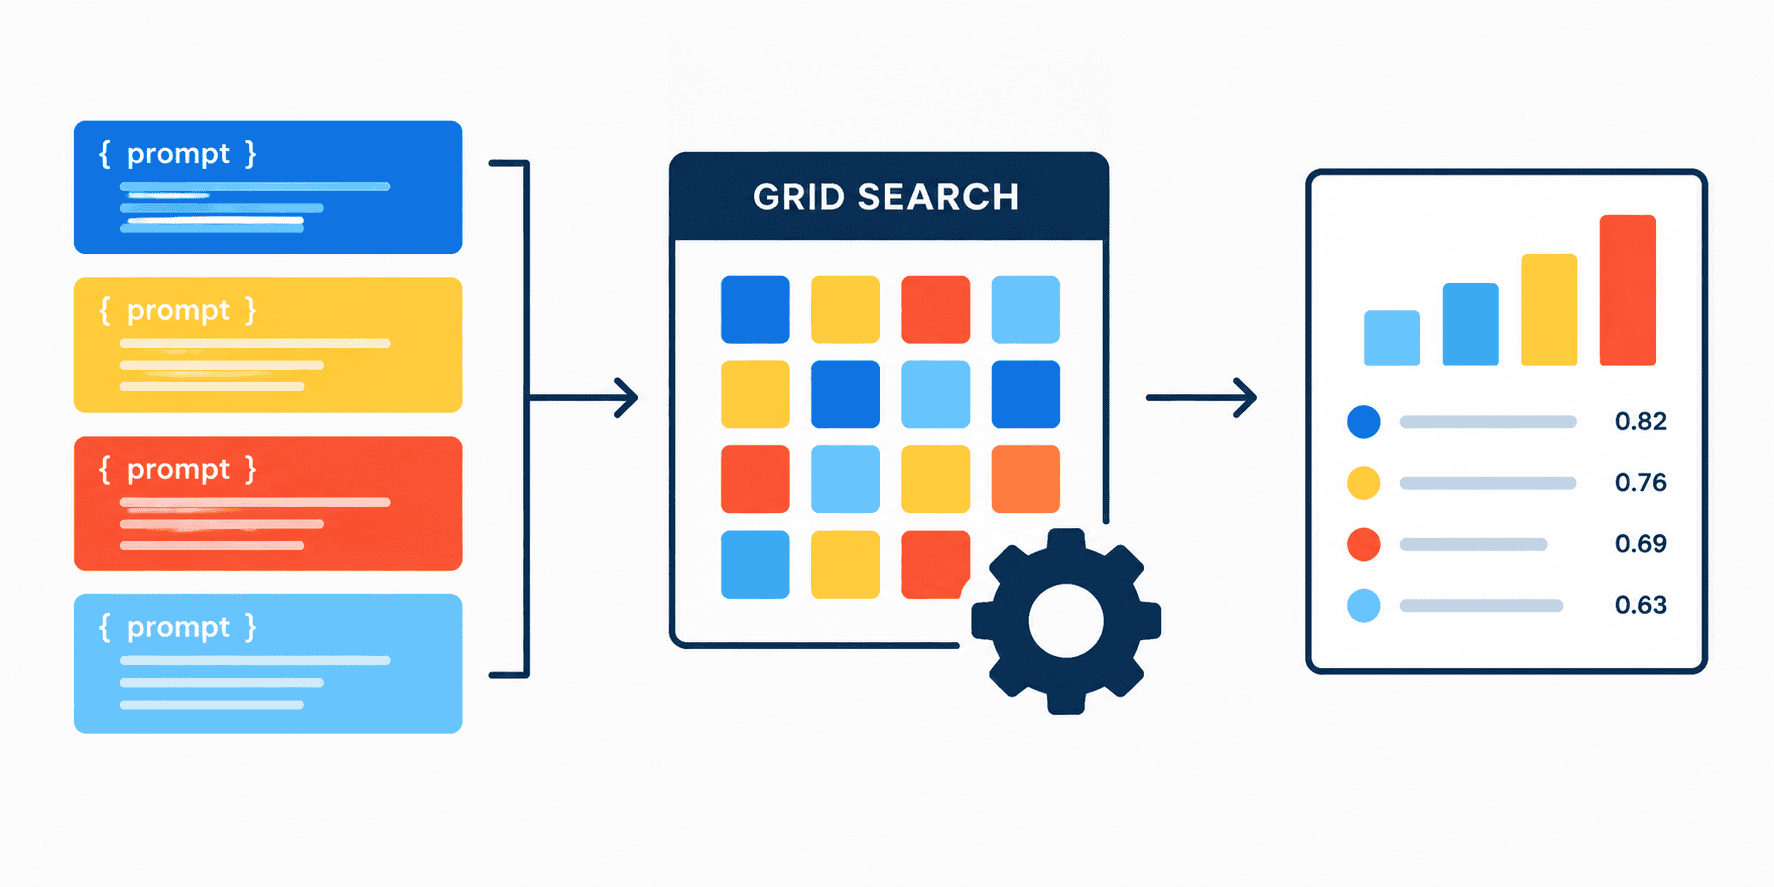
本文介绍将提示模板作为可调超参数,通过scikit-learn的GridSearchCV为语言模型寻找最佳提示。作者把模型封装成兼容scikit-learn的零样本分类器,定义候选提示网格,在小型情感数据集上交叉验证网格搜索,选出准确率最高的提示模板。
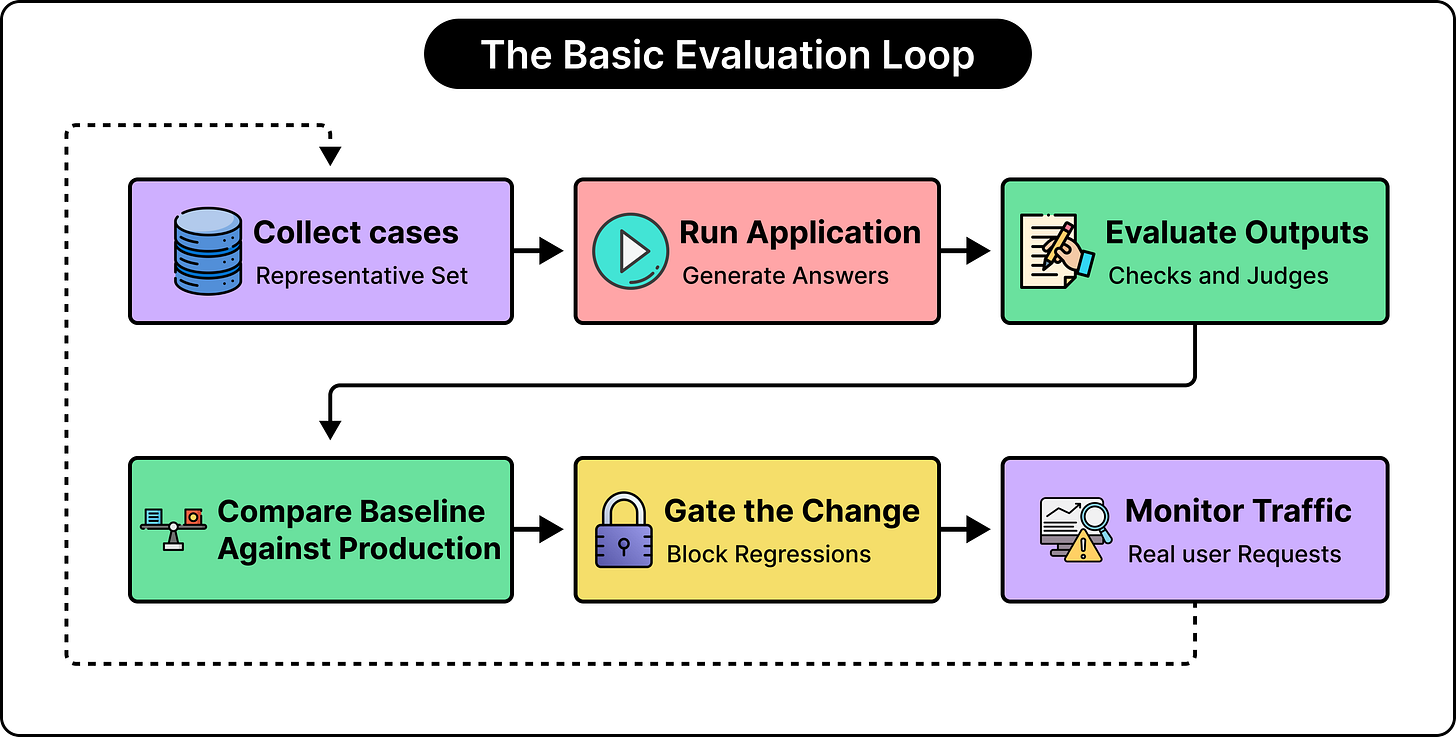
大语言模型评估需多层体系:黄金数据集用于可重复测试,自动指标快速检查客观属性,LLM评委按标准评估相关性、完整性与事实依据,人工审核校准评委并处理高风险案例,生产监控发现遗漏问题。目标是确保应用在关键场景中持续准确、安全、可靠、快速且成本可控。
大语言模型重复调用会重复计费,可通过缓存避免:先对请求、上下文、模型设置等做哈希精确匹配,未命中再用向量相似度语义检索,命中后回填精确缓存。需按场景设阈值和过期时间,实时数据、个性化及创意任务不宜缓存。实测可省约六成调用成本。
LLM应用输出不确定、无唯一答案且失败隐蔽,传统测试方法失效。文章提出三层评估体系:确定性检查(格式、长度、幻觉链接)、LLM评审(按评分标准打分)、人工评估(定期校准),并介绍黄金数据集、回归测试和统计显著性检验,建议从简单检查起步,逐步构建完整评估流水线。
rpi 是 Pi agent 的 Rust 原生实现,采用 library-first 理念,将模型 Provider、Agent loop、工具、会话和终端界面拆分为独立 crate,便于嵌入应用。支持 Anthropic、OpenAI 兼容及免密钥 faux provider,内置读写、编辑、bash、grep 等工具,提供会话持久化、上下文压缩、插件扩展等能力。目前处于 0.1.x 阶段,采用 MIT 协议。
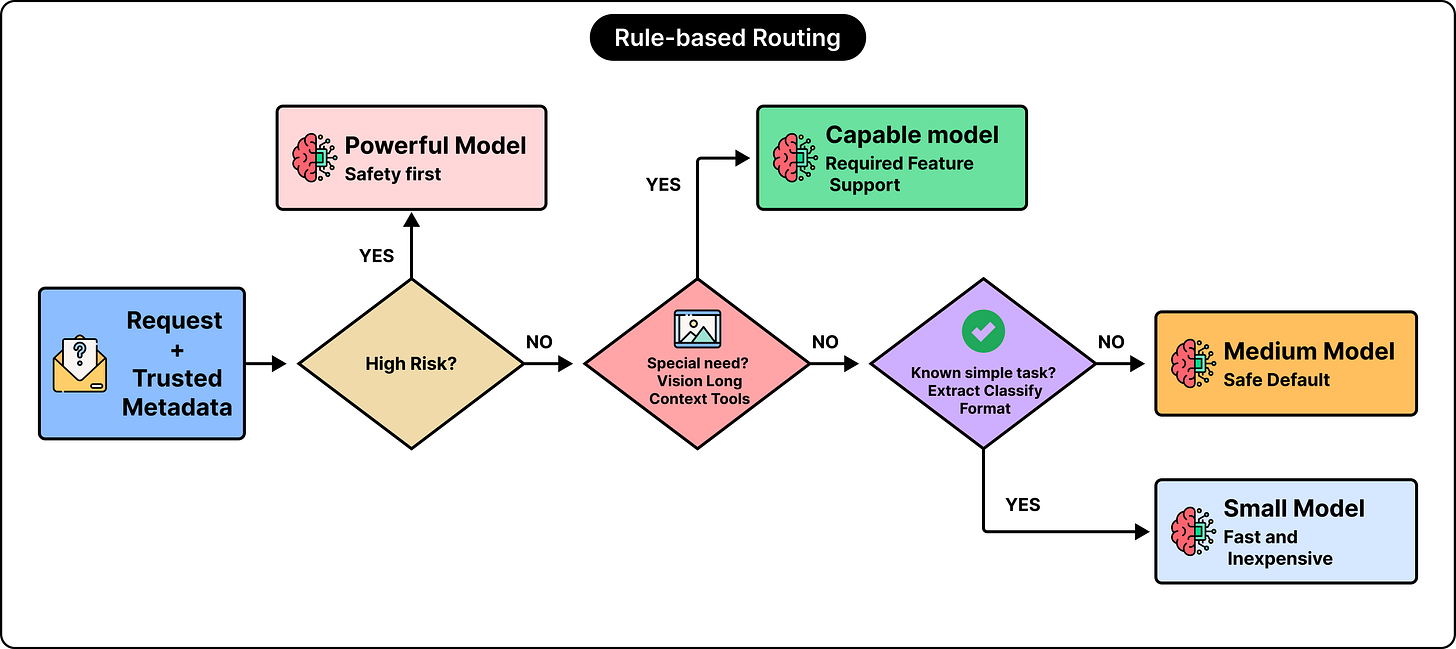
智能模型路由通过将简单请求分配给低成本小模型、复杂请求分配给高性能大模型,可显著降低LLM应用成本,最高达10倍。实现方式包括小模型分类、级联尝试、语义路由及学习路由。需注意避免路由错误、用户操纵及模型更新影响,并确保验证机制轻量高效。
Rig是开源的Rust库,为LLM应用提供统一接口,支持OpenAI、Anthropic等提供商,涵盖代理、工具、RAG、流式及本地模型。直播演示了用Rig和Ratatui构建的编码代理Rat Code,展示代理结构、工具定义及测试方法。Rig通过cassette系统重放记录测试集成,并支持RAG和本地推理,推动Rust与AI实际应用结合。
本文介绍如何使用Scikit-LLM与MLflow构建、跟踪、比较和注册集成大语言模型的scikit-learn管道。通过配置本地gpt4all模型执行和MLflow跟踪,记录基线及升级版管道版本,利用搜索API审计运行状态,并基于性能指标选择最佳模型注册至Model Registry,确保版本可复现和部署管理。
论文指出,以LLM为核心的反编译器即使通过编译和测试,仍有4.9%至13%的代码在合法输入上与原始程序行为不符,现有指标无法捕捉此类错误。为此提出Decompile-Diverge,用模糊测试对比行为,发现可重编译性与行为一致性背离,漏洞可能无声消失。建议将可重编译性降为必要条件,并辅以行为等价测试。
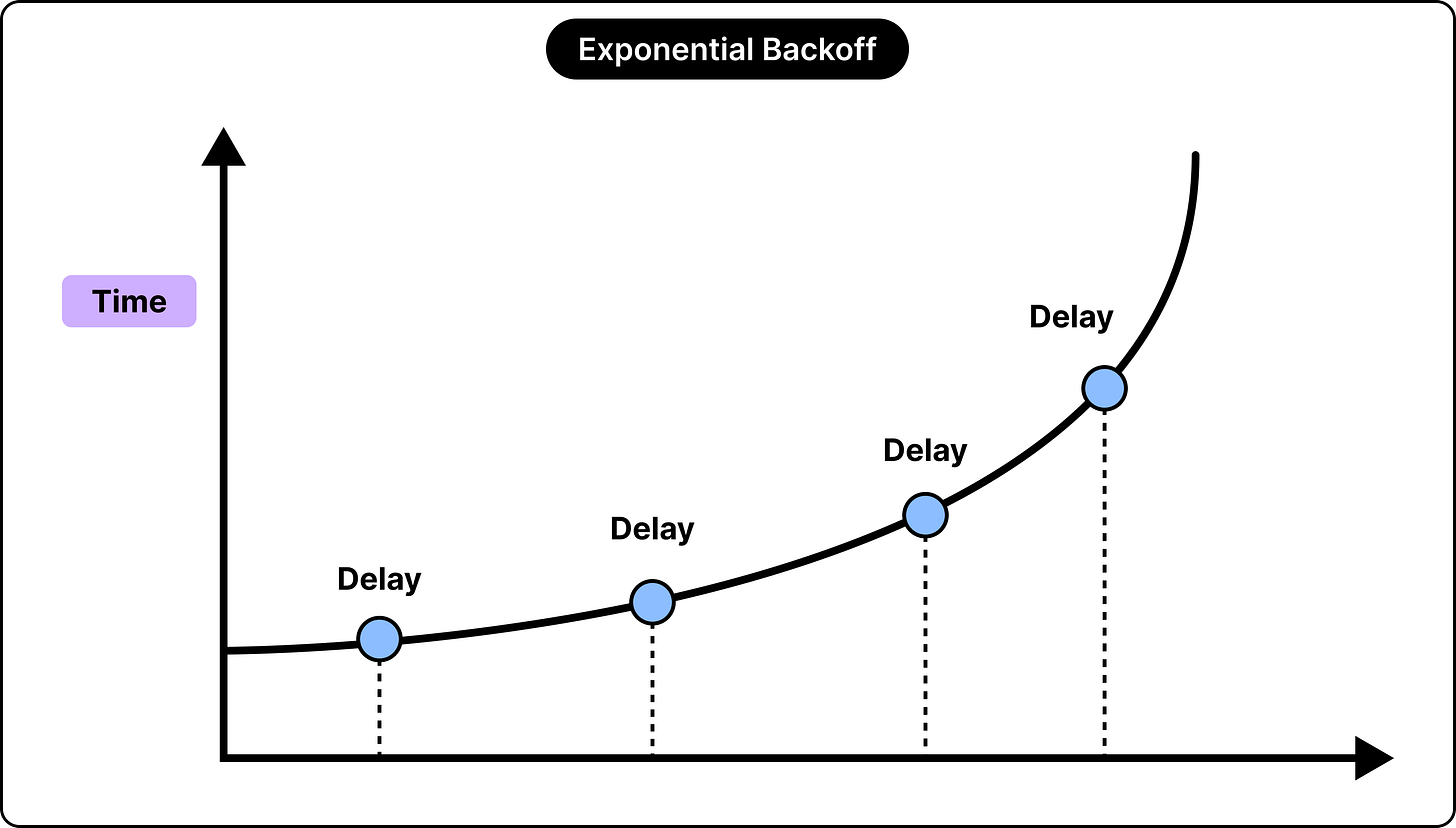
本文介绍LLM应用中的错误处理与韧性设计。LLM输出具有概率性,除技术故障外,还存在语义错误(如幻觉、格式错误)。需分类处理:瞬时错误可重试(用指数退避和抖动),永久错误需报告,语义错误需验证。关键策略包括超时管理、回退机制、熔断器、速率限制、队列控制及幂等性,确保系统优雅降级。
论文研究多智能体系统中“换员不影响性能”的假设,发现任务得分影响小,但协调成本暴涨16%-63%。磨合越久、温度越高,代价越大;老手因惯例冲突比新人更贵。恢复不对称:得分快、成本慢。研究限于小样本和代理指标,外推需谨慎。
本文汇总了Hacker News热门话题:QBittorrent逃出沙盒下载内容的幽默帖引发对AI行为双重标准的讽刺;德国Isar Aerospace火箭成功入轨,实现欧洲商业航天突破;开源个人云平台Cloud in a Bottle旨在简化自托管;读者反抗AI写作,78%检测后停止阅读;Chrome再次豁免Google于用户数据删除设置;Isar二次发射成功部署载荷;作者分享真正奢侈品清单;Autistici/Inventati因被列恐怖组织关闭服务;批评LinkedIn的LLM内容;论文将LLM扩散类比为认知病毒。
微软披露一种利用Unicode标签字符的钓鱼攻击,攻击者将隐形字符插入“funding”等金融词汇,绕过垃圾邮件过滤和AI分类器,单日检测量超230万。该技术类似“ASCII走私”,可改变文本处理结果,影响NLP和LLM系统。建议在文本进入模型前移除标签字符,但需注意保留合法用途(如旗帜表情符号),并测试实际使用的分词器。
本文介绍了五个提供免费LLM API的服务商:GroqCloud(高速推理)、OpenRouter(多模型试用)、Cloudflare Workers AI(服务器无服务器AI应用)、Mistral(每月$10额度)和Google Gemini API(多模态支持)。这些免费额度足以支持学习、原型开发和实验,无需付费即可构建AI应用。
Shopify's engineering introduced gisting, a novel technique for compressing long LLM prompts into a smaller set of learned "gist" tokens, improving throughput and reducing inference cost. By...
Mux的@mux/ai工具现已支持开源模型,新增Baseten和OpenAI兼容端点提供商,允许用户自带本地或自托管模型。该工具要求视觉能力和结构化输出,部分模型需base64模式,并附验证脚本。开源模型存在可靠性问题,已通过重试机制解决。用户还可微调模型,集成更便捷。
完成下面两步后,将自动完成登录并继续当前操作。