


宣布液体聚类正式发布
内容提要
数据智能平台Databricks推出Delta Lake液体聚类正式版,取代了表分区和ZORDER,提供最佳查询性能。液体聚类简化了数据布局决策,允许随分析需求演变。已有数百个客户认可,提高读取性能2-12倍。突破性技术,提供更好的写入和读取性能。可在Delta Lake中使用。
延伸解读
液体聚类如何解决传统数据布局的痛点
传统方法依赖Hive分区和ZORDER,但分区列选择复杂,错误选择会导致文件过大或过小,影响读取性能;ZORDER写入成本高且非增量,导致聚类作业时间长、计算成本高。液体聚类自动调整数据布局,无需手动调优,解决了这些挑战,提供更好的读写性能。
液体聚类的核心优势:简单与灵活
液体聚类简化了数据布局决策,聚类键可基于查询模式选择,无需考虑基数、键顺序、文件大小等因素。聚类键可随分析需求重新定义而无需重写数据,实现了数据布局的灵活演进。使用简单,只需定义聚类列即可。
性能提升与客户验证
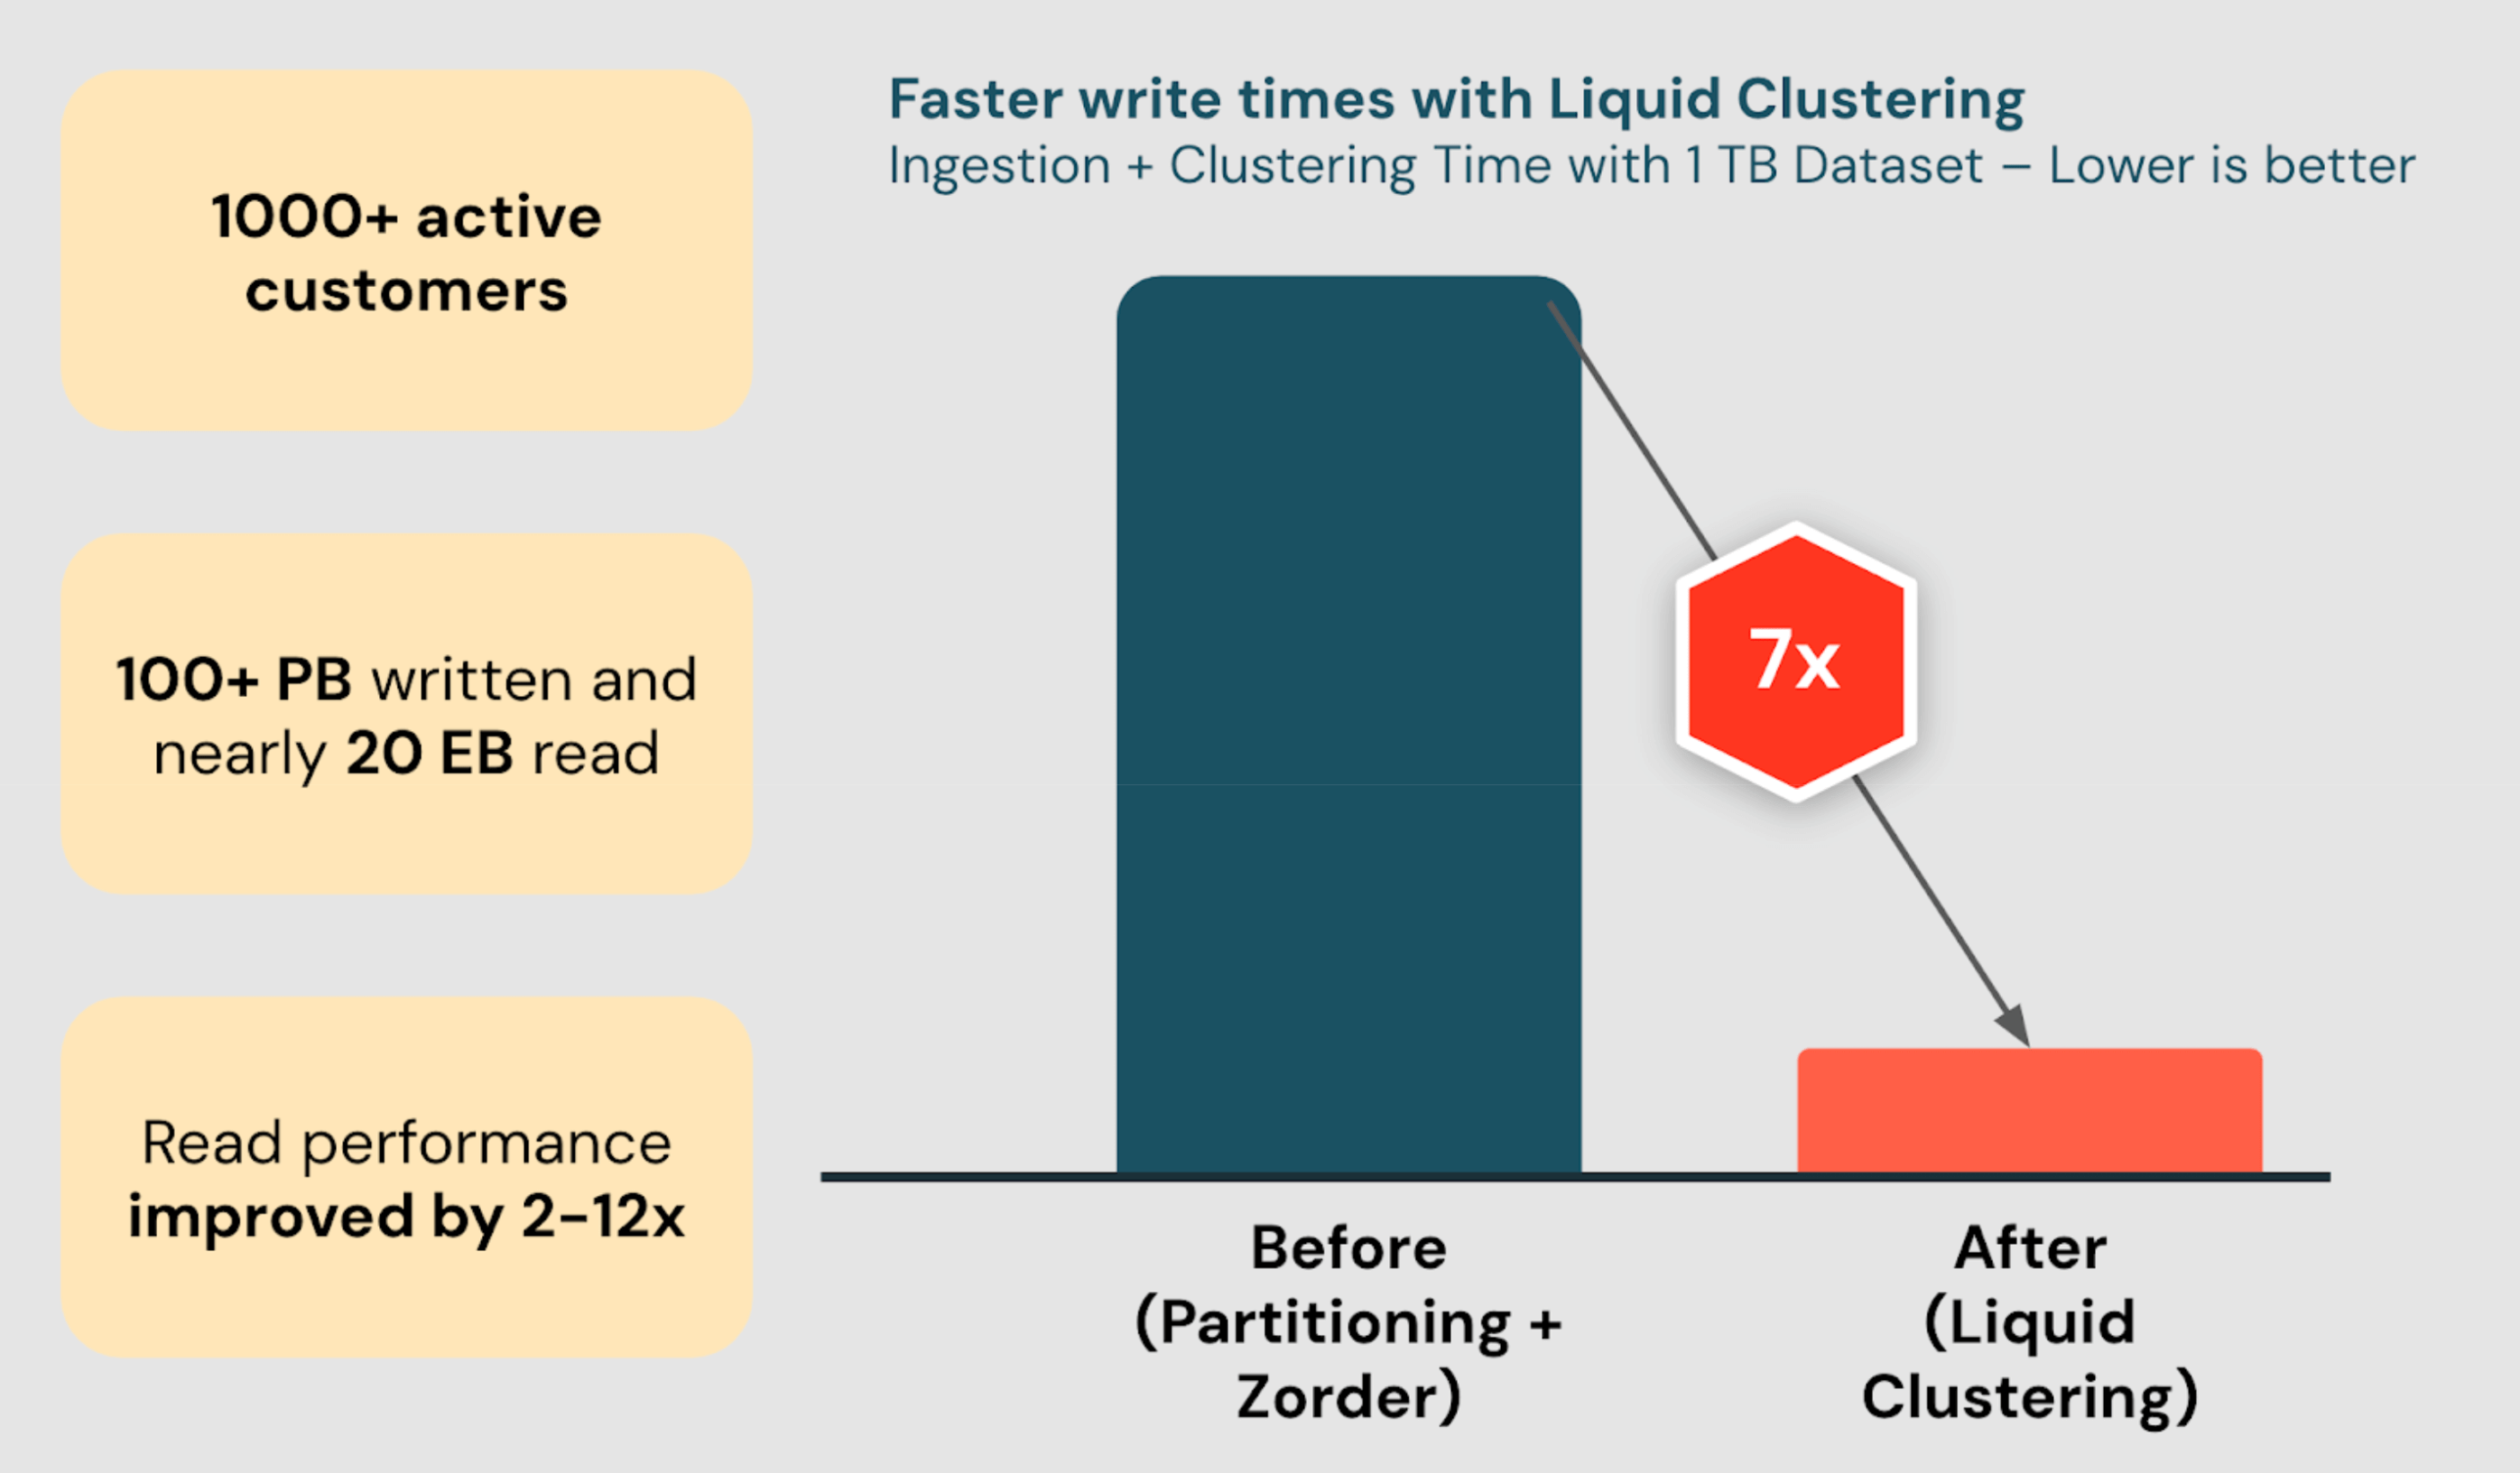
已有数百客户使用液体聚类,读取性能提升2-12倍。内部基准测试显示,写入速度比分区加ZORDER快7倍。客户案例中,制造企业点查询提速12倍,Shell时间序列查询提升10倍。这些数据表明液体聚类在实际场景中能显著提升性能。
并发支持与可用性
DatabricksIQ提供记录级并发支持,客户无需依赖分区来实现并发,避免了并发写入的冲突。液体聚类在DBR 15.2中正式可用,用户可快速启用。对于非Databricks环境,可参考delta.io文档使用。
Q&A
液体聚类的主要功能是什么?
液体聚类简化了数据布局决策,提供最佳查询性能,允许根据分析需求演变重新定义聚类键,无需数据重写。
液体聚类如何提高查询性能?
液体聚类通过自动调整数据布局,提供更好的写入和读取性能,客户的读取性能提高了2-12倍。
与传统的分区和ZORDER方法相比,液体聚类有哪些优势?
液体聚类提供更高的灵活性和简化的管理,避免了复杂的分区策略和高写入成本,且支持增量处理。
如何在Delta Lake中启用液体聚类?
用户可以在DBR 15.2中快速启用液体聚类,只需定义聚类列即可。
液体聚类对数据写入有什么影响?
液体聚类提供快速写入,优化数据布局,降低写入成本,写入速度比传统方法快7倍。
客户对液体聚类的反馈如何?
许多客户赞扬液体聚类的简单性和灵活性,认为它显著提高了查询性能和数据处理效率。
