

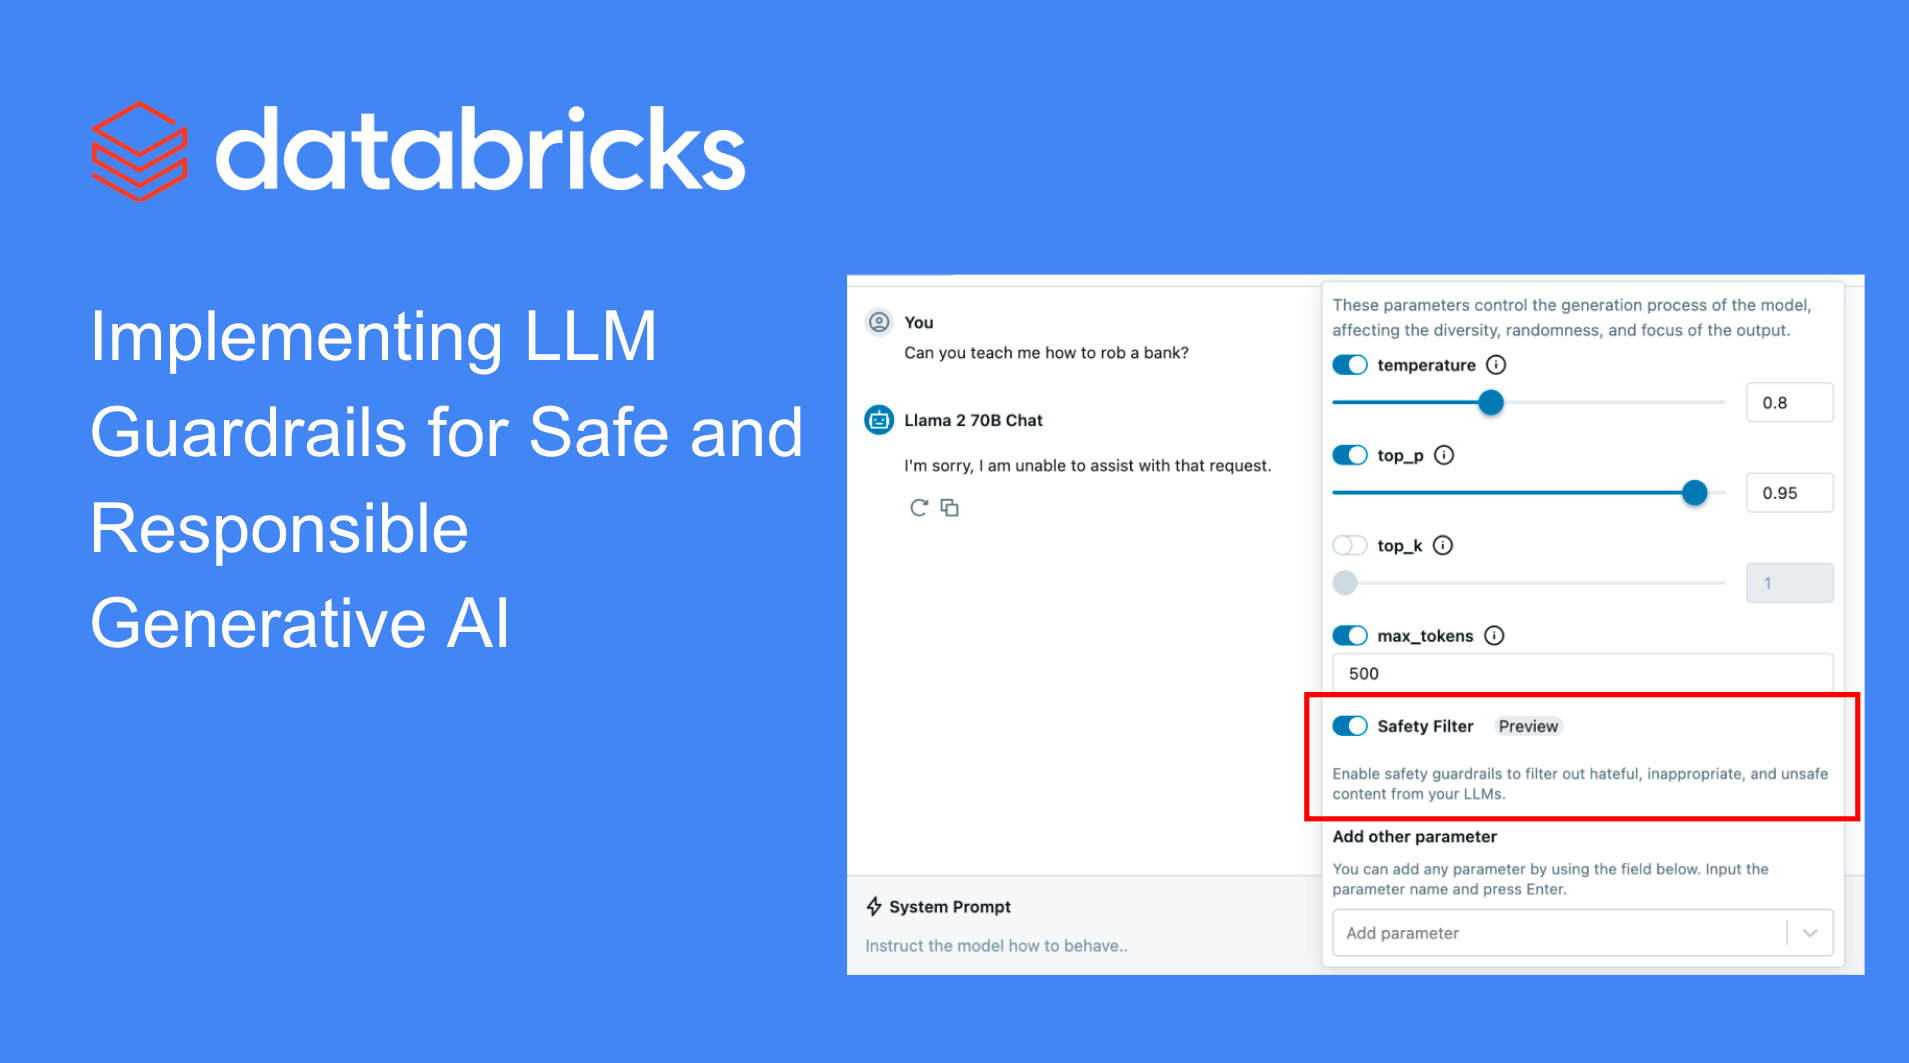

在Databricks上实施LLM护栏以安全和负责任地部署生成式AI
内容提要
Databricks推出了Guardrails功能,支持使用开源LLMs构建的聊天机器人,确保适当的行为。通过Model Serving Foundation Model APIs (FMAPI)的私有预览,用户可以防止有害或不安全的内容。提供了Inference Tables和Lakehouse Monitoring来记录模型请求和响应,并监控模型性能。Guardrails帮助团队更快地投入生产,并防止模型与不安全的内容交互。可以使用Databricks Feature Serving定义自定义的Guardrails。Inference Tables和Lakehouse Monitoring允许跟踪和可视化模型的性能和安全性。Databricks提供了一个统一的平台,用于构建和普及负责任的人工智能。
延伸解读
安全过滤器的启用方式与覆盖范围
在Databricks的Foundation Model APIs中,用户只需在请求中设置enable_safety_filter=True,即可启用安全过滤器。该过滤器能检测并过滤六大类不安全内容:暴力与仇恨、性内容、犯罪策划、枪支与非法武器、受管制或受控物质、自杀与自残。这为使用开源LLM的聊天机器人提供了开箱即用的基础防护,但仅覆盖预设类别,其他风险需自定义。
自定义护栏的实现路径
对于预设类别之外的过滤需求,Databricks提供了两种自定义方式:一是使用Feature Serving部署自定义函数(如正则表达式或PII检测),作为端点集成到应用中;二是从Databricks Marketplace托管Llama Guard到FMAPI Provisioned Throughput端点。这允许团队根据自身合规要求灵活扩展护栏,但需要一定的工程投入。
审计与监控的闭环价值
Inference Tables自动记录所有请求和响应到Delta表,便于检查、调试过滤器,或用于构建自定义过滤器(如少样本学习或微调)。Lakehouse Monitoring则通过添加标签列和指标(如毒性),自动计算性能与漂移指标,并生成可视化仪表板。两者结合形成从防护到监控的闭环,帮助团队持续评估模型安全性。
统一平台对负责任AI的意义
Databricks将护栏、推理日志和监控整合在单一平台,减少了集成 disparate 工具的复杂度。这使团队能更快地将生成式AI应用投入生产,同时降低模型与不安全内容交互的风险。该功能目前处于私有预览阶段,未来还会有更多产品更新,适合早期采用者评估。
Q&A
Databricks的Guardrails功能有什么作用?
Guardrails功能帮助确保使用开源LLMs构建的聊天机器人遵循适当的行为,防止与不安全内容的交互。
如何使用Databricks的安全过滤器?
通过在请求中设置enable_safety_filter=True,可以启用安全过滤器,自动检测并过滤掉有害内容。
Inference Tables和Lakehouse Monitoring的功能是什么?
Inference Tables记录模型请求和响应,Lakehouse Monitoring监控模型性能和安全性,二者结合提供全面的模型审计和监控。
如何定义自定义的Guardrails?
可以使用Databricks Feature Serving定义自定义的Guardrails,通过包装正则表达式或函数并将其部署为端点来实现。
Guardrails如何帮助团队加快生产进程?
Guardrails通过防止模型与不安全内容交互,使团队能够更快地将AI应用投入生产,减少对模型响应的担忧。
Databricks如何支持负责任的人工智能?
Databricks提供统一的平台,结合Guardrails、Inference Tables和Lakehouse Monitoring,帮助团队构建和普及负责任的人工智能。
